ML บน Production — อะไรเปลี่ยนไปหลัง Deploy
ชีวิตหลัง Deploy — ข้อสอบที่ไม่มีวันจบ, overfitting vs leakage, data/concept drift, model decay และการเลือก metric ให้ตรงกับเงิน
พาร์ตที่แล้วปูเครื่องมือให้พร้อมและทบทวนพื้นฐาน ML ที่สำคัญต่อ Production — สามชุดข้อมูล, baseline และคำสามคำที่เป็นบั๊กเงียบ ได้แก่ Model Artifact, Feature Schema และ Preprocessor
พาร์ตนี้จะหันมาดูสิ่งที่ เปลี่ยนไปจริง ๆ เมื่อโมเดลออกจาก Notebook แล้วเริ่มให้บริการผู้ใช้จริง
เตรียมความพร้อม#
ทุกตัวอย่างด้านล่างรันใน Jupyter notebook ภายใน โฟลเดอร์ ml-refresher เดิม จากพาร์ตที่แล้ว ถ้าคุณตั้งค่าสภาพแวดล้อมนั้นไว้แล้วใน พาร์ต 2 — ML Refresher ก็ข้ามส่วนที่เหลือของหัวข้อนี้ไปได้เลย แค่ activate ขึ้นมาใหม่แล้วอ่านต่อ
ก่อนอื่นตรวจสอบให้แน่ใจว่าติดตั้ง Python 3 แล้ว ดาวน์โหลดเวอร์ชันล่าสุดได้ที่ python.org/downloads ↗ — บน Windows ให้ติ๊ก “Add python.exe to PATH” ระหว่างติดตั้ง; บน Linux (Ubuntu) รัน sudo apt update && sudo apt install python3 แล้วตรวจสอบด้วย:
python --version # บน Linux ใช้ python3; บน Windows ถ้า python ไม่ได้ให้ลอง py --versionจากนั้น activate สภาพแวดล้อมเดิม (หรือสร้างใหม่ตามด้านล่าง):
Windows (PowerShell):
cd ml-refresher
.venv\Scripts\activatemacOS / Linux:
cd ml-refresher
source .venv/bin/activateเริ่มจากศูนย์? สร้างสภาพแวดล้อมและติดตั้งทุกอย่างในครั้งเดียว (บน Linux ใช้ python3):
mkdir ml-refresher
cd ml-refresher
python -m venv .venv        # แล้ว activate ด้วยคำสั่งด้านบน
pip install notebook pandas numpy scikit-learn matplotlib joblibจากนั้นเปิด notebook แล้วก็พร้อมลุย:
jupyter notebook1. อะไรเปลี่ยนไปเมื่อโมเดลขึ้น Production#
ในห้องเรียน การวัดผลโมเดลค่อนข้างตรงไปตรงมา
แบ่งข้อมูลเป็น Training Set และ Test Set เทรนบนชุดเทรน แล้ววัดกับข้อมูลที่โมเดลไม่เคยเห็น
ลองทำตามด้วยชุดข้อมูลสแปมเล็ก ๆ — สร้างไฟล์ spam.csv ในโฟลเดอร์ notebook (คอลัมน์สุดท้าย spam คือเฉลย: 1 = สแปม, 0 = ไม่สแปม):
length,num_links,num_capital_words,sender_domain_new,spam
257,3,7,1,1
645,0,0,0,0
524,1,1,0,0
280,3,7,1,1
500,0,1,0,0
430,0,0,0,1
231,4,10,1,1
384,1,0,0,0
350,0,1,0,0
179,5,10,1,1
581,0,0,0,0
389,0,1,0,0
217,4,7,1,1
526,0,2,0,0
487,0,2,0,0
205,5,7,1,1
612,0,1,0,0
363,0,1,0,0
298,4,9,1,1
515,0,1,0,0
327,1,1,0,0
183,3,6,1,1
614,0,2,0,0
333,0,1,0,0
294,4,9,1,1
551,1,2,0,0
414,0,0,0,0
293,3,9,1,1
457,1,2,0,0
341,0,1,0,0
212,4,6,1,1
561,1,0,0,0
339,0,2,0,0
191,3,8,1,1
561,1,1,0,0
497,0,2,0,0
281,3,9,1,1
520,0,0,0,0
552,1,1,0,0
218,4,6,1,1
432,0,2,0,0
322,1,1,0,0
195,4,8,1,1
471,1,0,0,0
600,1,0,0,0
197,5,7,1,1
415,1,1,0,0
510,1,1,0,0
233,4,9,1,1
375,1,0,0,0
602,0,1,0,0
201,4,6,1,1
429,0,2,0,0
638,1,2,0,0
288,3,10,1,1
407,0,2,0,0
384,1,2,0,0
242,4,7,1,1
581,0,2,0,0
355,1,1,0,0จากนั้นเทรนและวัดผล — โฟลว์แบบห้องเรียนตั้งแต่ต้นจนจบ:
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("spam.csv")
X = df.drop(columns="spam")   # ฟีเจอร์ที่โมเดลเห็น
y = df["spam"]                # เฉลยที่ต้องเรียนรู้

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = RandomForestClassifier(random_state=42).fit(X_train, y_train)
print(round(model.score(X_test, y_test), 2)) # ตัวเลขเดียวบนข้อมูลที่ไม่เคยเห็น → 0.92สุดท้ายได้ตัวเลขออกมาหนึ่งค่า เช่น:
Accuracy = 92%
ดูง่าย — 92% ถือว่าดี งานเสร็จ
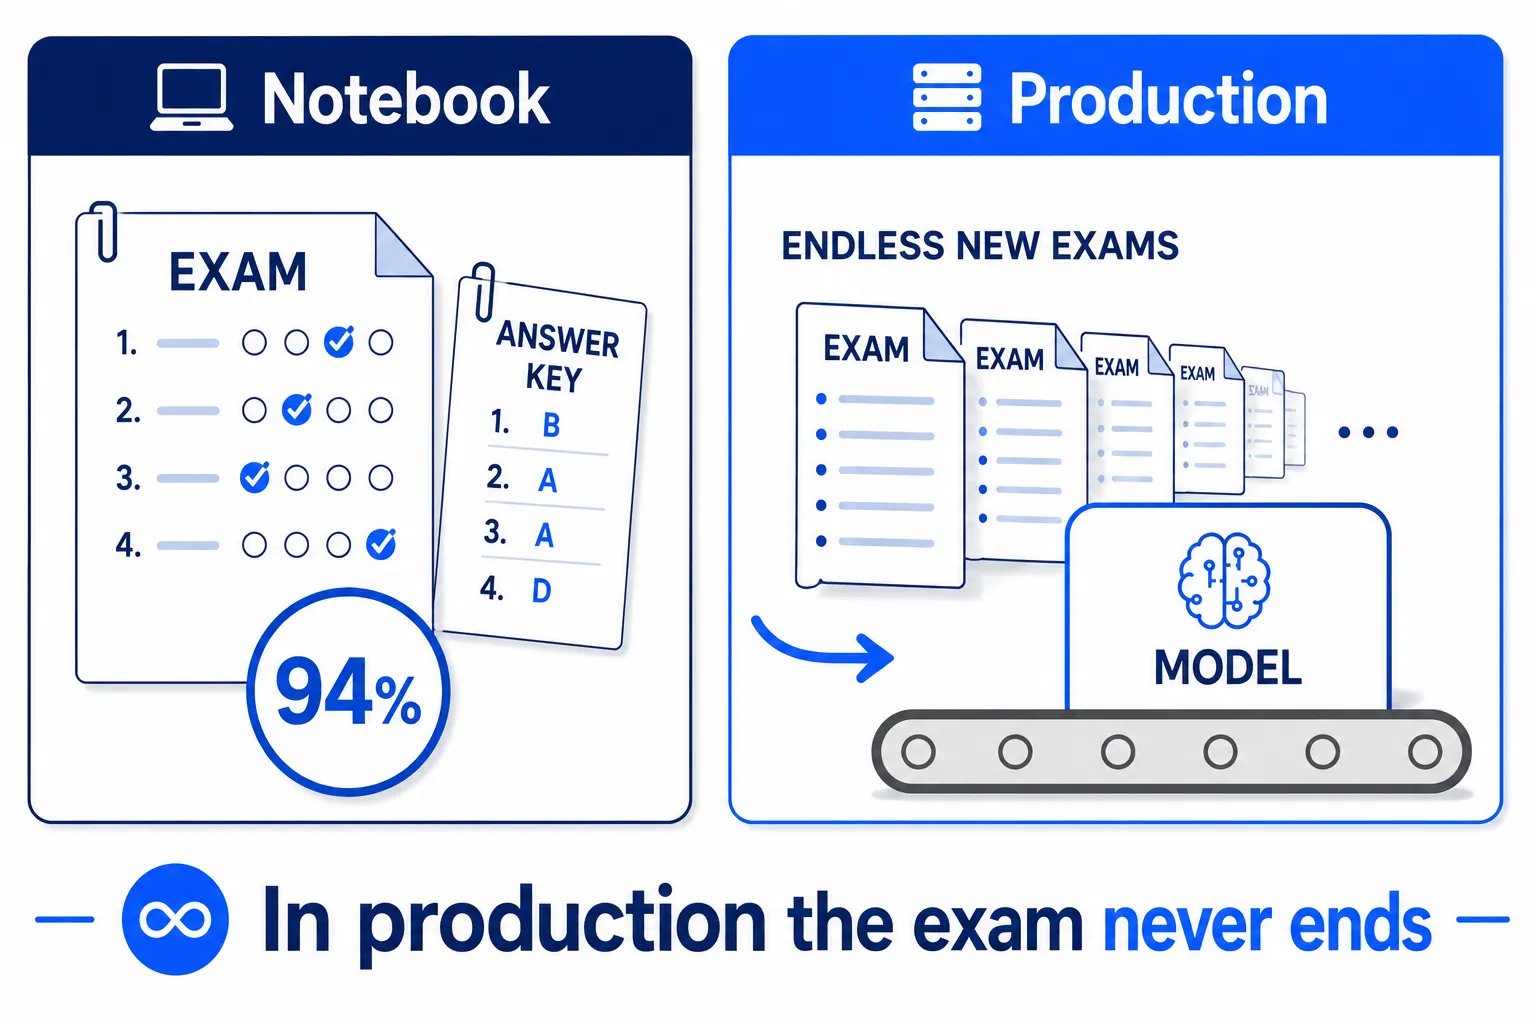
แต่เมื่อโมเดลขึ้น Production ทุกอย่างเปลี่ยนไป เพราะ Test Set ไม่ได้เป็นชุดเดียวอีกต่อไป
ข้อมูลใหม่ไหลเข้าหาโมเดลทุกวันและไม่มีวันหยุด
ทุก request จากผู้ใช้จริงคือข้อสอบข้อใหม่ของโมเดล
มีอย่างน้อยสามอย่างที่ต่างจากในห้องเรียน
1.1 ข้อสอบที่ไม่มีวันจบ#
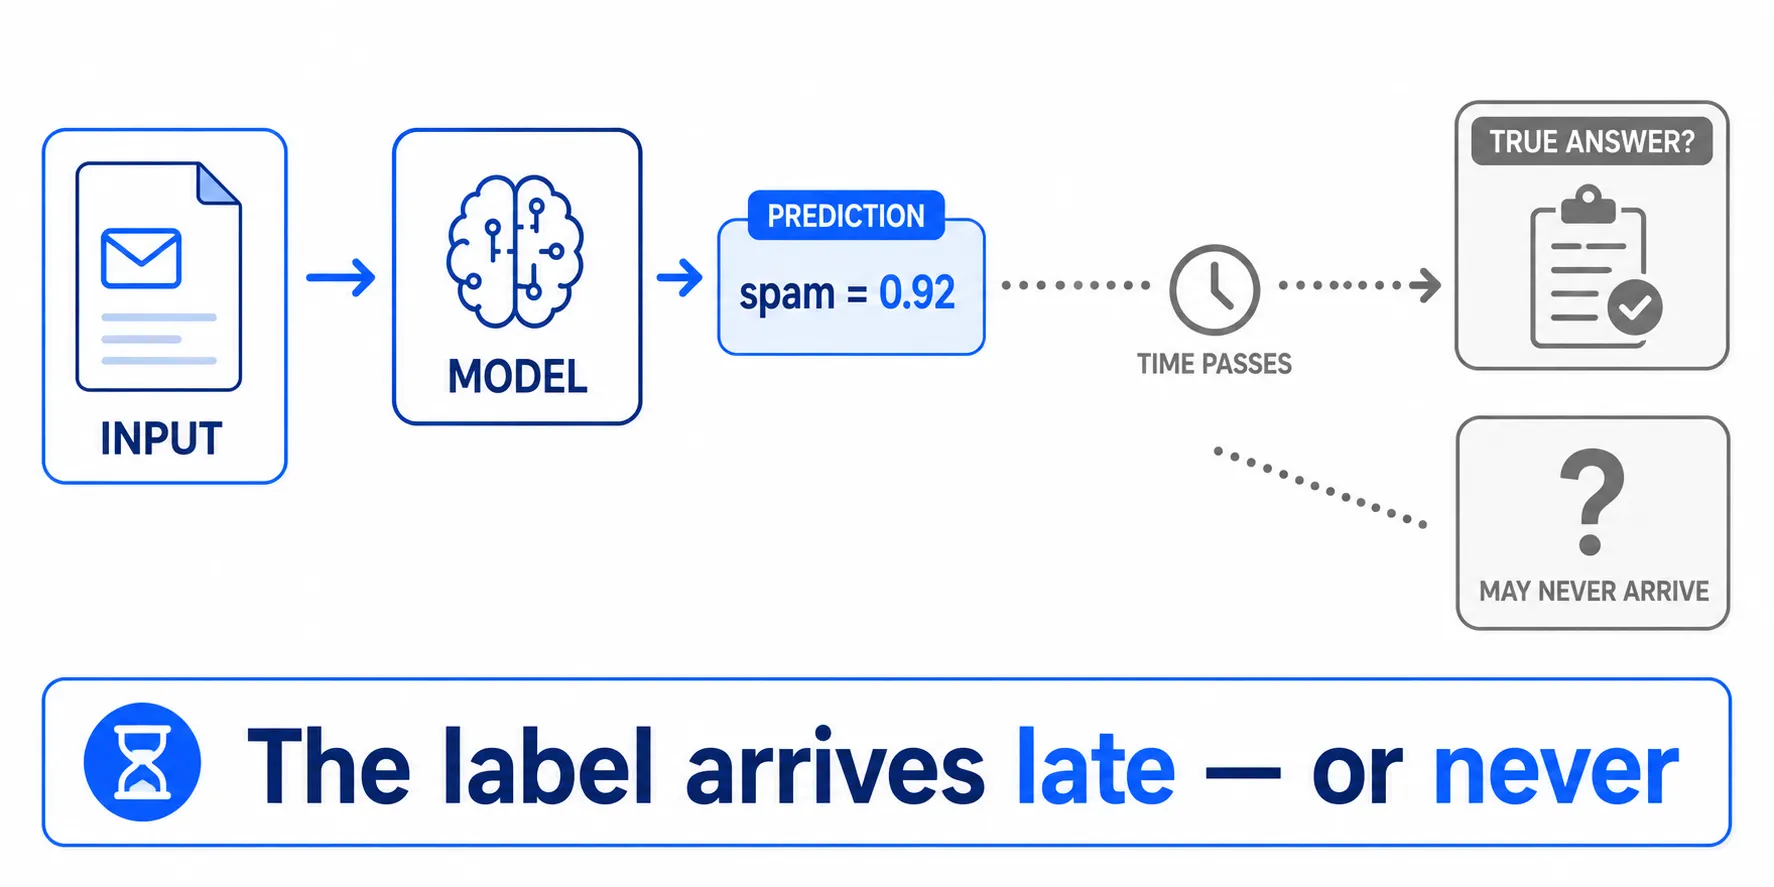
ในห้องเรียนมี X_test — และที่สำคัญคือมี y_test
นั่นแปลว่ามีทั้ง โจทย์และเฉลย อยู่ในมือ
ถ้าโมเดลทำนายว่าอีเมลนี้เป็นสแปม เปิด y_test ก็รู้ทันทีว่าตอบถูกหรือไม่
แต่ใน Production ส่วนใหญ่มีแค่:
Input → Prediction → จบ
สมมติมีอีเมลใหม่เข้ามาแล้วโมเดลตอบว่า:
spam = 0.92
อีเมลนั้นเป็นสแปมจริงหรือไม่อาจยังไม่รู้
เฉลยอาจมาทีหลัง — เช่น ผู้ใช้กด “Not Spam” — หรืออาจไม่มาเลย
การวัดความแม่นยำใน Production จึงยากกว่าใน notebook มาก
ตอนเทรน เฉลยพร้อมอยู่แล้ว ตอน Production เฉลยอาจมาช้า — หรือไม่มาเลย
1.2 ข้อมูลจริงอาจไม่เหมือนข้อมูลตอนเทรน#
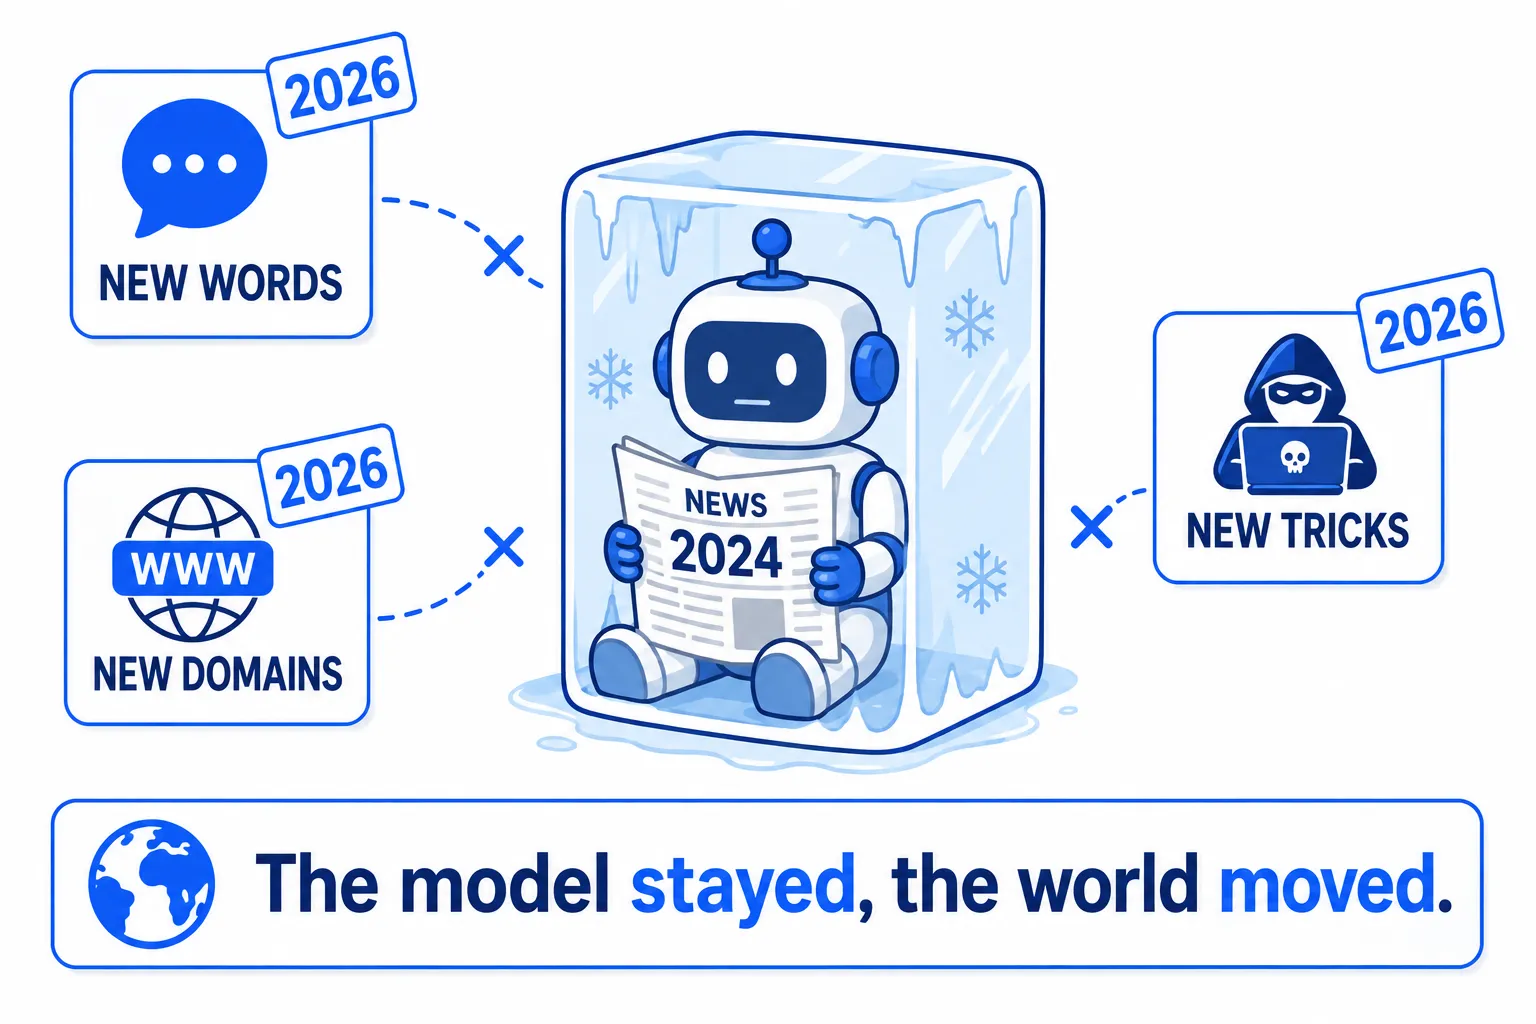
เวลาแบ่งข้อมูลด้วย train_test_split() มีสมมติฐานเงียบ ๆ ว่า Training Set และ Test Set มาจากข้อมูลชุดเดียวกัน
Test Set จึงเป็นตัวอย่างที่ค่อนข้างซื่อสัตย์ของสิ่งที่โมเดลได้เรียนรู้
แต่ Production ไม่มีการรับประกันแบบนั้น
สมมติโมเดลตรวจจับสแปมถูกเทรนด้วยอีเมลของปีนี้
หกเดือนต่อมา สแปมเปลี่ยนรูปแบบ — ผู้ส่งใช้คำใหม่ โดเมนใหม่ วิธีเลี่ยงตัวกรองแบบใหม่
โมเดลไม่เปลี่ยน แต่ โลกรอบตัวมันขยับไปแล้ว
ข้อมูลที่เข้ามาใน Production เพี้ยนออกไปจากข้อมูลตอนเทรนเรื่อย ๆ ได้
นี่คือเหตุผลหนึ่งที่โมเดลซึ่งได้ 92% ตอน deploy อาจลดลงเหลือ 88%, 85% หรือ 70% ได้ ทั้งที่ไม่มีอะไรบนเซิร์ฟเวอร์พัง
โมเดลไม่ได้เปลี่ยน — ข้อมูลต่างหากที่เปลี่ยน
และนั่นคือเหตุผลที่การ monitor ต้องครอบคลุมไม่ใช่แค่เซิร์ฟเวอร์ แต่รวมถึง ข้อมูลที่ไหลเข้าโมเดล ด้วย
1.3 แม่นอย่างเดียวไม่พอ — ความเร็วก็สำคัญ#
ใน notebook คำถามที่มักถามคือ:
“โมเดลไหนแม่นที่สุด?”
Production เพิ่มอีกคำถาม:
“แล้วเร็วพอไหม?”
เพราะ model.predict() ไม่ได้รันใน notebook อีกแล้ว — มันรันอยู่ใน handler ของ API request
โฟลว์จริงคือ:
User → API → Model Predict → Response → User
ถ้าโมเดลใช้เวลา 20 มิลลิวินาที ผู้ใช้แทบไม่รู้สึก
แต่ถ้าการทำนายใช้เวลา 5 วินาที ทุก request ก็ต้องรอ 5 วินาที
และเมื่อผู้ใช้เข้ามาพร้อมกันจำนวนมาก ปัญหาก็ทวีคูณ
โมเดลที่แม่นที่สุด จึงไม่ได้เป็นโมเดลที่ดีที่สุดสำหรับ Production โดยอัตโนมัติ
บางครั้งเรายอมแลกความแม่นเล็กน้อยเพื่อได้โมเดลที่เร็วกว่า ใช้หน่วยความจำน้อยกว่า และรองรับ request ได้มากกว่า
นี่คือ trade-off ใหม่เมื่อโมเดลออกจาก notebook:
Prediction Quality ↔ Latency ↔ Cost
โมเดลที่ดีบน Production จึงไม่ใช่แค่โมเดลที่ ทำนายแม่น
แต่ต้อง เร็วพอ เสถียรพอ และราคาคุ้ม ด้วย
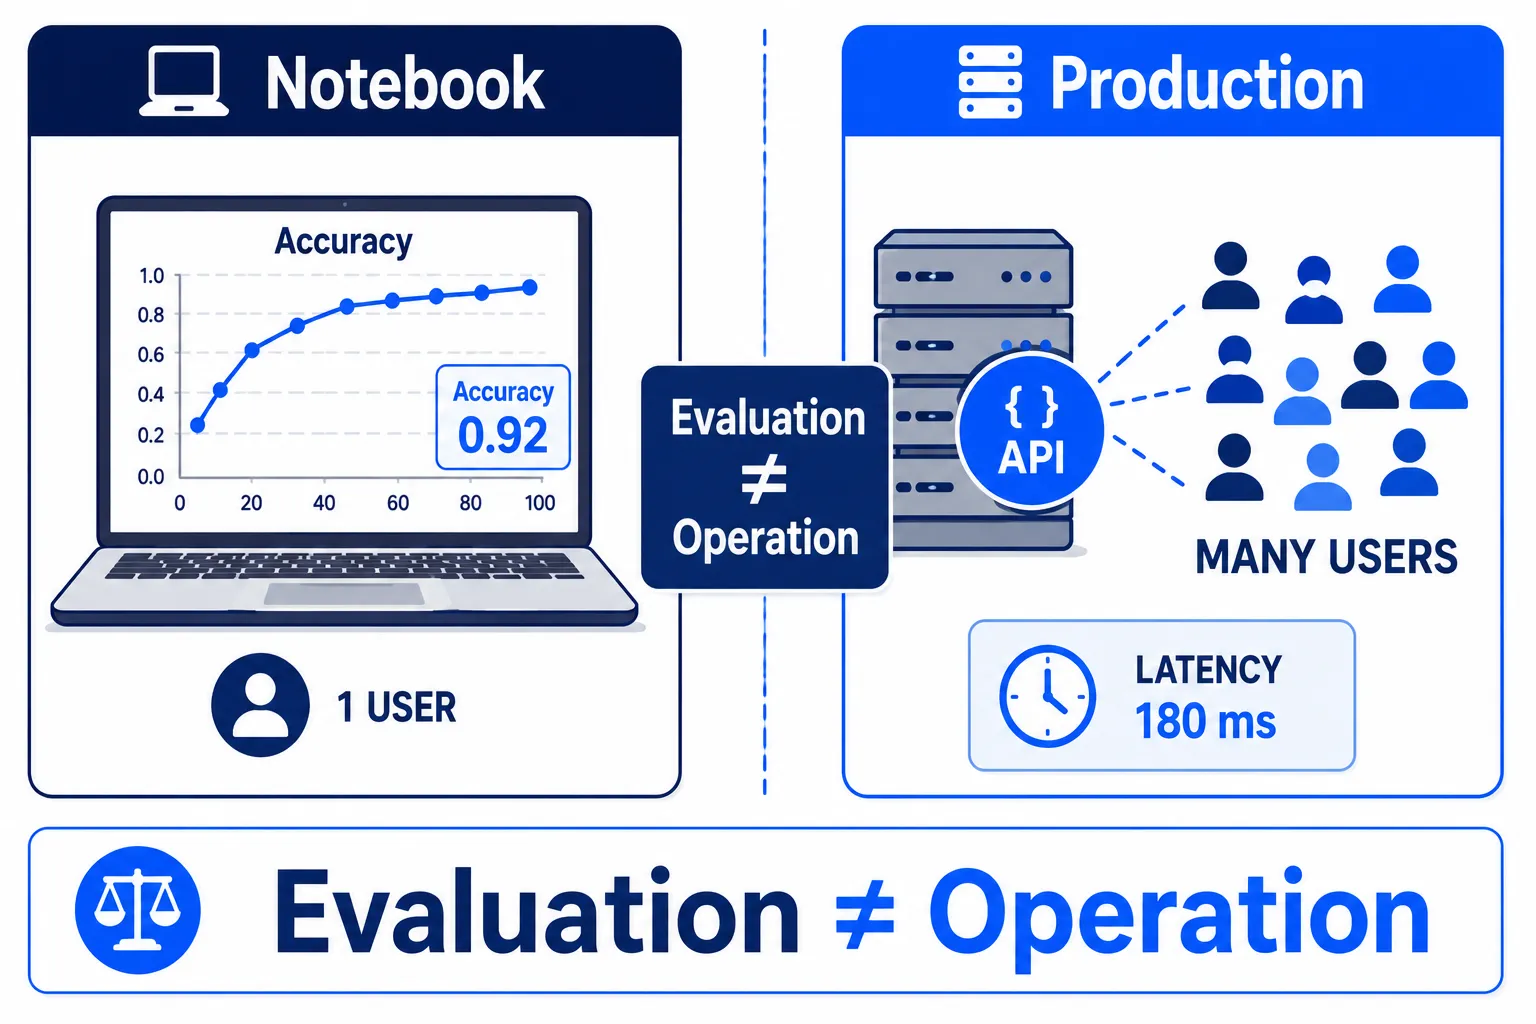
นี่คือความต่างสำคัญระหว่าง การประเมินโมเดล กับ การเดินเครื่องโมเดล
ในห้องเรียน เรื่องอาจจบด้วยตัวเลขเดียว:
Accuracy = 92%
แต่ใน Production คำถามยังไหลเข้ามาไม่หยุด:
ตอนนี้โมเดลยังแม่นอยู่ไหม? ข้อมูลที่เข้ามายังหน้าตาเหมือนเดิมไหม? มันตอบเร็วพอไหม? มันรับปริมาณ request ไหวไหม? และเรารู้ด้วยหรือเปล่าว่าคำตอบที่มันให้ไปถูกต้องไหม?
เพราะบน Production ข้อสอบไม่มีวันหมด และโมเดลก็ไม่เคยทำข้อสอบเสร็จจริง ๆ
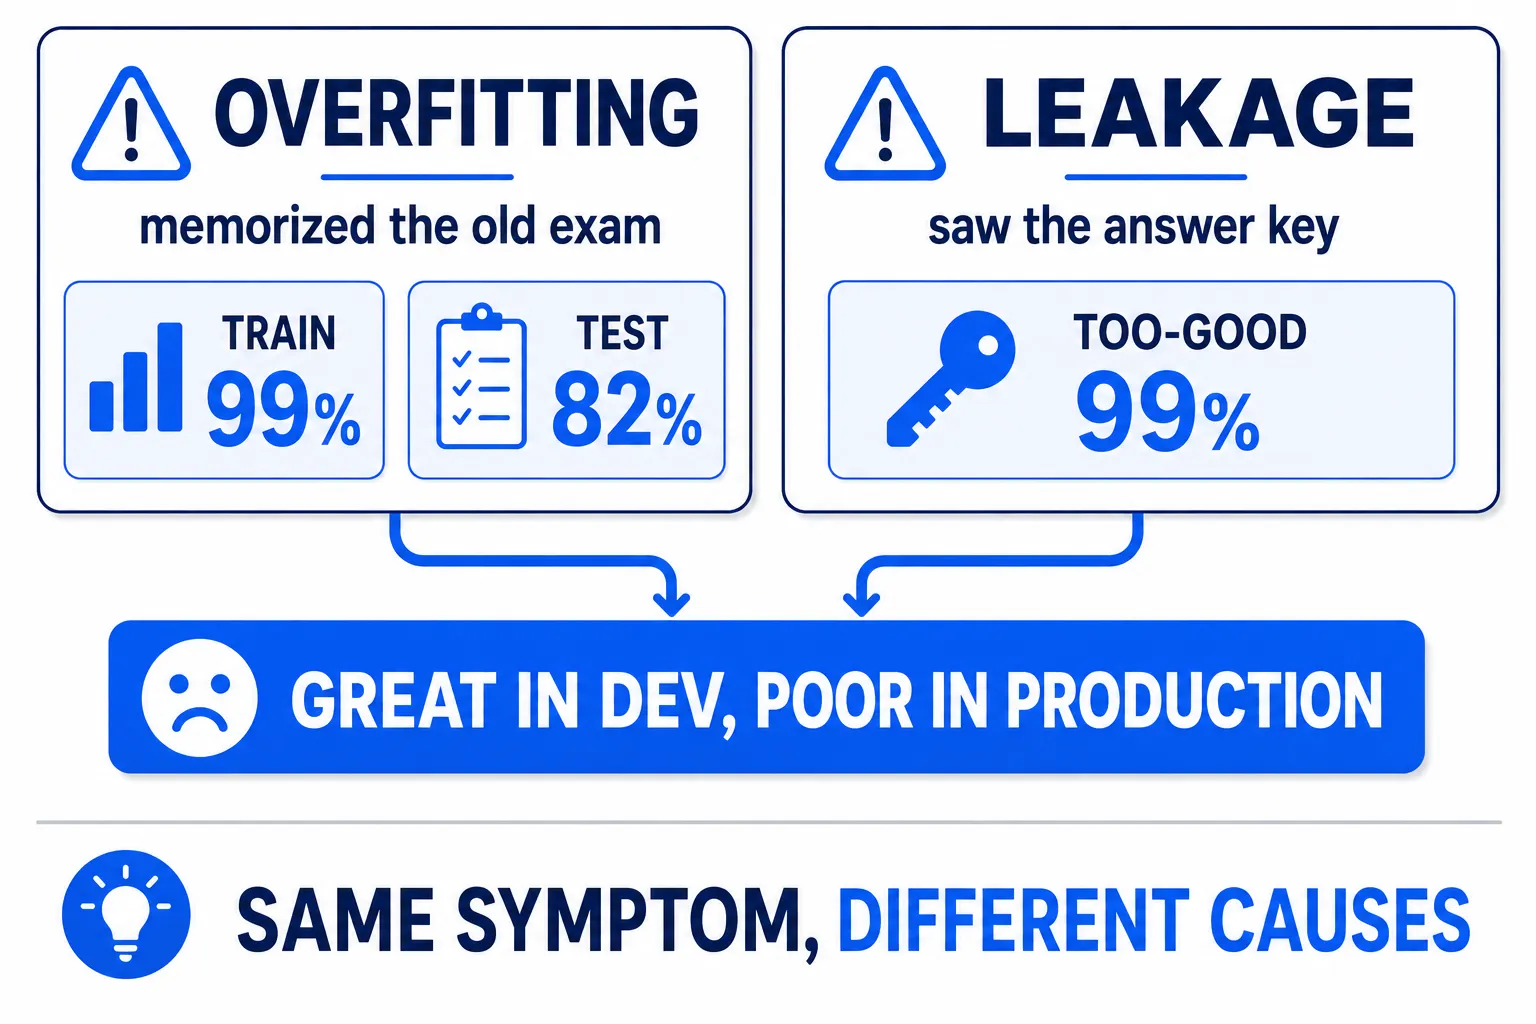
มีปัญหา Machine Learning คลาสสิกอีกสองข้อที่ควรทบทวนก่อนขึ้น Production: Overfitting และ Data Leakage
ทั้งคู่ให้อาการที่คล้ายกันมาก:
ดูดีตอนทดลอง แต่แย่กว่าที่คาดตอนใช้งานจริง
แต่สาเหตุต่างกัน
1.4 Overfitting — จำเก่งเกินไปจนรับมือของใหม่ไม่ได้#
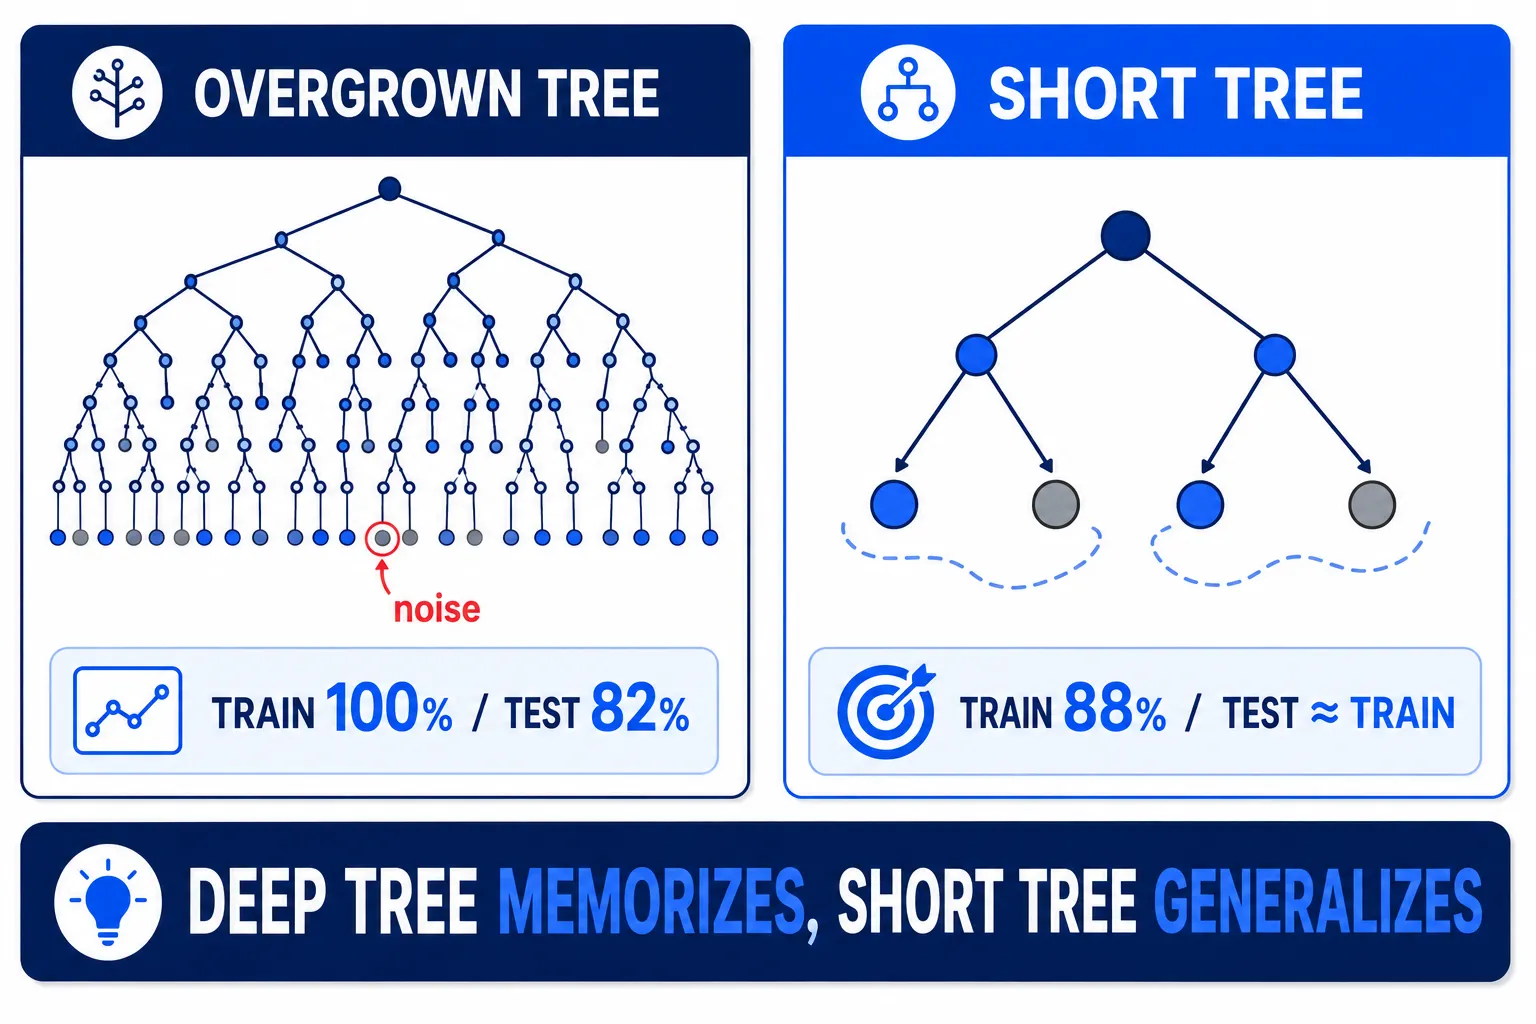
Overfitting เกิดขึ้นเมื่อโมเดลเรียนรู้แพตเทิร์นที่ generalize ไปยังข้อมูลใหม่ไม่ได้ แต่กลับไปจำรายละเอียดของข้อมูลเทรนมากเกินไปแทน
ลองนึกถึงนักเรียนที่ไม่เคยเข้าใจเนื้อหาแต่ท่องข้อสอบเก่าทุกชุดพร้อมเฉลย
ถ้าข้อสอบจริงตรงกับของเก่า — คะแนนเต็ม
เปลี่ยนโจทย์แม้แต่นิดเดียว ทุกอย่างก็พังหมด
Machine Learning ก็ทำงานแบบเดียวกัน
อาการที่พบบ่อย:
Training score สูงมาก แต่ Test score ต่ำกว่าอย่างเห็นได้ชัด
เช่น:
Training Accuracy = 99%
Test Accuracy = 82%
ลองเห็นกับตาด้วยไฟล์จริง — สร้าง signups.csv เพื่อทำนายว่าลูกค้าจะสมัครสมาชิกไหม (แถวส่วนใหญ่เป็นไปตาม “เข้ามามากกว่า 2 ครั้ง = สมัคร” โดยมี 2 แถวที่ฝืนแพตเทิร์นเป็น noise):
age,income,visits,subscribed
26,35000,0,0
40,55000,0,0
39,50000,6,1
36,29000,0,0
23,61000,1,0
41,49000,6,1
42,56000,2,0
22,59000,6,1
37,66000,2,0
37,60000,5,1
40,36000,1,0
40,53000,0,0
42,54000,1,1
45,42000,4,1
43,41000,6,1
36,60000,2,1ลอง Decision Tree แบบไม่จำกัดความลึก:
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("signups.csv")
X = df.drop(columns="subscribed")
y = df["subscribed"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)

tree = DecisionTreeClassifier()      # ไม่จำกัดความลึก → โตจนจำทุกแถวได้หมด
tree.fit(X_tr, y_tr)

print("train:", tree.score(X_tr, y_tr))   # 1.0 — จำทุกแถว
print("test :", tree.score(X_te, y_te)) # 0.75 — ต่ำกว่า train ชัดเจนต้นไม้ที่โตเต็มที่คิดกฎพิเศษขึ้นมาเพื่อจำแม้กระทั่งแถว noise พอเจอข้อมูลที่ไม่เคยเห็นก็เลยเดาผิด
วิธีแก้มีหลายแบบ: เพิ่มข้อมูล, ลดความซับซ้อนของโมเดล หรือใช้ regularization เพื่อไม่ให้โมเดลพยายามจำข้อมูลเทรนมากเกินไป
ลองวิธีที่ง่ายที่สุด — จำกัดความลึกของต้นไม้:
simple = DecisionTreeClassifier(max_depth=2)   # บังคับให้เรียนแค่แพตเทิร์นหลัก
simple.fit(X_tr, y_tr)

print("train:", simple.score(X_tr, y_tr))   # 0.83 — ลดลงจาก 1.0
print("test :", simple.score(X_te, y_te)) # 1.0 — สูงกว่าต้นไม้เต็ม ช่องว่างแคบลงพูดสั้น ๆ:
Overfitting = จำมากเกินไป เข้าใจแพตเทิร์นจริงน้อยเกินไป
1.5 Data Leakage — โมเดลแอบเห็นเฉลย#
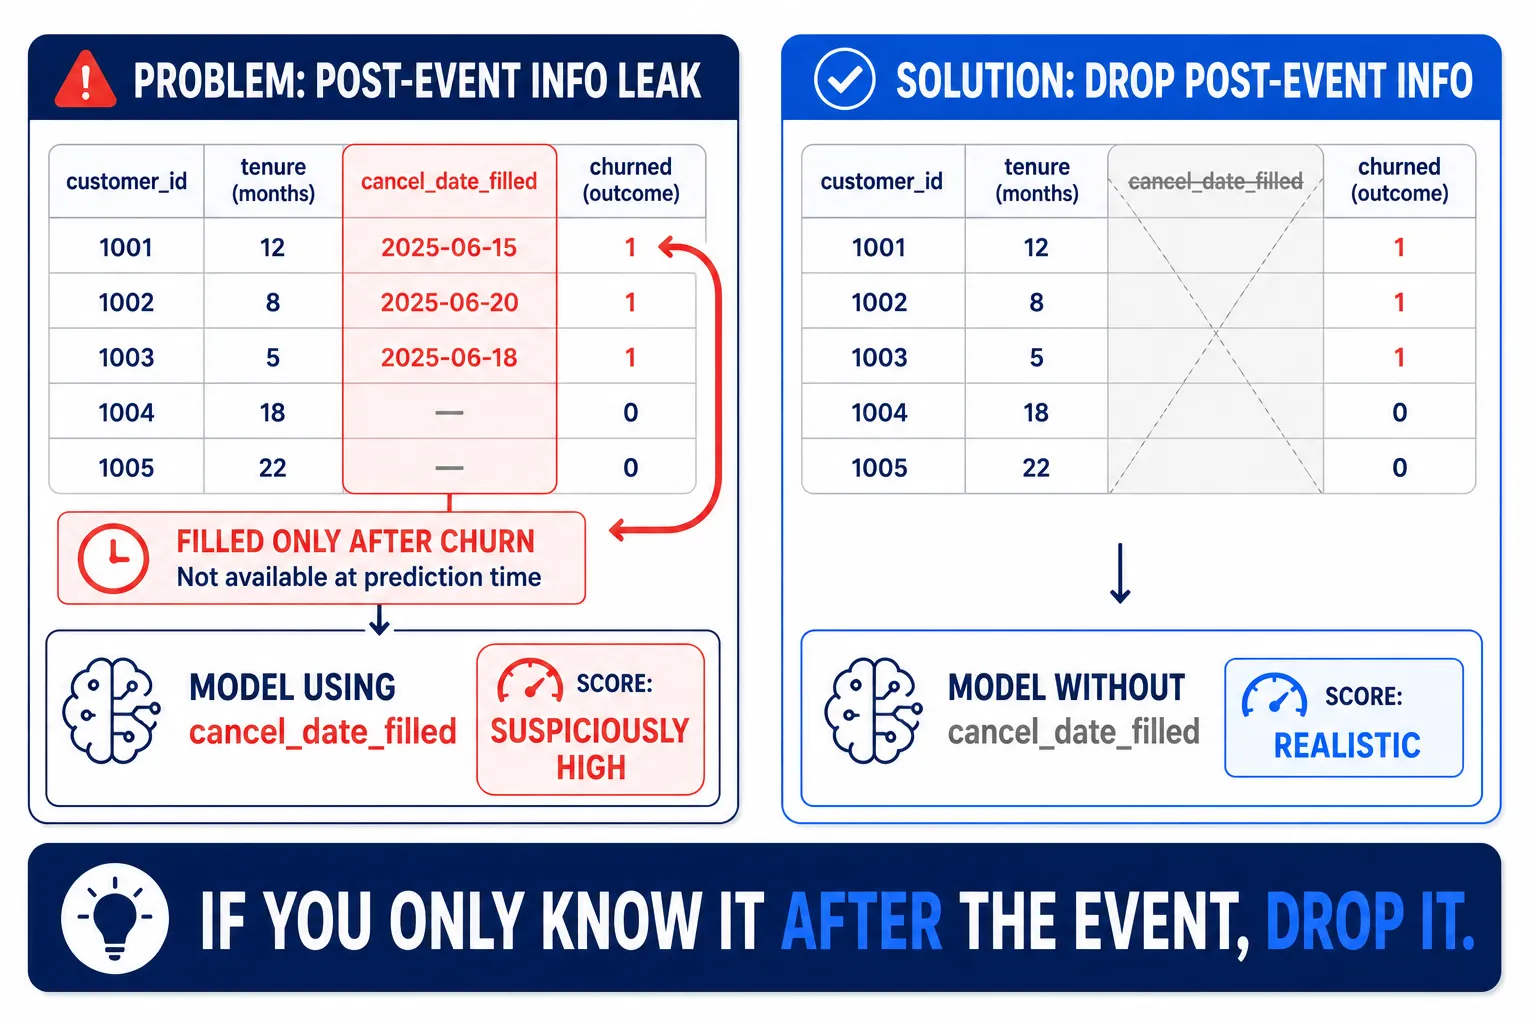
Data Leakage แนบเนียนกว่า เพราะผลลัพธ์อาจดูดีจนโมเดลเหมือนเก่งเวอร์
ถ้าต้องสรุป leakage ในบรรทัดเดียว จำไว้ว่า:
Data Leakage = โมเดลได้เห็นเฉลย
กฎมีบรรทัดเดียว:
ทุกฟีเจอร์ที่ใช้ต้องเป็นข้อมูลที่รู้อยู่แล้ว ณ วินาทีที่ทำการทำนายจริง
ถ้าฟีเจอร์เพิ่งเกิดขึ้น หลังเหตุการณ์ที่กำลังจะทำนาย ก็ห้ามเอามาเป็น input
เริ่มด้วยตัวอย่างเล็ก ๆ ก่อน — สร้าง churn.csv เพื่อทำนายว่าลูกค้าจะยกเลิกบริการไหม โดยมีคอลัมน์ cancel_date_filled ที่ระบบเติมค่าให้ หลังจาก ลูกค้ายกเลิกไปแล้วเท่านั้น:
months,plan_price,support_calls,cancel_date_filled,churned
14,299,0,0,0
8,499,2,0,0
3,199,1,0,0
11,399,2,0,0
17,599,1,0,0
15,299,3,0,0
6,399,2,1,1
3,599,4,1,1
16,299,3,1,1
4,199,2,1,1
2,499,5,1,1
12,399,1,1,1เทรนทั้งสองแบบ — มีและไม่มีคอลัมน์นั้น (ใช้ train/test split เดียวกันเพื่อเปรียบเทียบอย่างยุติธรรม):
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("churn.csv")
X_leaky = df.drop(columns="churned")                          # รวม cancel_date_filled
X_clean = X_leaky.drop(columns="cancel_date_filled")          # ตัดคอลัมน์ที่รู้ทีหลังออก
y = df["churned"]

X_tr, X_te, y_tr, y_te = train_test_split(X_leaky, y, test_size=0.25, random_state=42)
X_tr_c = X_tr.drop(columns="cancel_date_filled")
X_te_c = X_te.drop(columns="cancel_date_filled")

leaky = RandomForestClassifier(random_state=42).fit(X_tr, y_tr)
clean = RandomForestClassifier(random_state=42).fit(X_tr_c, y_tr)

print("with leaky column :", leaky.score(X_te, y_te))    # สูงจนน่าสงสัย
print("column dropped :", clean.score(X_te_c, y_te)) # ต่ำกว่า — และนี่คือตัวเลขจริงคอลัมน์เดียวที่รู้ “ทีหลัง” ทำให้คะแนนพองขึ้น — แต่ใน Production คอลัมน์นั้นจะเป็น 0 สำหรับทุกคน เพราะ ณ เวลาทำนายยังไม่มีใครยกเลิก
สำหรับเวอร์ชันที่อันตรายกว่านี้จากโรงพยาบาลจริง อ่านต่อในกรณีศึกษาถัดไป
1.6 กรณีศึกษา: ทำนายการเข้า ICU#
สมมติโรงพยาบาลต้องการโมเดลที่ทำนาย — ตั้งแต่ตอนที่ผู้ป่วยเข้ารับการรักษา — ว่าใครเสี่ยงทรุดหนักจนต้องเข้า ICU
ทีมข้อมูลรวบรวมฟีเจอร์หลายอย่างจากเวชระเบียน:
- อายุ
- ความดันโลหิต
- ผลแล็บ
- ยาที่ได้รับ
- โรคประจำตัว
และมีอีกหนึ่งคอลัมน์:
icu_transfer_count
หมายถึง จำนวนครั้งที่ผู้ป่วยถูกย้ายเข้า ICU
patients.csv เวอร์ชันจิ๋วสำหรับทดลอง (ของจริงมีหลายพันแถว):
age,blood_pressure,lab_result,icu_transfer_count,icu_admitted
68,150,1.9,2,1
61,152,2.1,0,0
72,146,2.4,3,1
66,138,1.8,0,0
65,154,2.2,1,1
69,135,2.3,0,0
70,144,1.6,2,1
63,148,1.5,0,0
67,141,2.0,3,1
62,147,1.7,0,0
71,149,1.2,1,1
64,139,2.5,0,0เทรนด้วยทุกคอลัมน์ รวมถึง icu_transfer_count:
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("patients.csv")
X = df.drop(columns="icu_admitted")
y = df["icu_admitted"]

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)
model = RandomForestClassifier(random_state=42).fit(X_tr, y_tr)
print(model.score(X_te, y_te)) # คะแนนดีจนแปลก — ให้สงสัยไว้ก่อนเลยจากนั้นก็เอาข้อมูลทั้งชุดไปเทรนโมเดล
ผลลัพธ์ดูสวยงาม:
Accuracy = 99%
ทุกคนดีใจ — โมเดลดูเหมือนจะรู้แม่นยำเกือบเป๊ะว่าใครจะไปลงเอยที่ ICU
แต่จริง ๆ แล้วโมเดลอาจเจอทางลัดง่าย ๆ:
if icu_transfer_count > 0
→ ผู้ป่วยรายนี้มีแนวโน้มเป็นเคสหนักมาก
เผิน ๆ โมเดลดูเก่ง
แต่ลองถามคำถามสำคัญ:
icu_transfer_countถูกเติมค่าเมื่อไหร่?
คำตอบ: หลังจากผู้ป่วยถูกย้ายเข้า ICU ไปแล้ว
นั่นแหละคือปัญหา
เป้าหมายคือโมเดลที่ทำนายว่า “ผู้ป่วยรายนี้จะต้องเข้า ICU ไหม?”
แต่ข้อมูลกลับกระซิบบอกมันเงียบ ๆ ว่า “ผู้ป่วยรายนี้เข้า ICU ไปแล้วกี่ครั้ง”
โมเดลไม่ได้กำลังเรียนที่จะทำนายอนาคต
มันกำลัง อ่านอนาคตที่หลุดเข้ามาในข้อมูลเทรน
ผลลัพธ์ปลอมตัวมาเป็น input
ตอน Deploy จะเกิดอะไรขึ้น?#
ตอนเทรน ข้อมูลถูกดึงมาจากประวัติย้อนหลัง
ผู้ป่วยที่เคยเข้า ICU จึงอาจแสดงค่า:
icu_transfer_count = 2
โมเดลพึ่งพาฟีเจอร์นี้เป็นสัญญาณที่แรงมาก
แต่ใน Production ต้องทำนาย ตอนผู้ป่วยเพิ่งเข้ารับการรักษา
ณ ตอนนั้นผู้ป่วยยังไม่ถูกย้ายไปไหน
ดังนั้น:
icu_transfer_count = 0
สำหรับเกือบทุกคน
ฟีเจอร์ที่ดันความแม่น 99% กลับแทบไร้ประโยชน์ ณ วินาทีที่มันสำคัญจริง ๆ
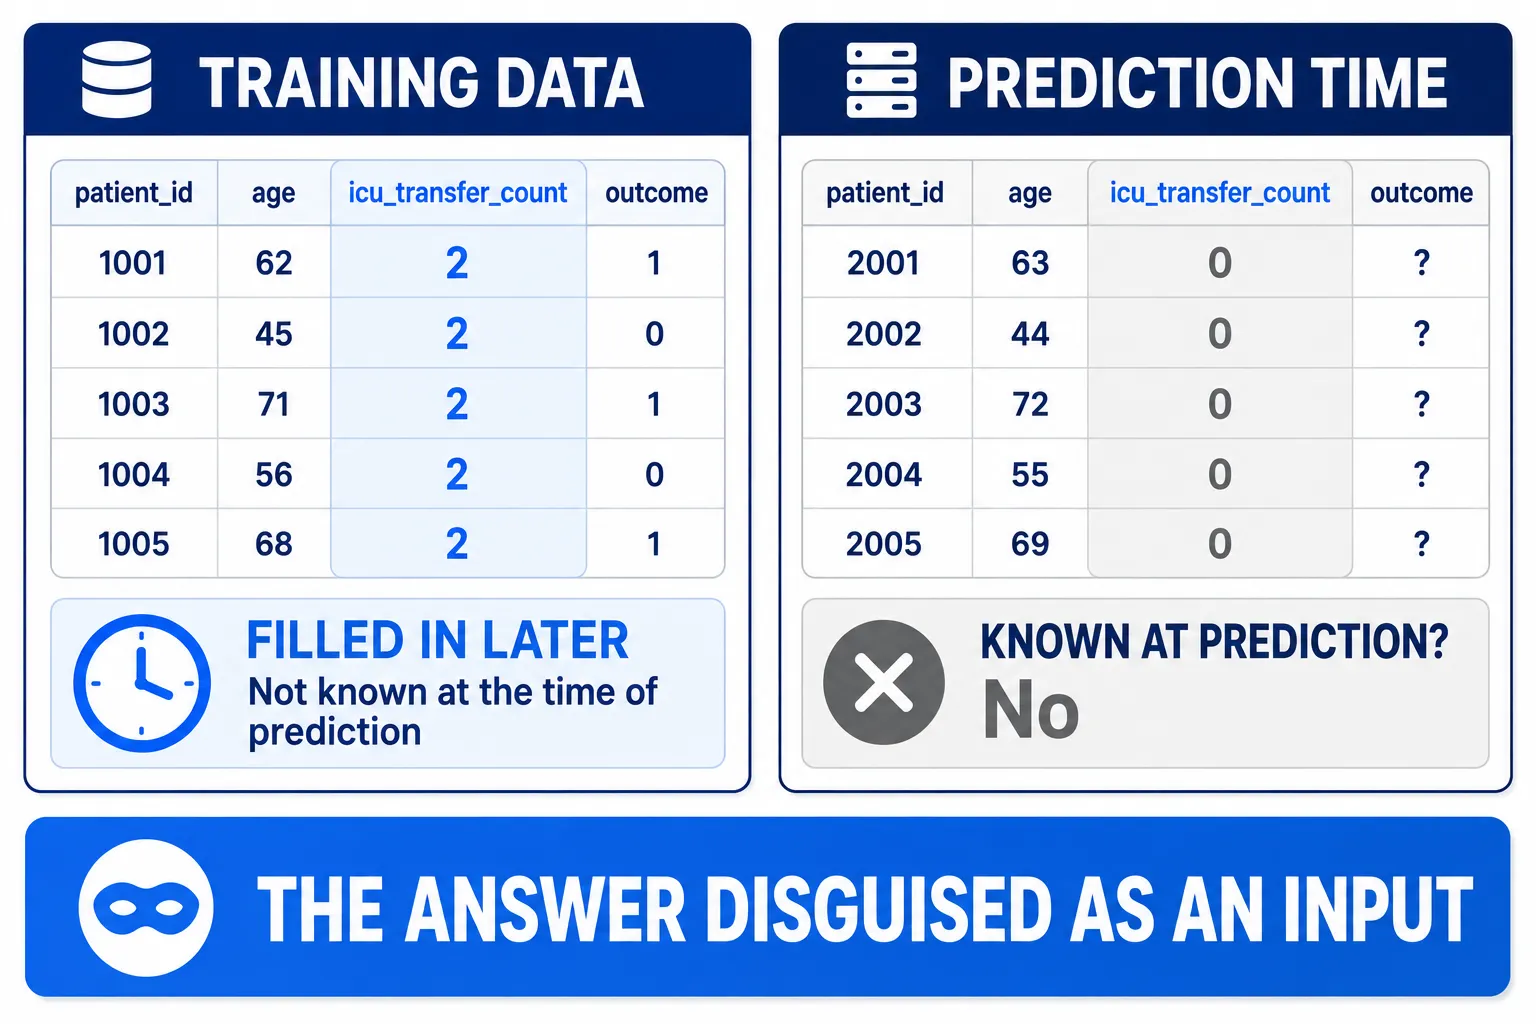
วางเทียบกัน:
| ตอนเทรน | ตอนทำนายจริง | |
|---|---|---|
| ผู้ป่วยที่ภายหลังเข้า ICU | icu_transfer_count = 2 | icu_transfer_count = 0 |
| ผู้ป่วยที่ไม่เคยเข้า ICU | icu_transfer_count = 0 | icu_transfer_count = 0 |
ชื่อคอลัมน์เดียวกัน แต่ ความหมายต่างกันโดยสิ้นเชิง
การเทรนมองย้อนกลับไปยังสิ่งที่เกิดขึ้นแล้ว
การทำนายยืนอยู่ในปัจจุบัน พยายามเดาสิ่งที่ ยังไม่เกิดขึ้น
ช่องว่างนั้นแหละคือที่ที่ Data Leakage ซ่อนตัวอยู่
คำถามเดียวที่จับ Leakage ได้#
การเลือกฟีเจอร์ไม่ต้องใช้เช็กลิสต์ซับซ้อน
ถามทุกคอลัมน์ว่า:
“ณ วินาทีที่ระบบต้องทำนายจริง ค่านี้รู้อยู่แล้วหรือยัง?”
ถ้าคำตอบคือ รู้แล้ว ก็อาจใช้เป็นฟีเจอร์ได้
- อายุตอนเข้ารับการรักษา → รู้แล้ว
- ความดันโลหิตตอนเข้ารับการรักษา → รู้แล้ว
- ผลแล็บที่ออกก่อนเวลาทำนาย → รู้แล้ว
- การย้ายเข้า ICU หลังเข้ารับการรักษา → ยังไม่รู้
ถ้ายังไม่รู้ ณ เวลาทำนาย โมเดลก็ต้องไม่เห็นมัน
1.7 Overfitting กับ Leakage ต่างกันอย่างไร?#
ทั้งคู่ทำให้โมเดลดูดีตอนพัฒนา แต่ล้มเหลวเมื่อเจอโลกจริง
แต่สาเหตุรากต่างกัน:
| Overfitting | Data Leakage | |
|---|---|---|
| ปัญหา | โมเดลจำข้อมูลเทรน | โมเดลได้รับข้อมูลที่ไม่ควรได้ |
| อาการทั่วไป | Training ดี, Test แย่ | Training และ Test ดีจนแปลก |
| แก่นของปัญหา | generalize ไปข้อมูลใหม่ไม่ได้ | การประเมินโกหกว่าโมเดลดี |
| โมเดลจำง่าย ๆ | ท่องข้อสอบเก่า | เห็นเฉลย |
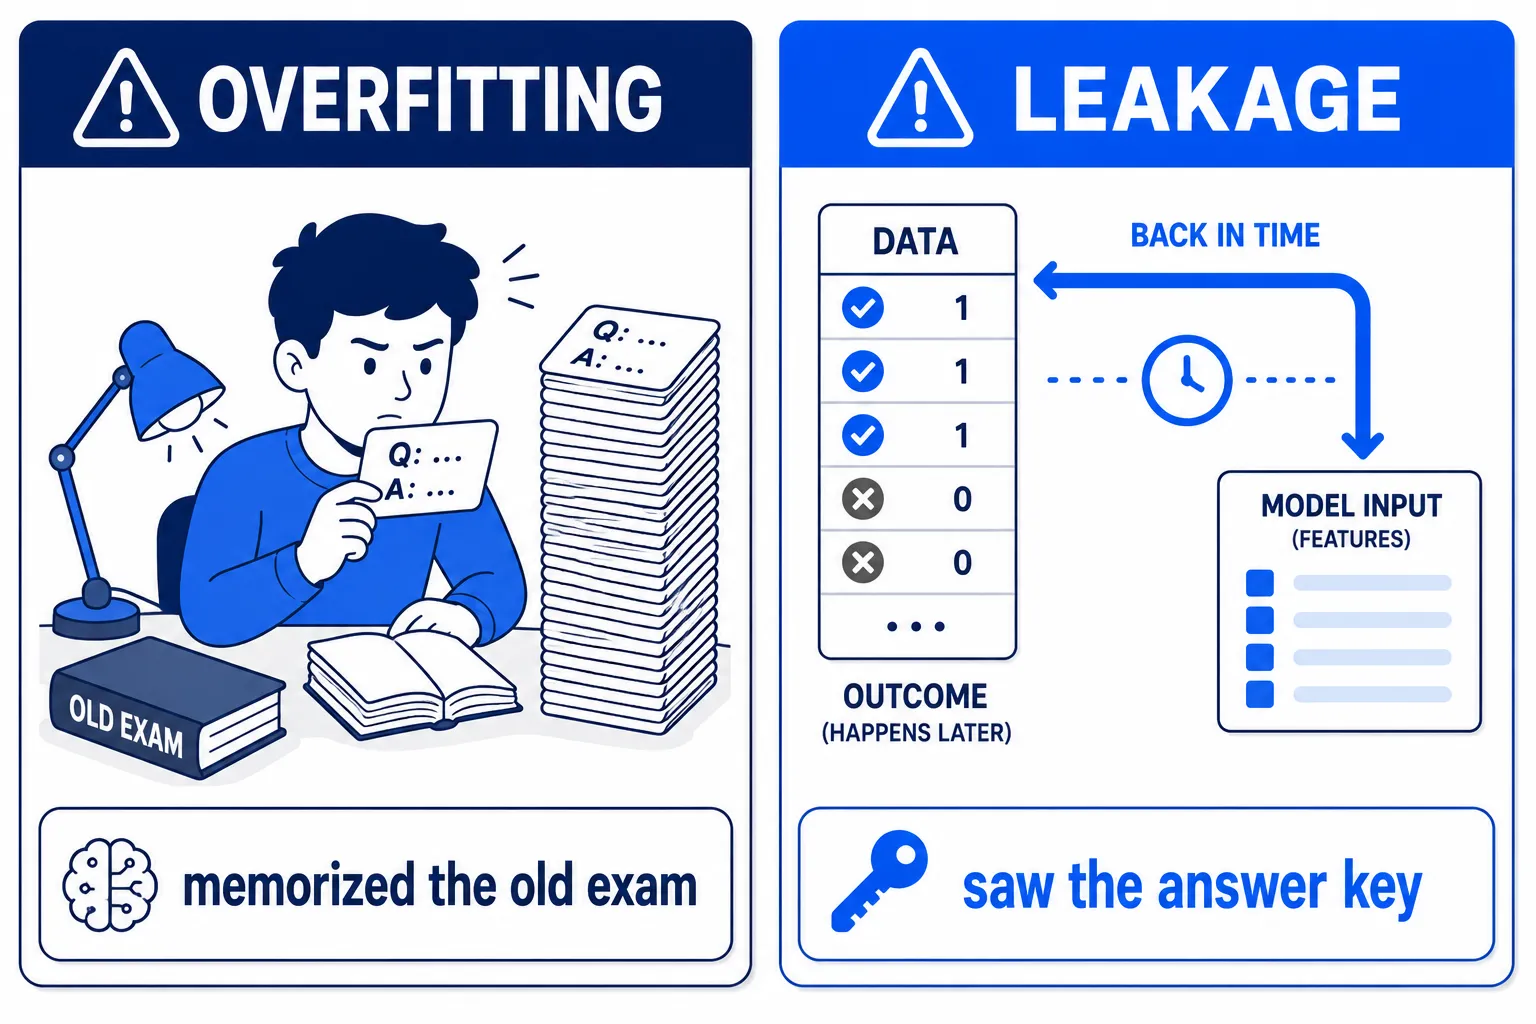
Data Leakage เป็นหนึ่งในความผิดพลาดที่อันตรายที่สุดของ Machine Learning เพราะมันไม่ได้ทำให้ผลลัพธ์ดูแย่
ตรงกันข้าม — มันทำให้ผลลัพธ์ดูดีเกินจริง
ความแม่นสูง เทสต์ผ่าน กราฟสวย ทุกคนเห็นตรงกันว่าพร้อม deploy
จนกระทั่งระบบเจอข้อมูลจริง
แล้วถึงค่อยรู้ว่าโมเดล “แม่น 99%” นั้นแท้จริงแล้วไม่เคยเก่งเรื่องทำนายอนาคตเลย
ก่อนใช้ฟีเจอร์ใด อย่าถามแค่ “มันทำให้โมเดลแม่นขึ้นไหม?” ให้ถามด้วยว่า “ข้อมูลนี้จะมีอยู่จริงในมือตอนระบบทำงานจริงหรือเปล่า?“
1.8 Model Decay: เหตุผลที่ต้องมี Monitoring#
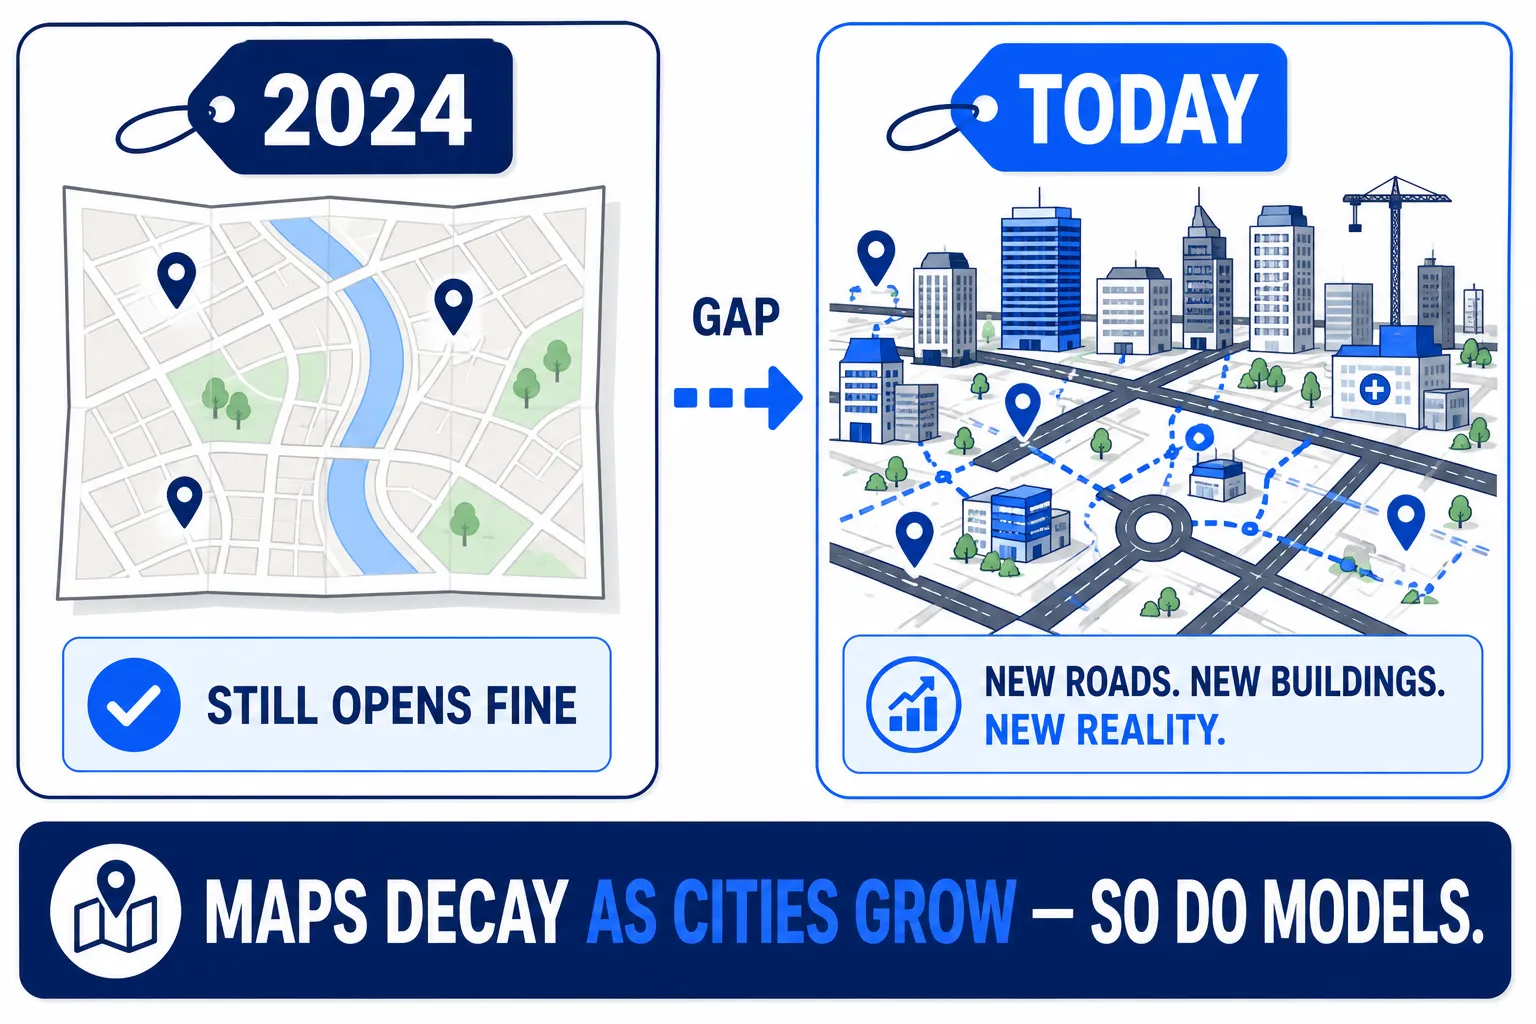
เริ่มจากความจริงง่าย ๆ ข้อหนึ่ง:
โมเดลเรียนจากโลกในอดีต แต่ต้องทำงานในโลกของวันนี้
ลองนึกภาพโมเดลเป็น แผนที่เมือง
แผนที่ถูกวาดในปี 2024 จากถนน อาคาร และเส้นทางที่มีอยู่ตอนนั้น พอวาดเสร็จ แผนที่ก็หยุดอยู่แค่นั้น
แต่เมืองจริงไม่ได้หยุดตาม
ถนนใหม่ ร้านใหม่ พฤติกรรมการเดินทางแบบใหม่ เกิดขึ้นตลอดเวลา
แผนที่ไม่ได้ “พัง” — มันยังเปิดได้ปกติ แค่ค่อย ๆ ตรงกับโลกจริงน้อยลงเรื่อย ๆ
โมเดล Machine Learning ก็เหมือนกัน
เมื่อโมเดลเริ่ม decay — คุณภาพลดลง — มักมีสองสาเหตุหลัก: Data Drift และ Concept Drift
Data Drift — เมื่อคนที่เดินเข้าประตูเปลี่ยนไป#
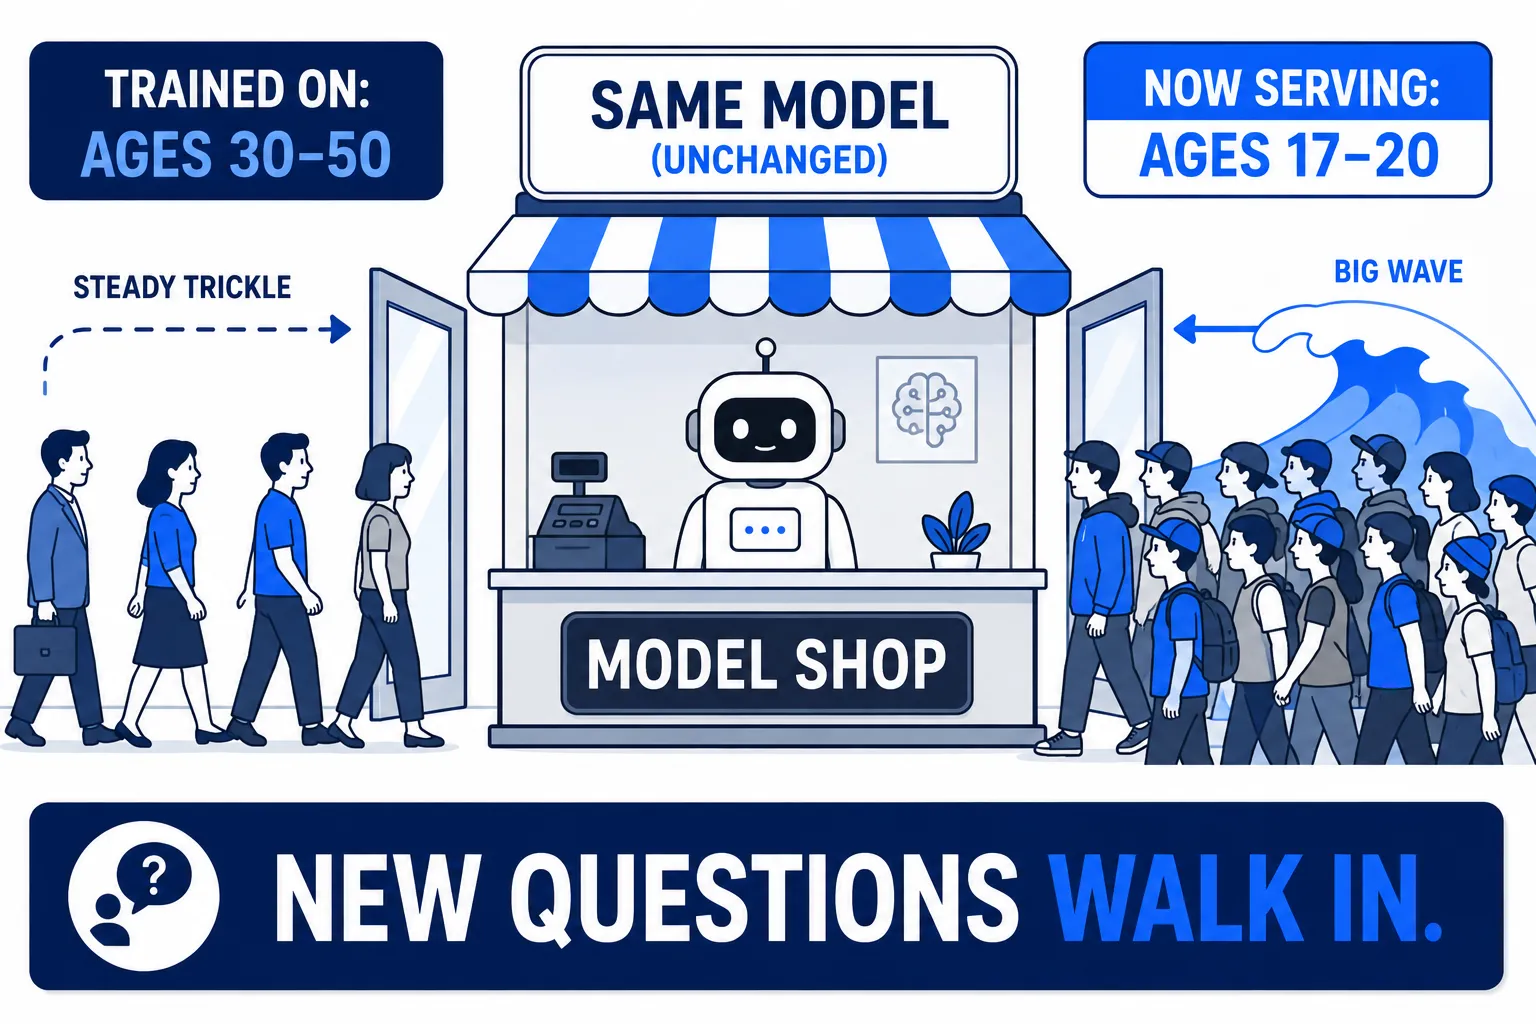
สมมติโมเดลทำนายว่าลูกค้าจะซื้อสินค้าอะไร
ข้อมูลเทรนมาจากลูกค้าปี 2024 ส่วนใหญ่อายุ 30–50 ปี
โมเดลเรียนพฤติกรรมของกลุ่มนั้นได้ค่อนข้างดี
วันหนึ่งฝ่ายการตลาดปล่อยแคมเปญ TikTok ที่ปังมาก
จู่ ๆ ก็มีคลื่นลูกค้าอายุ 17–20 ปีจำนวนมากเข้ามาใช้ระบบ
ปัญหาคือ โมเดล แทบไม่เคยเห็นกลุ่มนี้ตอนเทรน
มันยังทำนายตอบไปตามปกติ — ไม่มี error อาจจะตอบด้วยความมั่นใจสูงด้วยซ้ำ
แต่ตอนนี้มันกำลังถูกถามเรื่องคนกลุ่มที่แทบไม่รู้จัก
นี่คือ Data Drift
Input เปลี่ยน แต่โมเดลยังเหมือนเดิม
หรือพูดง่าย ๆ:
Data Drift = ข้อมูลชนิดใหม่เดินเข้าประตูมา
Concept Drift — ข้อมูลหน้าตาเหมือนเดิม แต่ความหมายเปลี่ยน#
Concept Drift ต่างออกไปเล็กน้อย
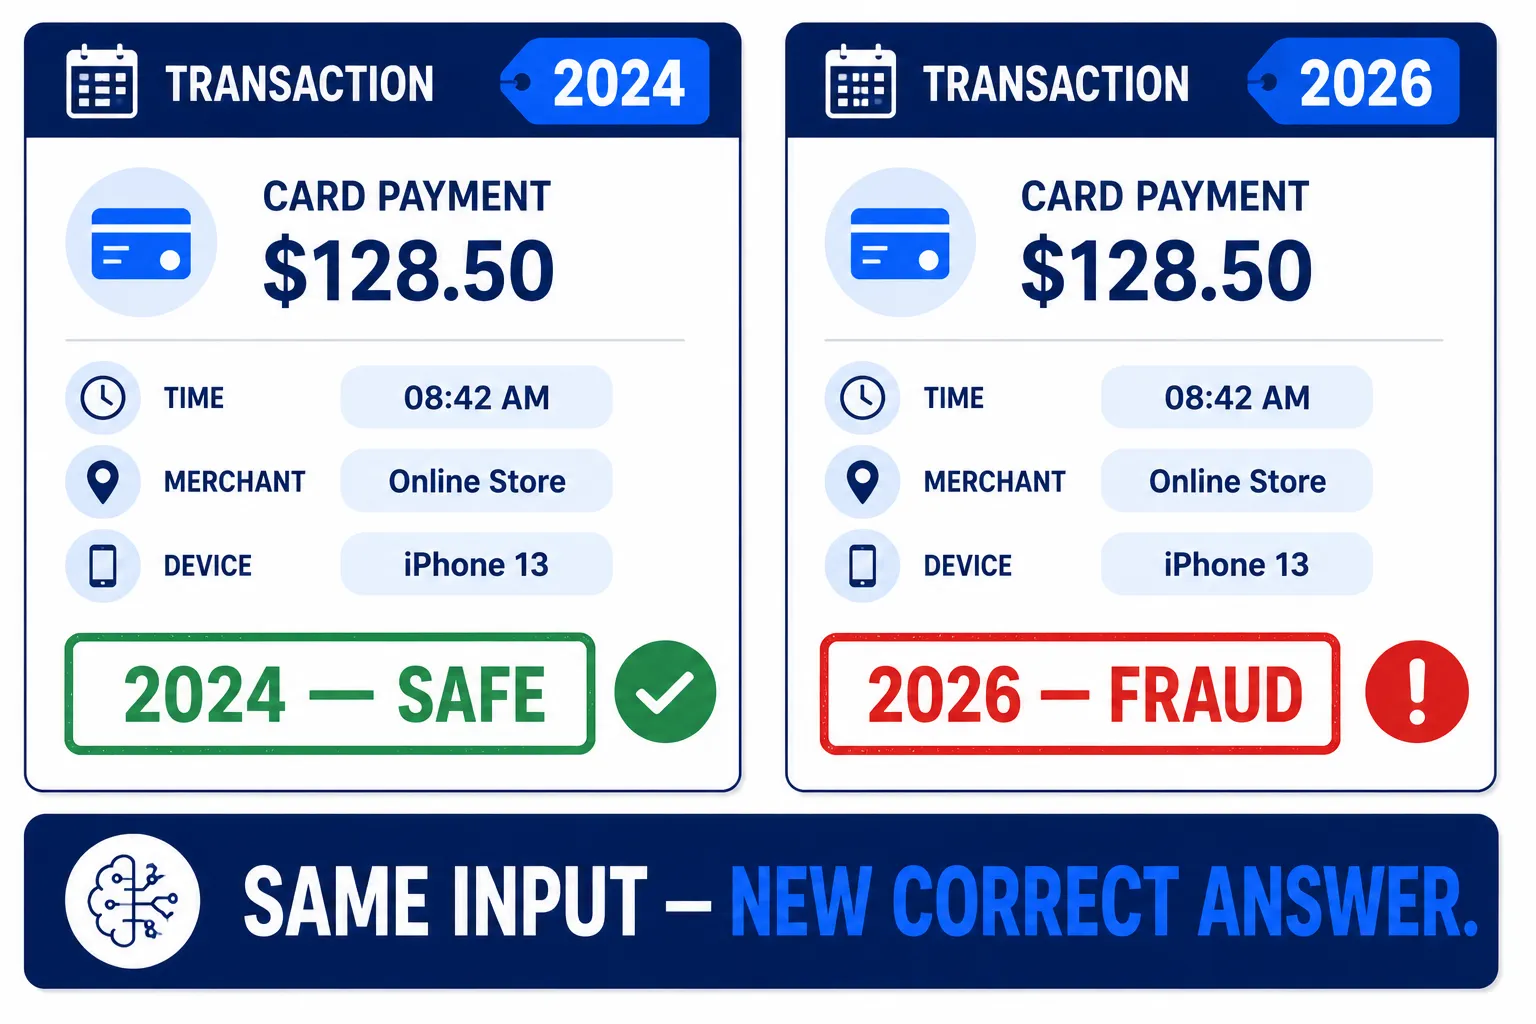
สมมติโมเดลตรวจจับการฉ้อโกงถูกสร้างในปี 2024
มันเรียนว่าธุรกรรมประมาณนี้น่าสงสัย:
- ซื้อติด ๆ กันหลายครั้ง
- ยอดน้อย ๆ
- เวลาผิดปกติ
- อุปกรณ์ใหม่
เวลาผ่านไป มิจฉาชีพก็ปรับตัว
แทนที่จะทำธุรกรรมยอดน้อยหลายครั้งในเวลาแปลก ๆ พวกเขาเปลี่ยนมาใช้ยอดใหญ่ขึ้น เวลาปกติ และบัญชีหรืออุปกรณ์ที่ขโมยมา
ข้อมูลบางส่วนอาจยังดูเหมือนธุรกรรมปกติที่โมเดลเคยเห็น
แต่ ความสัมพันธ์ระหว่าง input กับคำตอบที่ถูกต้องได้เปลี่ยนไปแล้ว
แพตเทิร์นที่เคยแปลว่า “ปลอดภัย” ตอนนี้อาจแปลว่า “ฉ้อโกง”
นี่คือ Concept Drift
Input คล้ายเดิม แต่คำตอบที่ถูกต้องเปลี่ยนไป
จำความต่างเป็นบรรทัดเดียว:
Data Drift = โจทย์ใหม่ Concept Drift = คำตอบใหม่ของโจทย์เดิม
1.9 จุดที่น่ากลัว: ทั้งคู่เกิดขึ้นอย่างเงียบ ๆ#
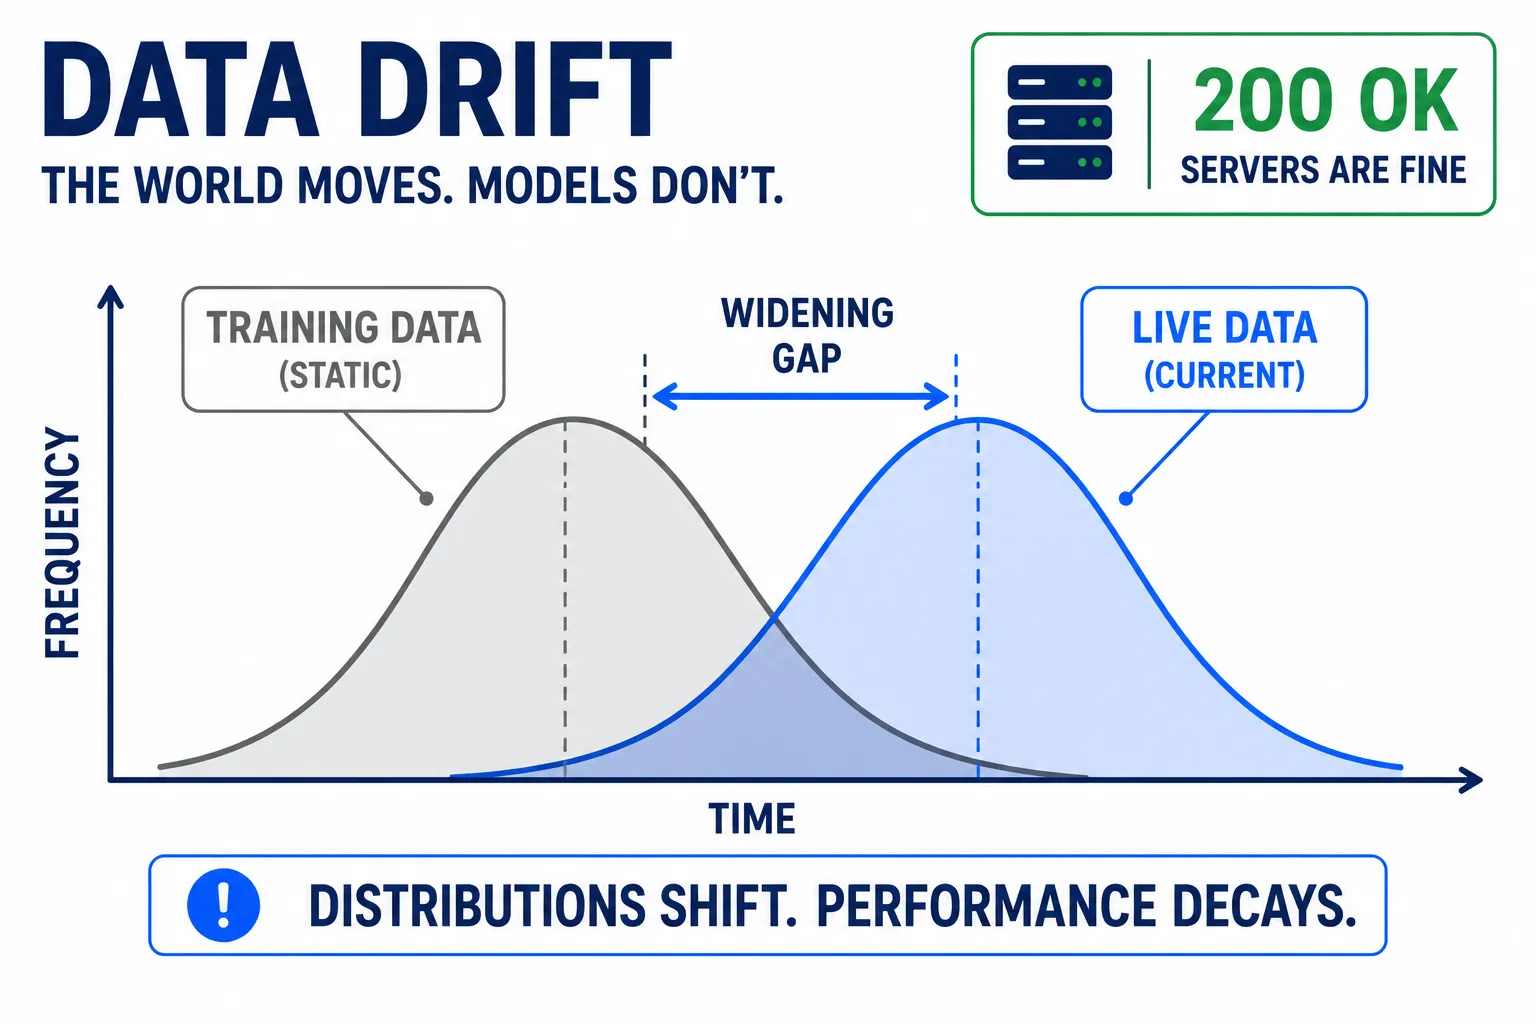
เซิร์ฟเวอร์อาจยังทำงานปกติ
API ยังตอบ:
200 OK
Latency ยัง 30 ms CPU ยัง 40% Error rate ยัง 0%
แดชบอร์ดของ infrastructure อาจเขียวหมดทุกช่อง
แต่การทำนายของโมเดลกำลังแย่ลงเงียบ ๆ
และตัวโมเดลเองก็ยกมือขึ้นมาบอกไม่ได้ว่า:
“ข้อมูลที่เข้ามาช่วงนี้ไม่เหมือนที่ฉันเคยเรียนเลยนะ”
บางครั้งความจริงจะปรากฏก็ต่อเมื่อ ground truth — คำตอบจริง — มาถึงในอีกหลายวันหรือหลายสัปดาห์ต่อมา
เช่น ระบบตรวจจับการฉ้อโกงบอกว่าธุรกรรมวันนี้ปลอดภัย แล้วสองสัปดาห์ต่อมาลูกค้าแจ้งว่าบัตรถูกขโมย ถึงตอนนั้นถึงจะรู้ว่าการทำนายนั้นผิด
นี่คือเหตุผลที่วงจร serving ต้องเป็น ลูป ไม่ใช่เส้นตรง
Train → Serve → Monitor → Retrain → Serve → Monitor → …
และเป็นเหตุผลที่ ML บน Production ต้องการมากกว่าแค่ health check
Health check ถามว่า:
“เซิร์ฟเวอร์ยังทำงานอยู่ไหม?”
Model monitoring ถามว่า:
“โมเดลยังทำได้ดีอยู่ไหม?”
สองคำถามนี้ไม่เหมือนกันเลย
เซิร์ฟเวอร์อาจแข็งแรง 100% ขณะที่คุณภาพโมเดลลดลงทุกวัน
ระบบจริงจึงต้องมี request logging, prediction monitoring และ — เมื่อ ground truth มาถึง — นำมาเทียบกลับกับสิ่งที่ทำนายไว้
เพราะการที่ API ยังทำงานอยู่ ไม่ได้แปลว่า AI ยังดีอยู่
2. Metrics ที่สอดคล้องกับเงิน#
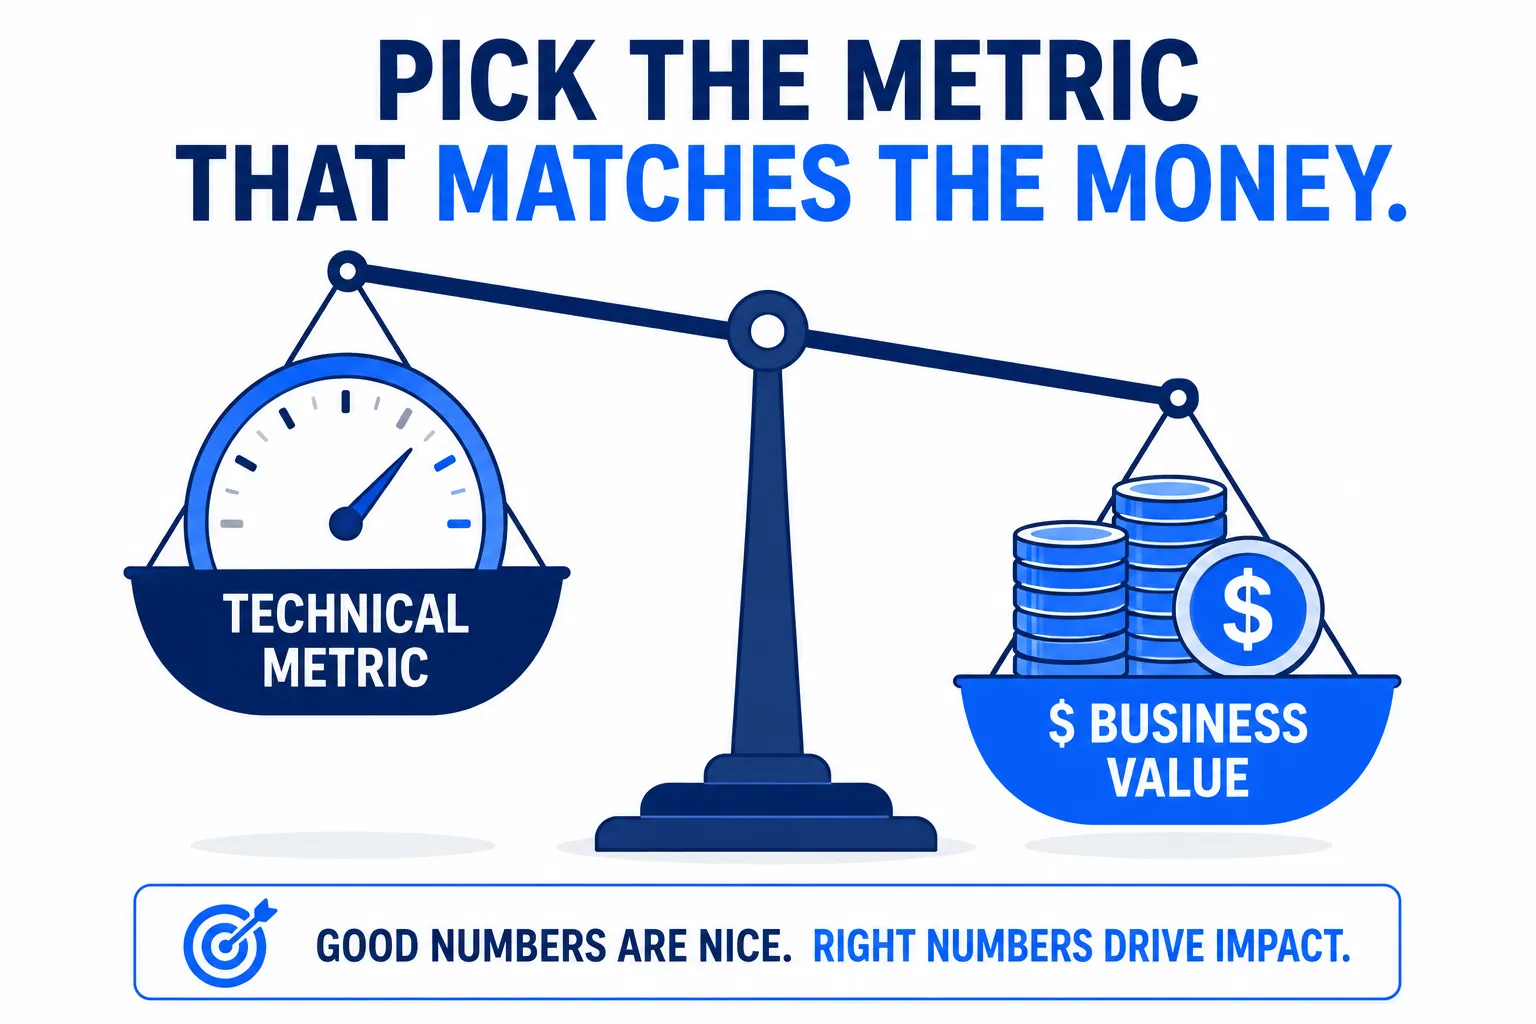
อีกสิ่งที่เปลี่ยนไปเมื่อ Machine Learning ออกจากห้องเรียน: metric ที่ดีที่สุดในเชิงเทคนิคอาจไม่ใช่ metric ที่สำคัญที่สุดต่อธุรกิจ
2.1 Accuracy โกหกเมื่อข้อมูลไม่สมดุล#
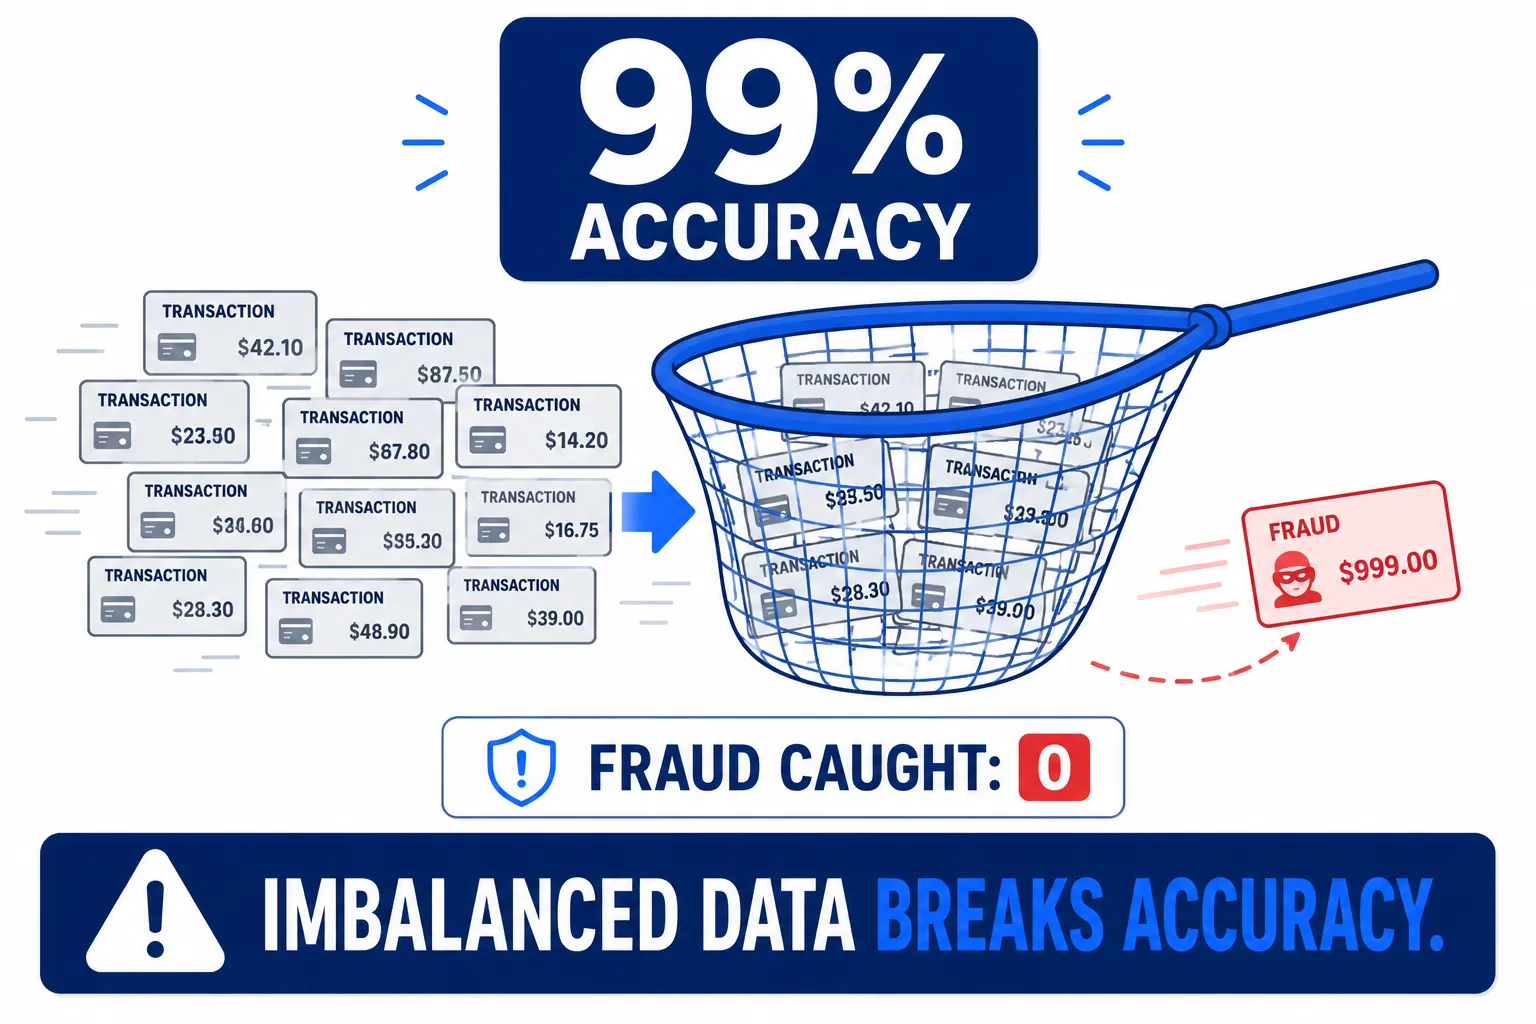
เริ่มจากตัวที่คุ้นที่สุด: Accuracy
สมมติมีธุรกรรม 10,000 รายการ และมีเพียง 1% — คือ 100 รายการ — ที่เป็นการฉ้อโกง
สร้าง “โมเดล” ง่าย ๆ ที่ตอบเหมือนเดิมทุกครั้ง:
“ไม่ฉ้อโกง”
มันถูก 9,900 จาก 10,000 ครั้ง
ดังนั้น:
Accuracy = 99%
ฟังดูยอดเยี่ยม
แต่โมเดลนี้จับการฉ้อโกงได้:
0
ไม่ได้สักรายการเดียว
พิสูจน์ด้วย fraud.csv:
amount,num_last_hour,new_device,night,fraud
120,2,0,0,0
45,1,0,1,0
8900,1,1,1,1
230,0,0,0,0
60,3,0,1,0
150,1,0,0,0
75,2,0,1,0
310,0,0,0,0
99,1,0,1,0import pandas as pd
from sklearn.dummy import DummyClassifier
df = pd.read_csv("fraud.csv")
X = df.drop(columns="fraud")
y = df["fraud"]
always_safe = DummyClassifier(strategy="most_frequent").fit(X, y)
print("accuracy :", always_safe.score(X, y)) # 0.888… (8 จาก 9)
print("fraud caught :", always_safe.predict(X).sum()) # 0เก้าแถวมีฉ้อโกงแค่หนึ่ง — ตอบ “ปลอดภัย” ทุกครั้งได้ accuracy สูงแต่ จับฉ้อโกงได้ศูนย์ เป็นเวอร์ชันจิ๋วของเรื่อง 99% ข้างบน
นี่คือปัญหาของ Accuracy เมื่อข้อมูลมี class imbalance — คือจำนวนตัวอย่างในแต่ละคลาสต่างกันมาก
2.2 Confusion Matrix: เห็นทุกทางที่โมเดลผิดได้#
แทนที่จะดูแค่ Accuracy อย่างเดียว ให้ดูผลลัพธ์ที่เป็นไปได้ทั้งสี่แบบ
| โมเดลบอก FRAUD | โมเดลบอก SAFE | |
|---|---|---|
| จริง ๆ คือฉ้อโกง | ✅ จับได้ | ❌ พลาดฉ้อโกง |
| จริง ๆ คือปลอดภัย | ❌ แจ้งเตือนผิด | ✅ ถูกต้อง |
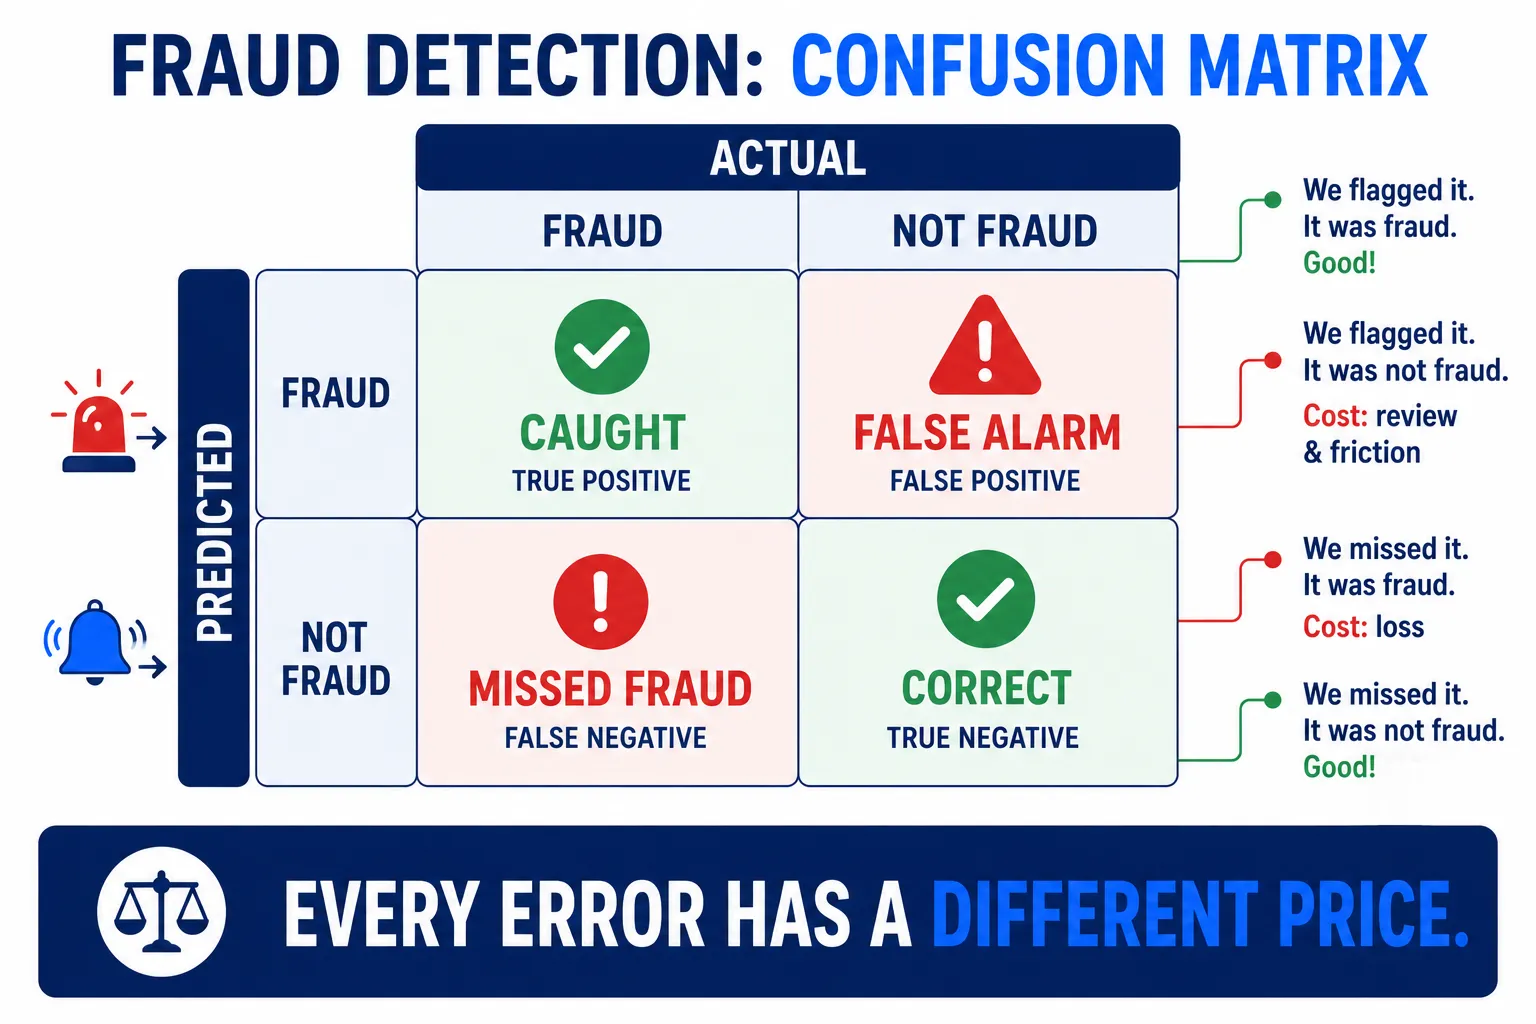
จากตรงนี้มีสอง metric ที่สำคัญ: Precision และ Recall
Precision ถามว่า:
“ทุกครั้งที่โมเดลแจ้งเตือนว่าฉ้อโกง มีกี่ครั้งที่เป็นฉ้อโกงจริง?”
Precision สูงแปลว่าการแจ้งเตือนมักถูก มีการแจ้งเตือนผิดน้อย
Recall ถามว่า:
“จากการฉ้อโกงที่เกิดขึ้นจริงทั้งหมด โมเดลจับได้กี่เปอร์เซ็นต์?”
Recall สูงแปลว่ามีฉ้อโกงหลุดรอดไปน้อย
2.3 นึกภาพแหจับปลา — Precision กับ Recall#
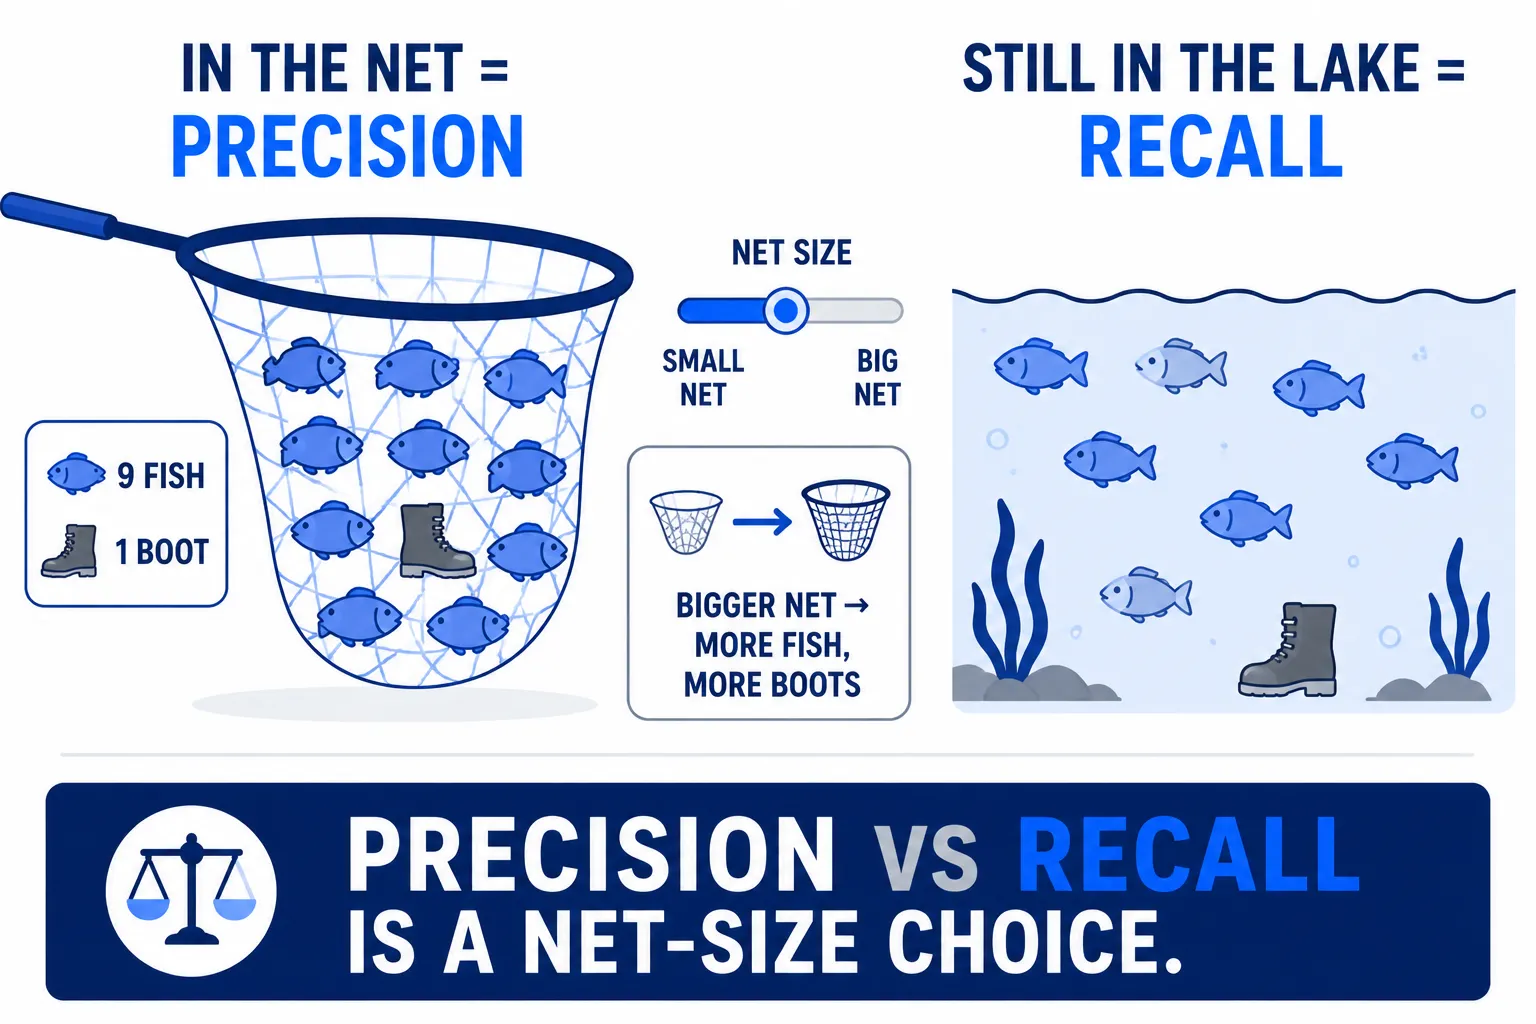
ลองนึกภาพการจับปลาด้วยแหในบึง
Precision ถามว่า:
จากทุกอย่างที่ติดแหมา กี่เปอร์เซ็นต์เป็นปลาจริง ๆ?
ถ้าแหมีปลา 9 ตัวกับรองเท้าบูต 1 ข้าง precision ก็ยอดเยี่ยม
Recall ถามว่า:
จากปลาทั้งหมดในบึง จับได้กี่เปอร์เซ็นต์?
การจะจับปลาให้ได้มากขึ้น วิธีหนึ่งคือใช้แหใหญ่ขึ้น
จับปลาได้มากขึ้น → Recall เพิ่ม
แต่ก็ติดของอย่างอื่นมามากขึ้นด้วย → Precision อาจลด
นี่คือ trade-off ระหว่าง Precision–Recall ที่พบบ่อยมาก
2.4 Threshold คือปุ่มหมุนที่จูน trade-off#
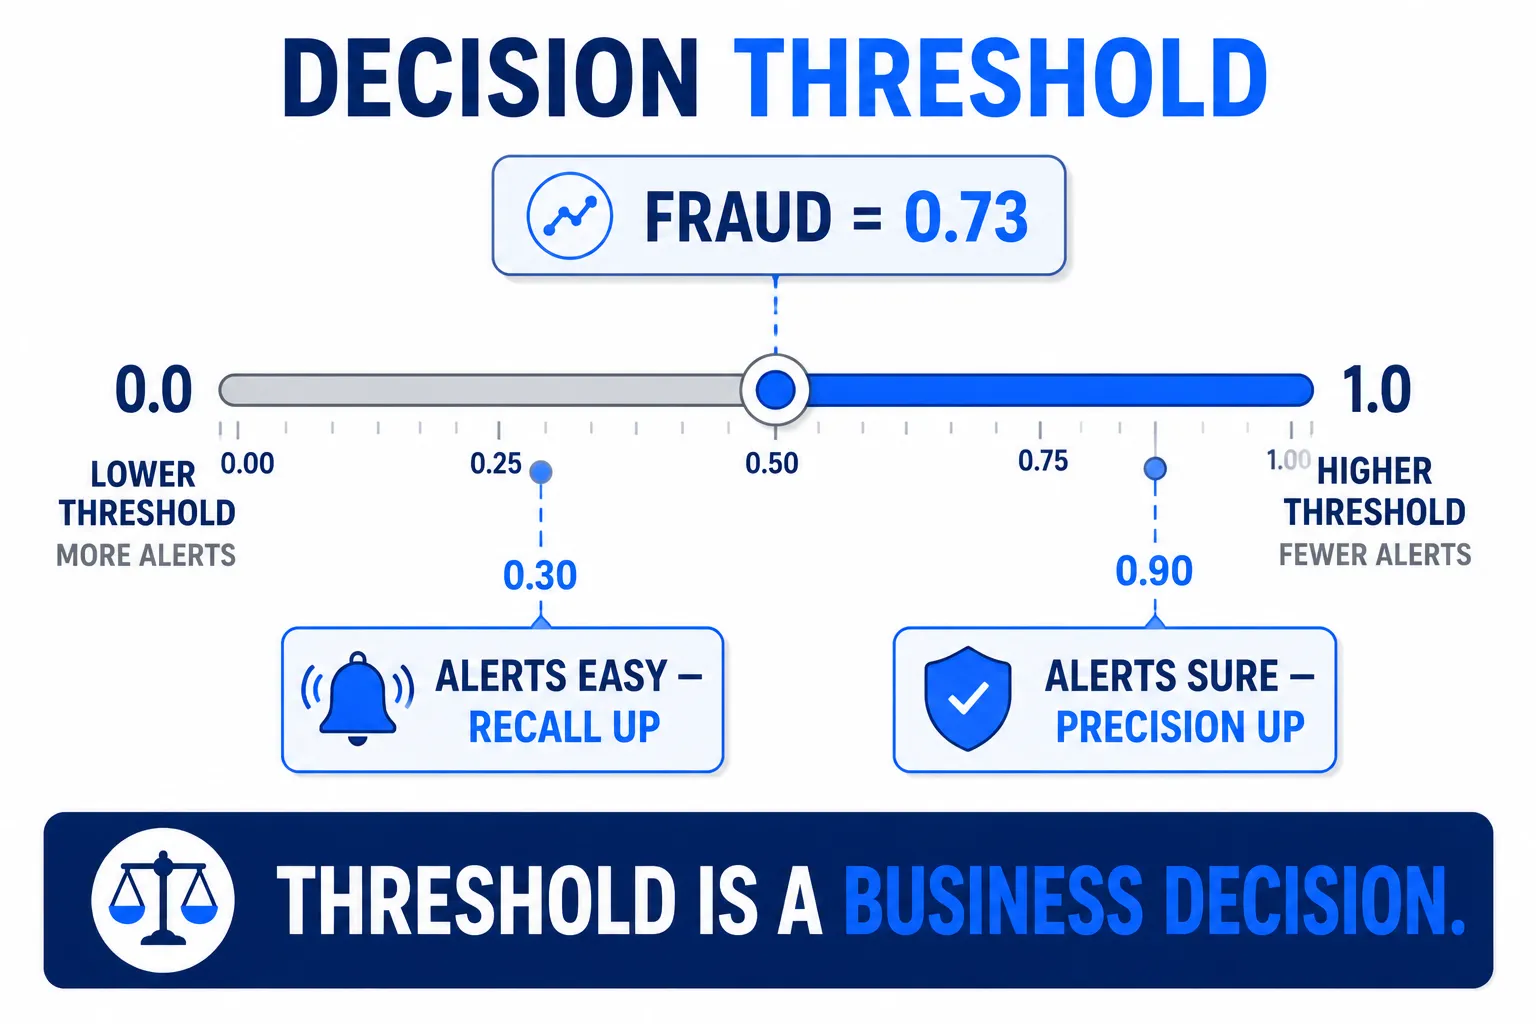
โมเดลจำแนกส่วนใหญ่ไม่ได้เริ่มด้วยคำว่า Fraud หรือ Safe
มันให้ คะแนนหรือความน่าจะเป็น ออกมา เช่น:
Fraud probability = 0.73
แล้วจึงเลือก Threshold:
if probability >= 0.50 → FRAUD
if probability < 0.50  → SAFE
ลด threshold เป็น 0.30
โมเดลก็แจ้งเตือนง่ายขึ้น
Recall มักเพิ่ม แต่ false positive ก็มักเพิ่มด้วย
เพิ่ม threshold เป็น 0.90
โมเดลก็แจ้งเตือนเฉพาะเคสที่มั่นใจมากเท่านั้น
Precision มักเพิ่ม แต่ฉ้อโกงบางส่วนหลุดรอด Recall จึงลด
Threshold จึงไม่ใช่แค่ตัวเลขทางคณิตศาสตร์ — มันคือ การตัดสินใจทางธุรกิจ
| Metric | เหมาะเมื่อ |
|---|---|
| Accuracy | คลาสค่อนข้างสมดุล และ error แต่ละแบบราคาพอ ๆ กัน |
| Precision | false positive แพง เช่น การบล็อกลูกค้าดี |
| Recall | false negative แพง เช่น พลาดฉ้อโกงหรือพลาดโรค |
| F1 Score | ต้องการตัวเลขเดียวสรุป Precision และ Recall |
| ROC-AUC | ความสามารถในการจัดอันดับ/แยกแยะข้ามหลาย threshold สำคัญ |
| RMSE / MAE | Regression — ทำนายตัวเลขต่อเนื่อง |
แต่สิ่งที่สำคัญกว่าการท่องตารางนี้:
ธุรกิจเป็นคนตัดสินว่า error แบบไหนแพงกว่ากัน
สมมติว่าฉ้อโกงที่หลุดไปหนึ่งครั้งสร้างความเสียหายเฉลี่ย $10,000
แต่การบล็อกลูกค้าดีผิดหนึ่งคนอาจเสียแค่การโทรหา support
กรณีนี้ ยอมรับ false positive มากขึ้นเพื่อแลกกับ recall ที่สูงขึ้นคือทางเลือกที่ถูกต้อง
เพราะเป้าหมายจริงไม่ใช่ metric ที่สวยที่สุด
แต่คือ การลดต้นทุนหรือสร้างคุณค่าให้ระบบโดยรวม
2.5 โมเดล Precision 30% ก็ยังทำเงินได้#
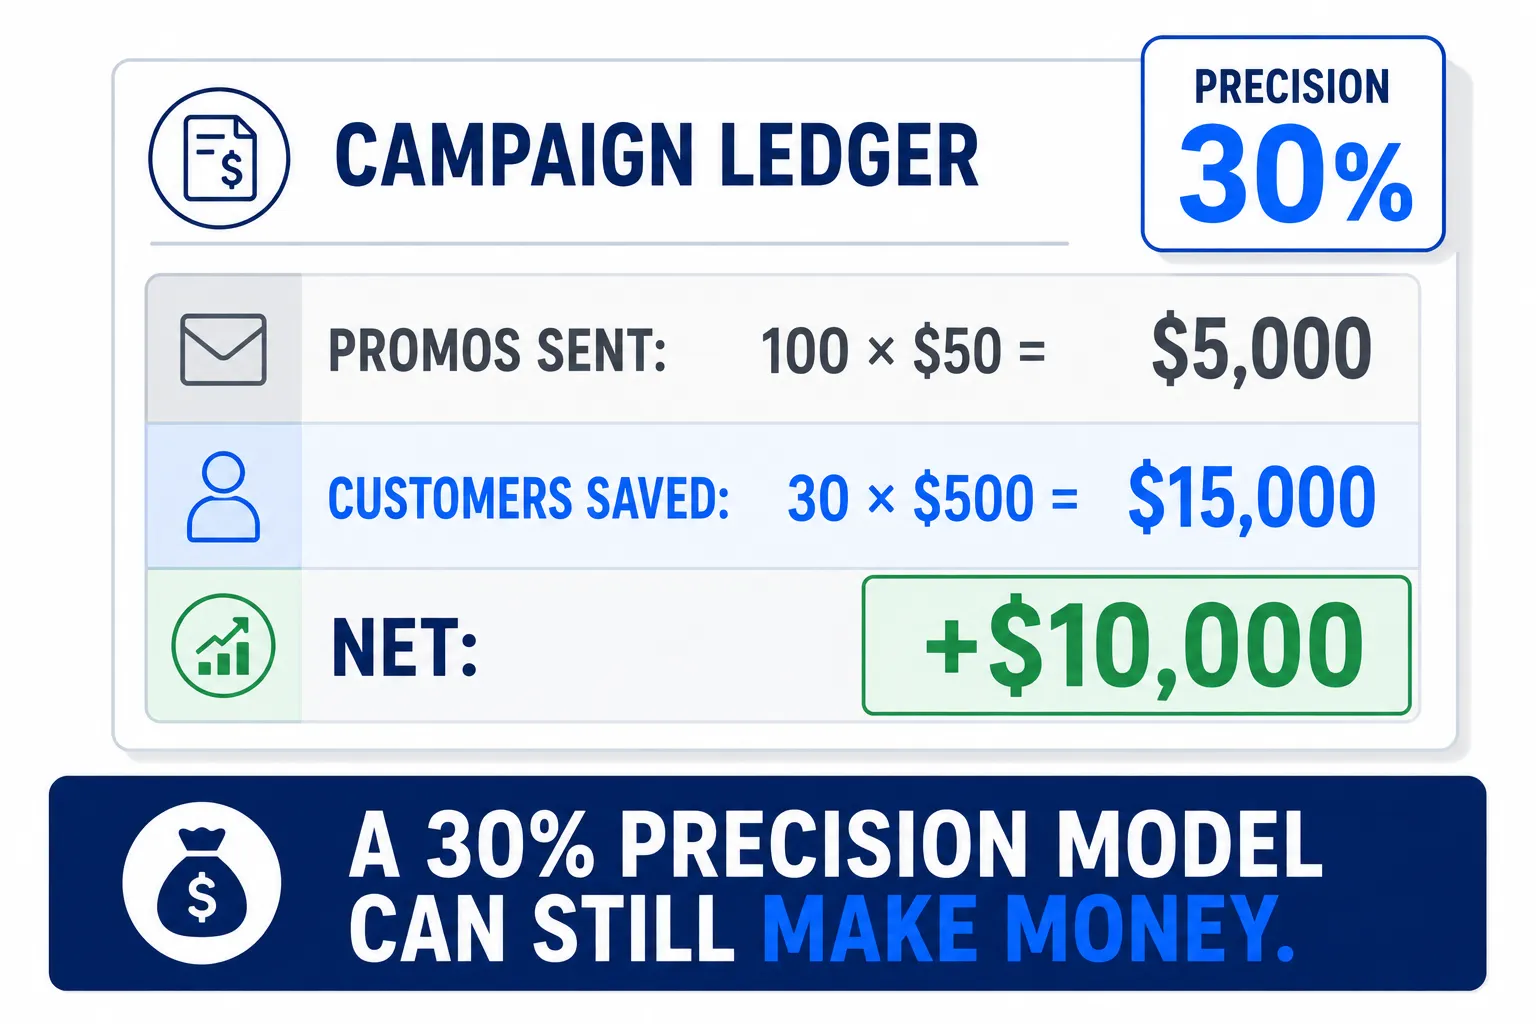
สมมติโมเดล customer churn
โมเดลเลือกลูกค้า 100 คนที่มีแนวโน้มจะยกเลิก และบริษัทส่งโปรโมชัน $50 ให้แต่ละคน
ต้นทุนคือ:
100 × $50 = $5,000
ปรากฏว่าใน 100 คนนั้น มีเพียง 30 คนที่กำลังจะเลิกจริง
Precision จึงเป็นแค่:
30 / 100 = 30%
ฟังดูแย่
แต่สมมติว่าลูกค้าที่รักษาไว้ได้แต่ละคนมีมูลค่า $500
มูลค่าที่รักษาไว้คือ:
30 × $500 = $15,000
หักต้นทุนโปรโมชัน:
$15,000 - $5,000 = +$10,000
โมเดลที่ Precision แค่ 30% เพิ่งสร้างมูลค่าสุทธิ $10,000
นี่คือเหตุผลที่ไม่ควรเลือกโมเดลจาก metric อย่างเดียว
Metric ไม่ใช่เป้าหมายสุดท้ายทางธุรกิจ — มันเป็นตัวช่วยตัดสินใจ
โมเดลที่ metric สวยงามแต่ไม่สร้างคุณค่าเลยอาจไร้ประโยชน์
ในทางกลับกัน โมเดลที่ metric ดูธรรมดาแต่สร้างรายได้ ลดความเสียหาย หรือประหยัดต้นทุนได้จริง อาจเป็นตัวที่ควรค่าแก่การ deploy
สรุป#
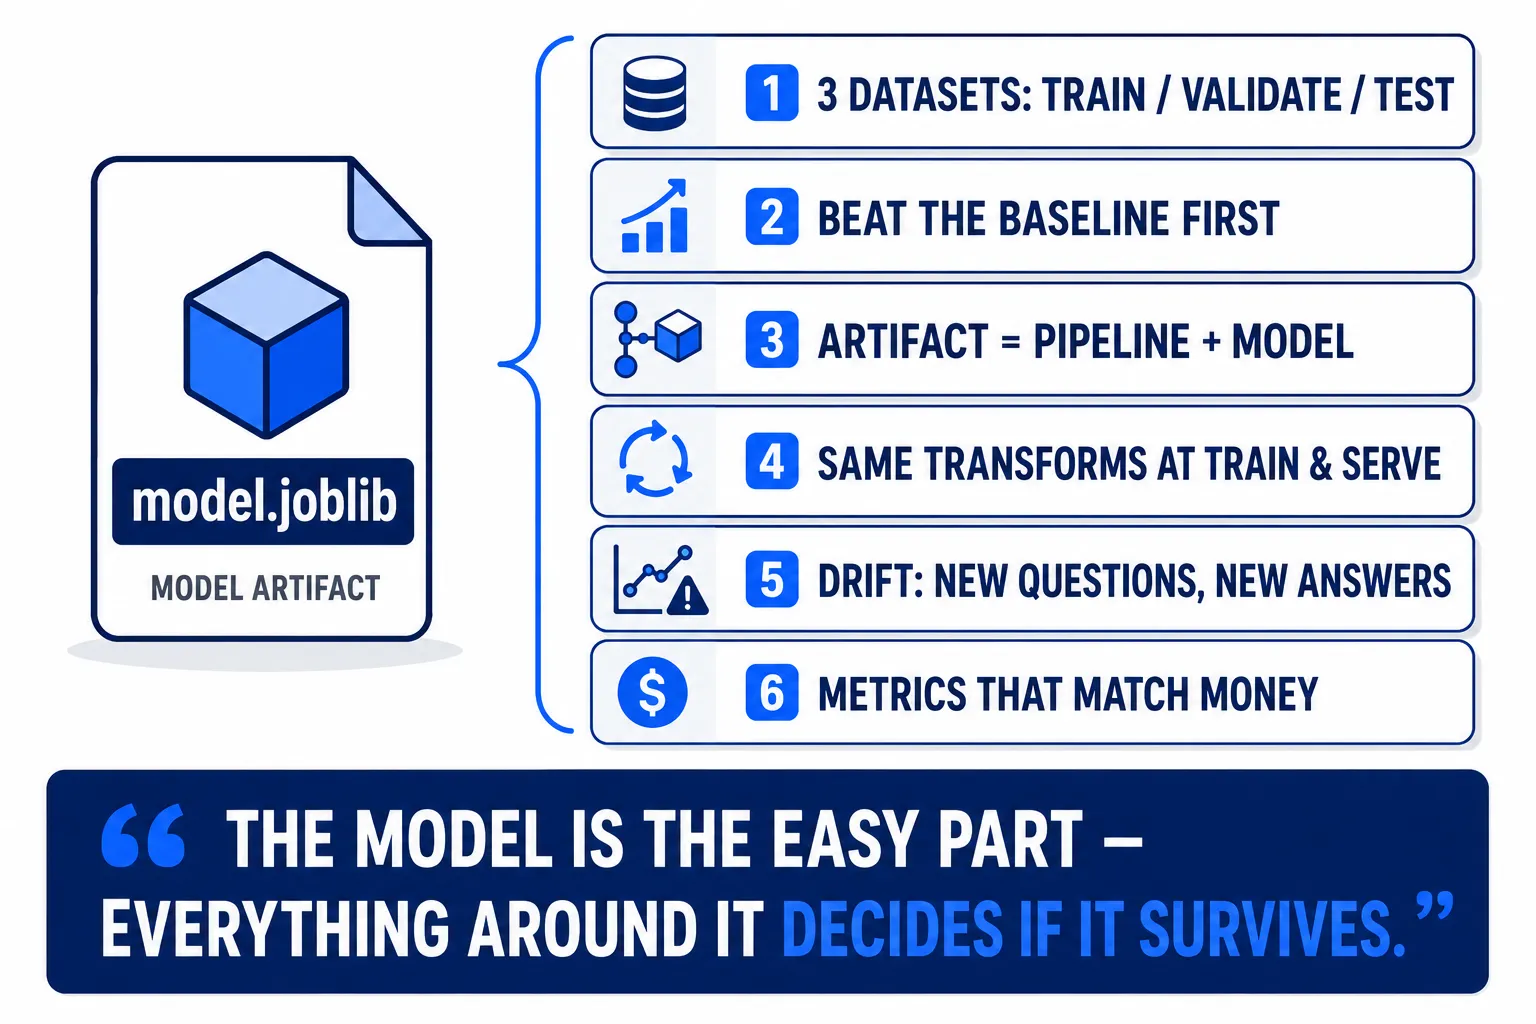
ถ้าจะเก็บประโยคเดียวจากพาร์ตนี้ไป ขอให้เป็นประโยคนี้:
บน Production ข้อสอบที่ไม่มีวันจบ — โมเดลตอบคำถามใหม่ไปเรื่อย ๆ ตลอดกาลโดยมักไม่มีเฉลย งานจึงเปลี่ยนจาก การให้คะแนนโมเดล ไปเป็น การเฝ้าดูโมเดล
แผนที่ของพาร์ตนี้ไว้อ้างอิง:
- ข้อสอบที่ไม่มีวันจบ: ทุก request คือคำถามใหม่ที่ไม่มีเฉลย — ground truth มาช้าหรือไม่มา ความแม่นบน Production จึงเห็นยากกว่าคะแนนใน notebook มาก
- เร็วและถูกก็สำคัญ: เมื่อ
predict()ไปอยู่ใน API แล้ว trade-off กลายเป็น Prediction Quality ↔ Latency ↔ Cost — โมเดลที่แม่นที่สุดไม่ได้เป็นตัวที่ควร ship โดยอัตโนมัติ - Overfitting vs. leakage: ทั้งคู่ดูดีตอนพัฒนาแต่ล้มตอนใช้จริง — overfitting จำข้อมูลเทรน (train ดี, test แย่), leakage เห็นเฉลย (train และ test ดีจนน่าสงสัยทั้งคู่)
- คำถามเดียวจับ leakage: ทุกฟีเจอร์ถามว่า “ณ วินาทีที่ต้องทำนาย ค่านี้รู้อยู่แล้วไหม?” — ถ้ายังไม่รู้ ก็ต้องไม่เป็น input
- โมเดล decay อย่างเงียบ ๆ: Data Drift คือโจทย์ใหม่, Concept Drift คือคำตอบใหม่ของโจทย์เดิม — เซิร์ฟเวอร์อาจเขียวอยู่ (
200 OK, latency ต่ำ) ขณะที่การทำนายค่อย ๆ เน่า จึงต้อง monitor ข้อมูล ไม่ใช่แค่เครื่อง - Metrics ผูกกับเงิน: accuracy โกหกเมื่อ class imbalance, Precision/Recall คือการเลือกว่า error แบบไหนแพงกว่า, threshold คือปุ่มหมุนทางธุรกิจ — และโมเดล precision 30% ก็ยังคุ้มค่าแก่การ deploy ได้ถ้ามูลค่าที่ประหยัดได้มากกว่าต้นทุน