ML Refresher — ทบทวน ML ก่อนขึ้น Production
ติดตั้ง Python, venv, Jupyter แล้วทบทวน ML ก่อนขึ้น Production — baseline, feature schema, train/serve skew, drift และ metrics ที่สอดคล้องกับธุรกิจ
ML Refresher#
บทความนี้ถือว่าผู้อ่านเคยผ่านพื้นฐาน Machine Learning มาแล้ว จึงไม่ย้อนกลับไปปูพื้นฐาน ML ใหม่ทั้งหมด
สิ่งที่จะทบทวนคือแนวคิดที่ สำคัญตอนเอาโมเดลขึ้น Production โดยมองทุกเรื่องผ่านคำถามเดียวกันว่า:
“เรื่องนี้จะทำให้เกิดปัญหาอะไรหลัง Deploy?”
เพราะโมเดลที่ทำงานดีใน Notebook ไม่ได้แปลว่าจะทำงานดีเหมือนเดิมเมื่อเอาไป Serve ให้ผู้ใช้จริง
และเพราะทุกตัวอย่างในบทความนี้ออกแบบให้ลองตามได้จริงใน Notebook จุดเริ่มต้นจึงอยู่ที่การเตรียมเครื่องมือให้พร้อมก่อน
1. เตรียมเครื่องมือก่อนเริ่ม#
1.1 ติดตั้ง Python#
ดาวน์โหลดตัวติดตั้งได้ที่ python.org/downloads ↗ โดยเลือกเวอร์ชันล่าสุดของ Python 3
สำหรับ Windows ให้ติ๊ก “Add python.exe to PATH” ก่อนกด Install ไม่งั้นจะเรียก python จาก terminal ไม่ได้
บน Linux (Ubuntu) ติดตั้งผ่าน apt ได้เลย:
sudo apt update && sudo apt install python3เสร็จแล้วเปิด terminal แล้วตรวจสอบ:
python --versionถ้าโชว์เวอร์ชัน เช่น Python 3.12.x แปลว่าเรียบร้อย (บน Windows ถ้าใช้ python ไม่ได้ ลองเป็น py --version)
บน Linux ให้ใช้คำสั่ง
python3ไม่ใช่pythonเช่นpython3 --versionและpython3 -m venv .venvเพราะคำสั่งpythonเฉย ๆ อาจไม่มีในเครื่อง
1.2 สร้าง Virtual Environment#
ทำไมต้องมี Virtual Environment?
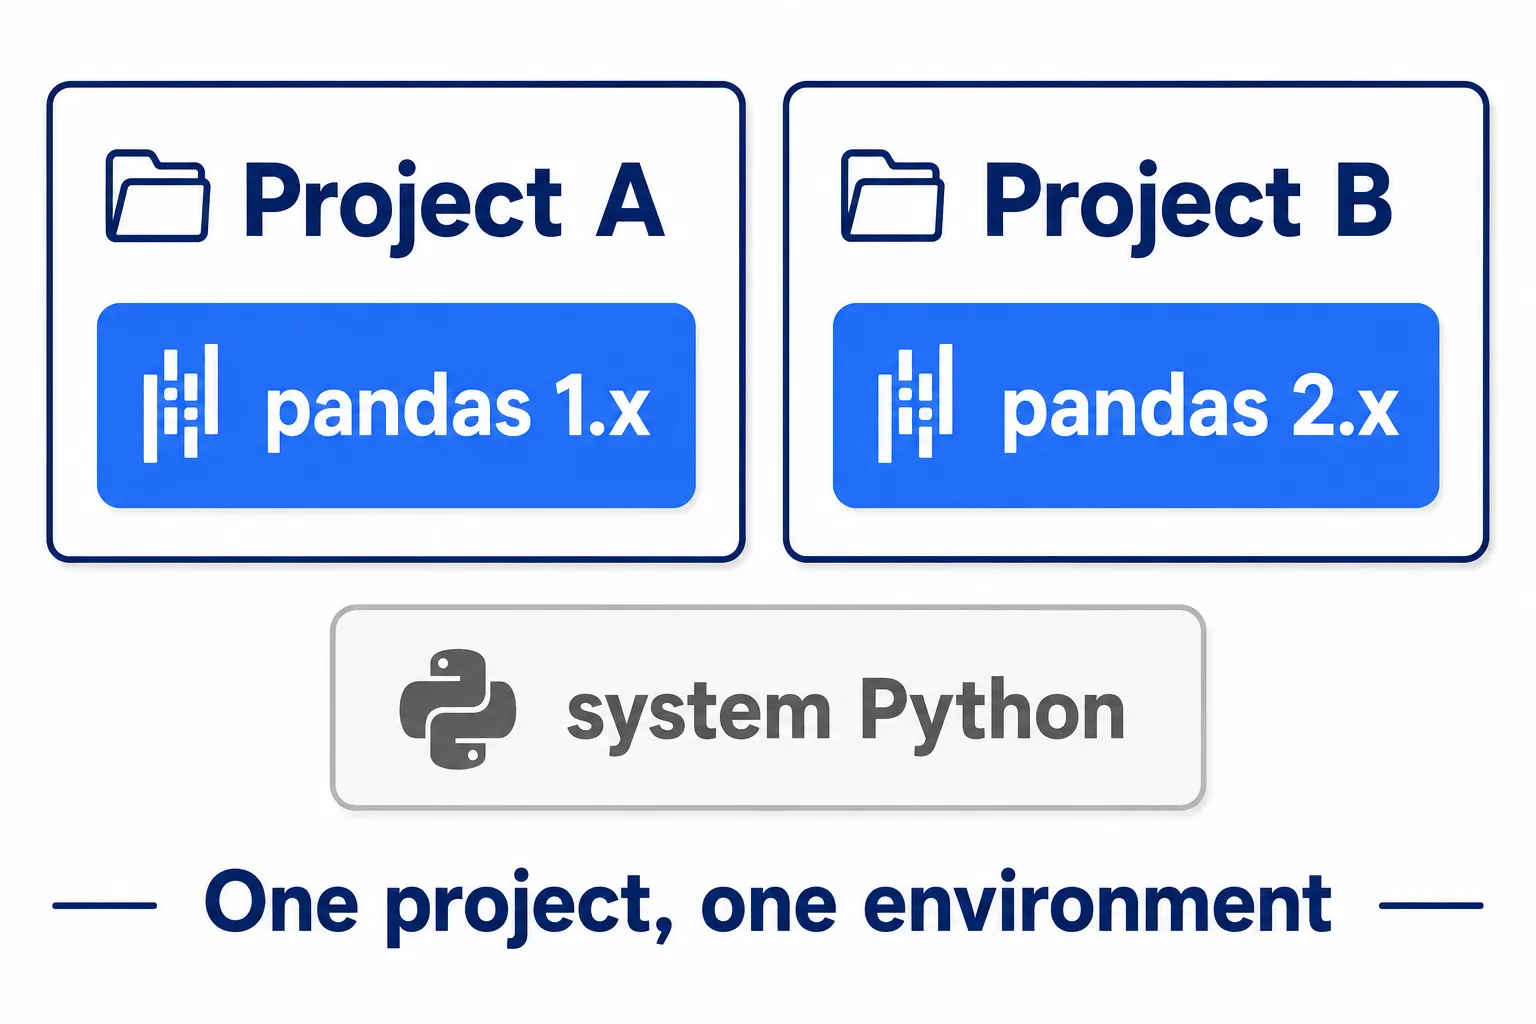
ถ้าติดตั้ง library ทุกอย่างลง Python กลาง ๆ เครื่อง วันหนึ่งโปรเจกต์ A ต้องการ pandas เวอร์ชันเก่า ส่วนโปรเจกต์ B ต้องการเวอร์ชันใหม่ แล้วทุกอย่างก็เริ่มพังพร้อมกัน
Virtual Environment จึงเป็นการสร้าง พื้นที่แยกให้แต่ละโปรเจกต์ — library ที่ติดตั้งจะอยู่ในโฟลเดอร์ของโปรเจกต์นั้น ๆ ไม่ปนกับโปรเจกต์อื่น
สร้างโฟลเดอร์โปรเจกต์แล้วรัน:
mkdir ml-refresher
cd ml-refresher

# สร้าง virtual environment ชื่อ .venv
python -m venv .venvจากนั้น activate:
Windows (PowerShell):
.venv\Scripts\activatemacOS / Linux:
source .venv/bin/activateเมื่อสำเร็จ หน้า terminal จะมี (.venv) โผล่ขึ้นมาข้างหน้า prompt — แปลว่าตอนนี้อยู่ในพื้นที่ของโปรเจกต์นี้แล้ว
ทุกครั้งที่กลับมาทำงานต่อ ต้อง activate ใหม่ทุกครั้ง ส่วน
deactivateใช้ตอนต้องการออกจาก environment
หมายเหตุ: ถ้า PowerShell แจ้งเตือนเรื่อง execution policy ให้รัน Set-ExecutionPolicy -ExecutionPolicy RemoteSigned -Scope CurrentUser หนึ่งครั้งแล้ว activate ใหม่
1.3 ติดตั้ง Jupyter Notebook, pandas และเพื่อน#
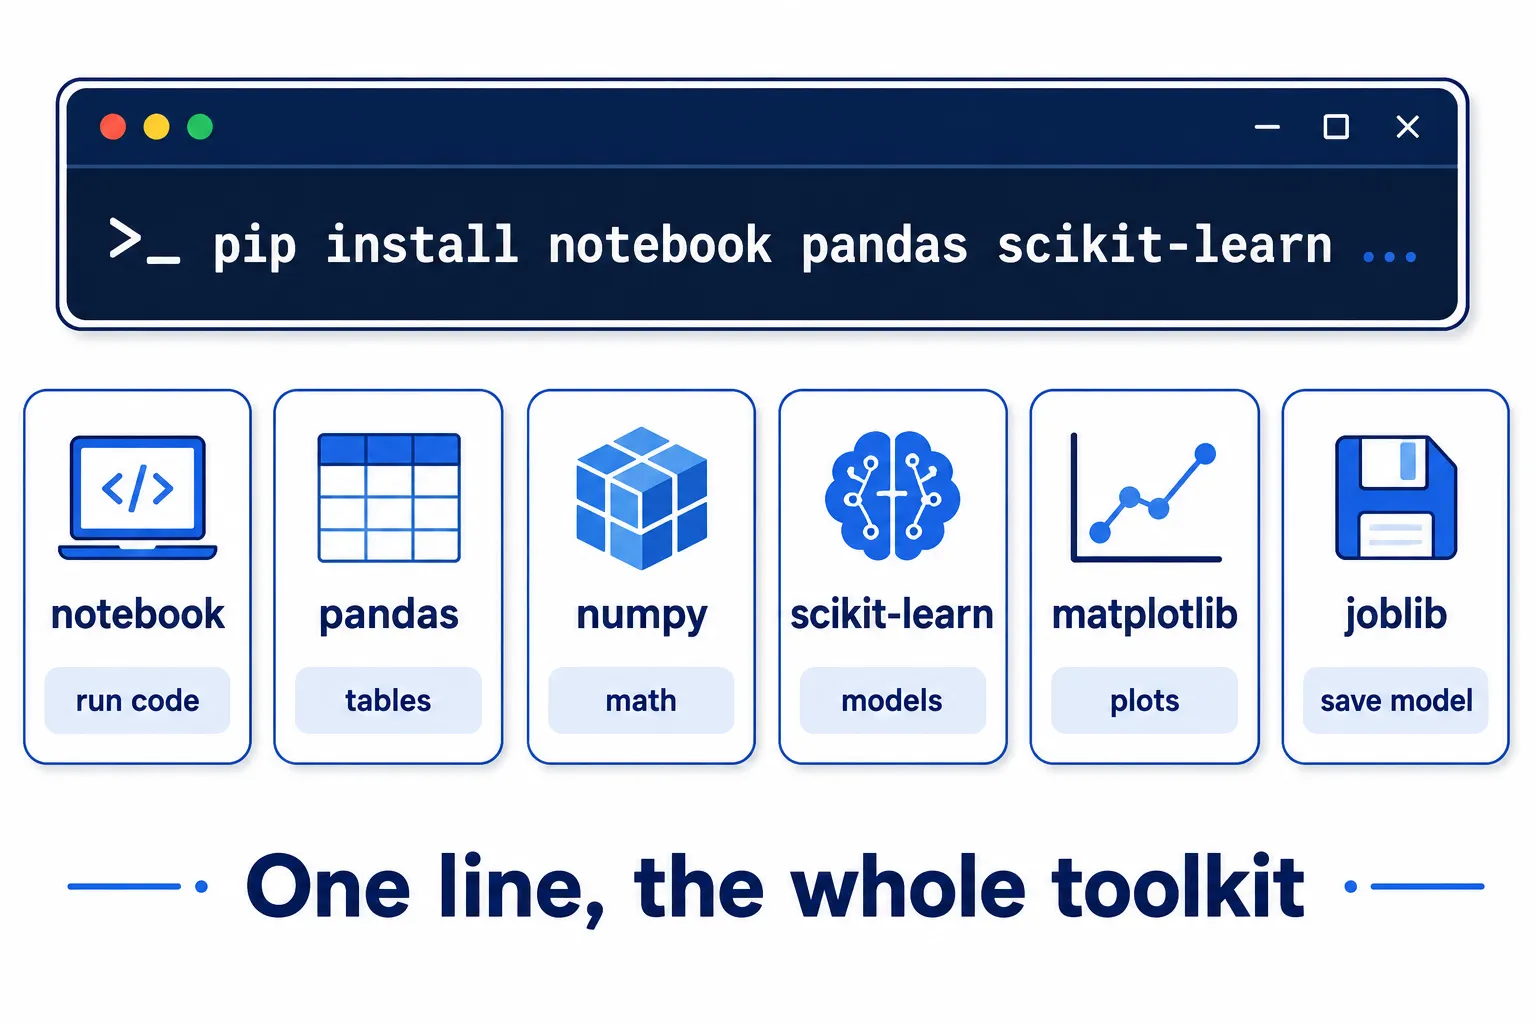
ตราบใดที่ยังเห็น (.venv) อยู่ ให้ติดตั้ง library ทั้งหมดที่ซีรีส์นี้จะใช้:
pip install --upgrade pip

pip install notebook pandas numpy scikit-learn matplotlib joblibหน้าที่ของแต่ละตัว:
| Library | ใช้ทำอะไร |
|---|---|
| notebook | ตัวติดตั้ง Jupyter Notebook — เขียนและรันโค้ดทีละช่วง เหมาะกับการทดลอง ML |
| pandas | จัดการข้อมูลตาราง (DataFrame) — อ่าน CSV, ล้างข้อมูล, แปลงรูปแบบ |
| numpy | คำนวณอาเรย์และคณิตศาสตร์ เป็นฐานใต้ pandas และ scikit-learn |
| scikit-learn | library ML หลัก — ตั้งแต่ preprocessing, โมเดล, ไปจนถึงการวัดผล |
| matplotlib | วาดกราฟดูการกระจายของข้อมูลและผลลัพธ์ |
| joblib | บันทึกโมเดลที่ train แล้วเป็นไฟล์ artifact (.joblib) |
1.4 เปิด Jupyter Notebook#
jupyter notebookBrowser จะเปิดหน้า Jupyter ขึ้นมาเอง ลองสร้าง Notebook ใหม่ (New → Python 3) แล้วรัน Cell แรกเพื่อยืนยันว่าติดตั้งครบ:
import sys
import pandas, numpy, sklearn, matplotlib, joblib

print(sys.version)
print("pandas       ", pandas.__version__)
print("numpy        ", numpy.__version__)
print("scikit-learn ", sklearn.__version__)ถ้าแสดงเวอร์ชันได้โดยไม่มี error แปลว่าเครื่องพร้อมแล้ว
1.5 บันทึกสภาพแวดล้อมด้วย requirements.txt#
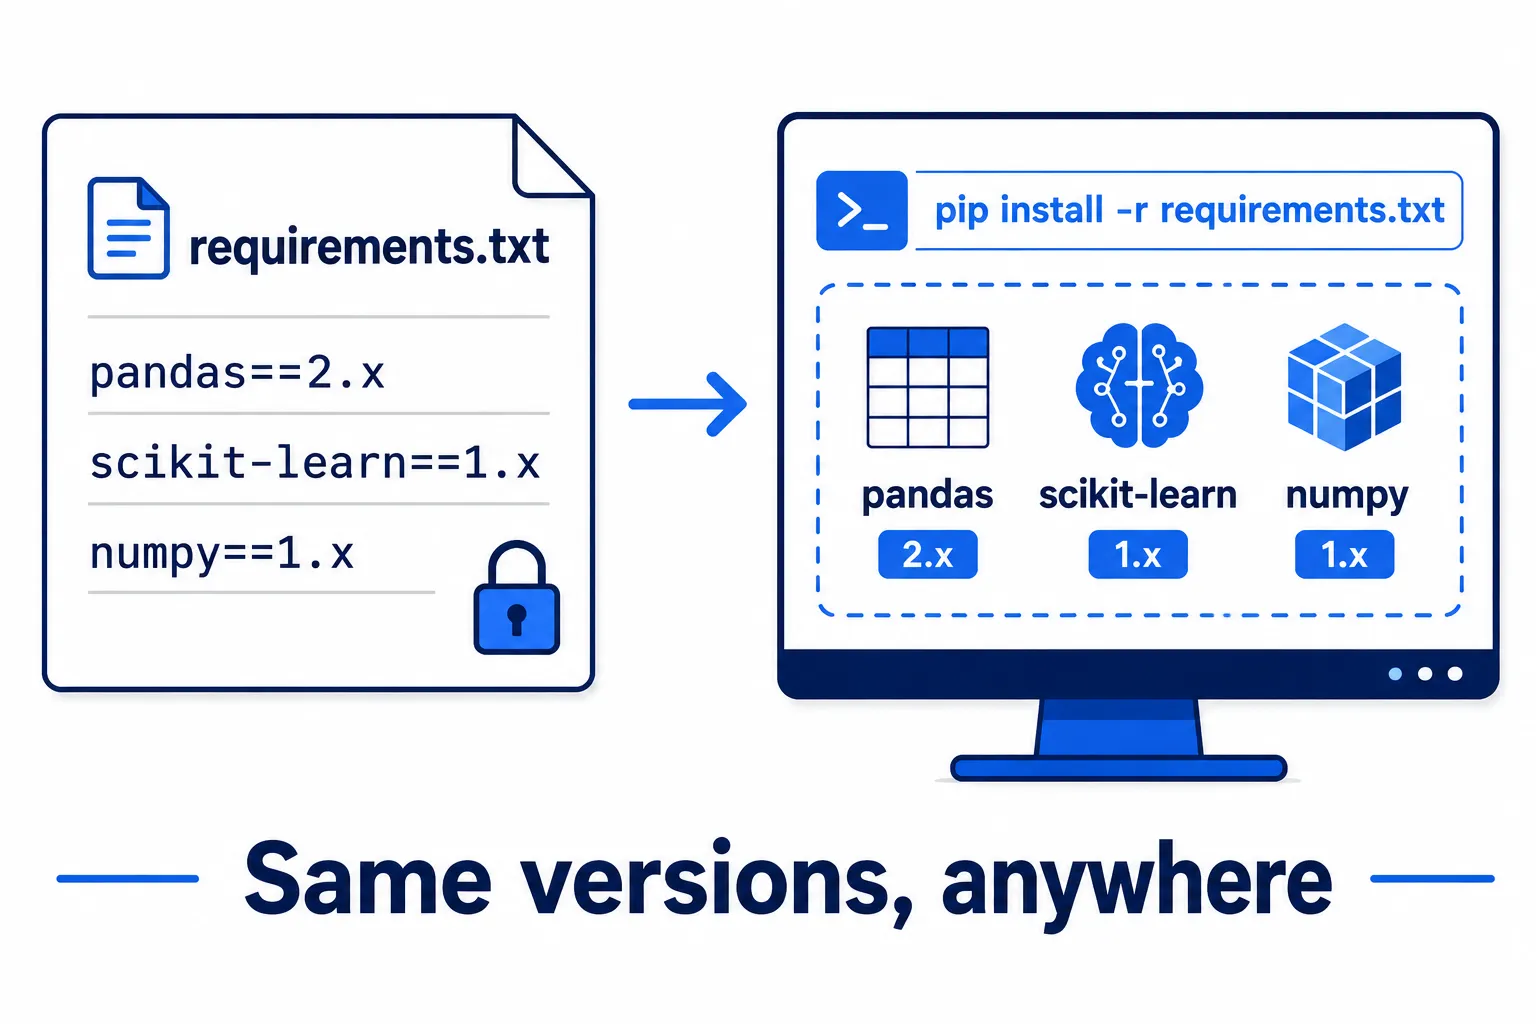
อีกนิสัยที่ควรทำตั้งแต่วันแรก:
pip freeze > requirements.txtไฟล์นี้เก็บรายชื่อและเวอร์ชันของ library ทุกตัวใน environment ปัจจุบัน ใครก็ตาม — รวมถึงเจ้าของโปรเจกต์เองในอนาคต หรือเครื่อง Production — สามารถสร้างสภาพแวดล้อมเหมือนเดิมได้ด้วย:
pip install -r requirements.txtสังเกตว่านี่คือแนวคิดเดียวกับเรื่อง Versioning ของ Model Artifact — ไม่ใช่แค่โมเดลที่ต้องรู้เวอร์ชัน สภาพแวดล้อมที่ใช้ train โมเดลก็ต้องถูกบันทึกและติดตามเหมือนกัน
เมื่อเครื่องมือพร้อมแล้ว ต่อจากนี้คือการทบทวนแนวคิด Machine Learning ที่สำคัญตอนขึ้น Production
2. ทบทวนพื้นฐาน Machine Learning#
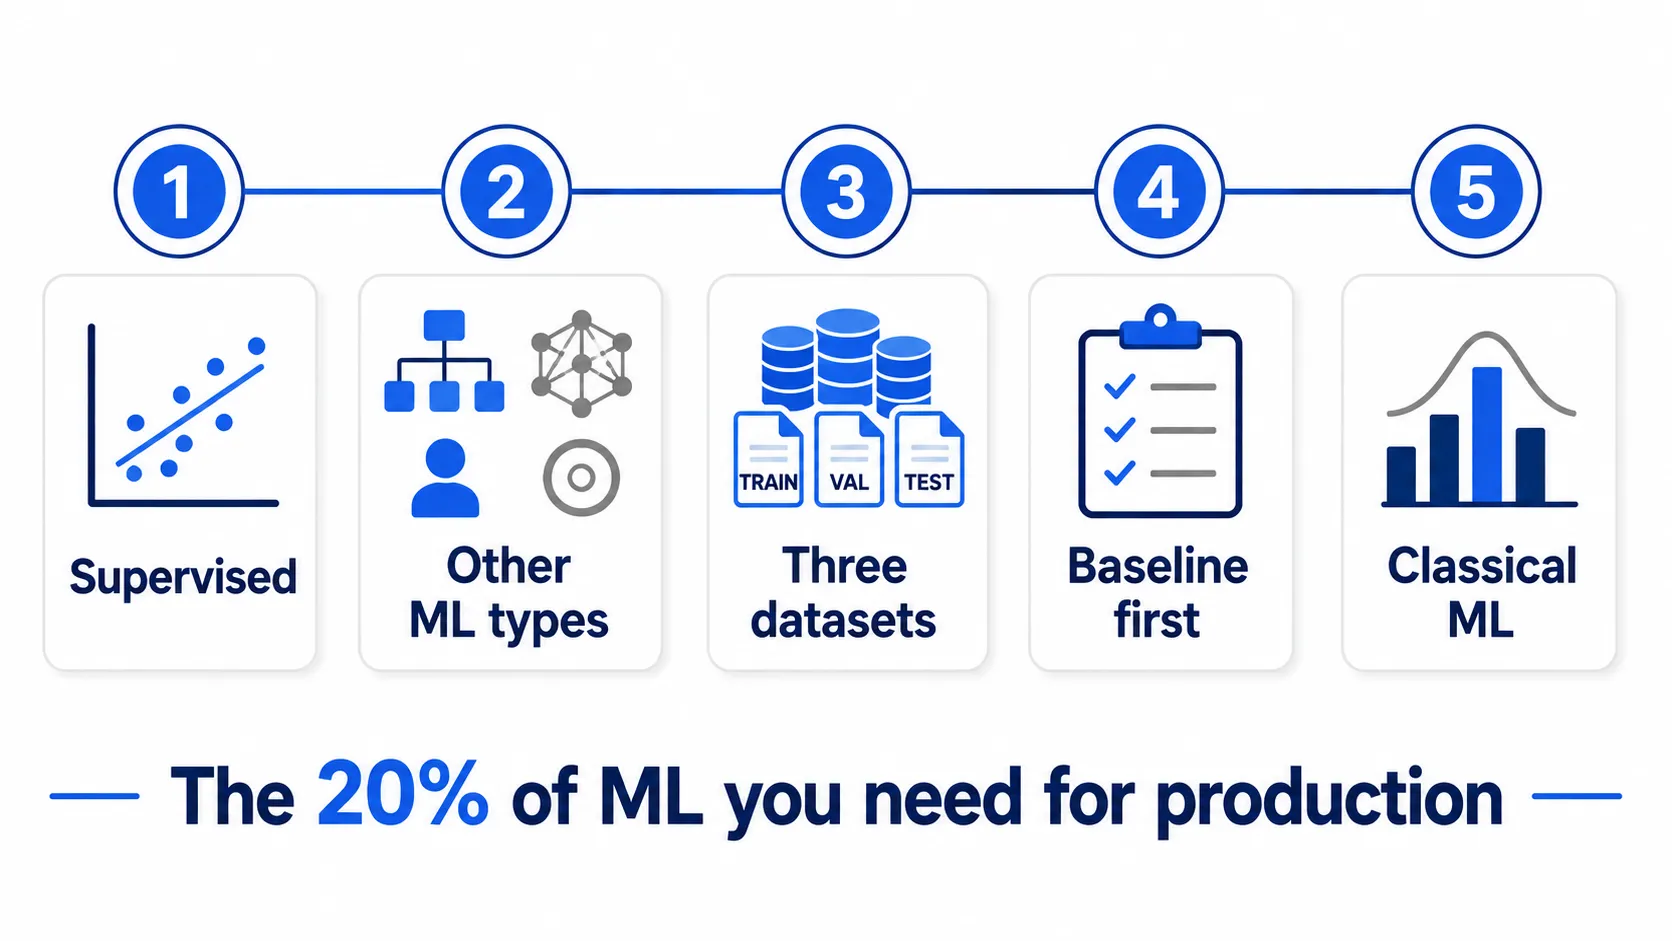
2.1 Supervised Learning ยังคงเป็นเครื่องมือหลัก#
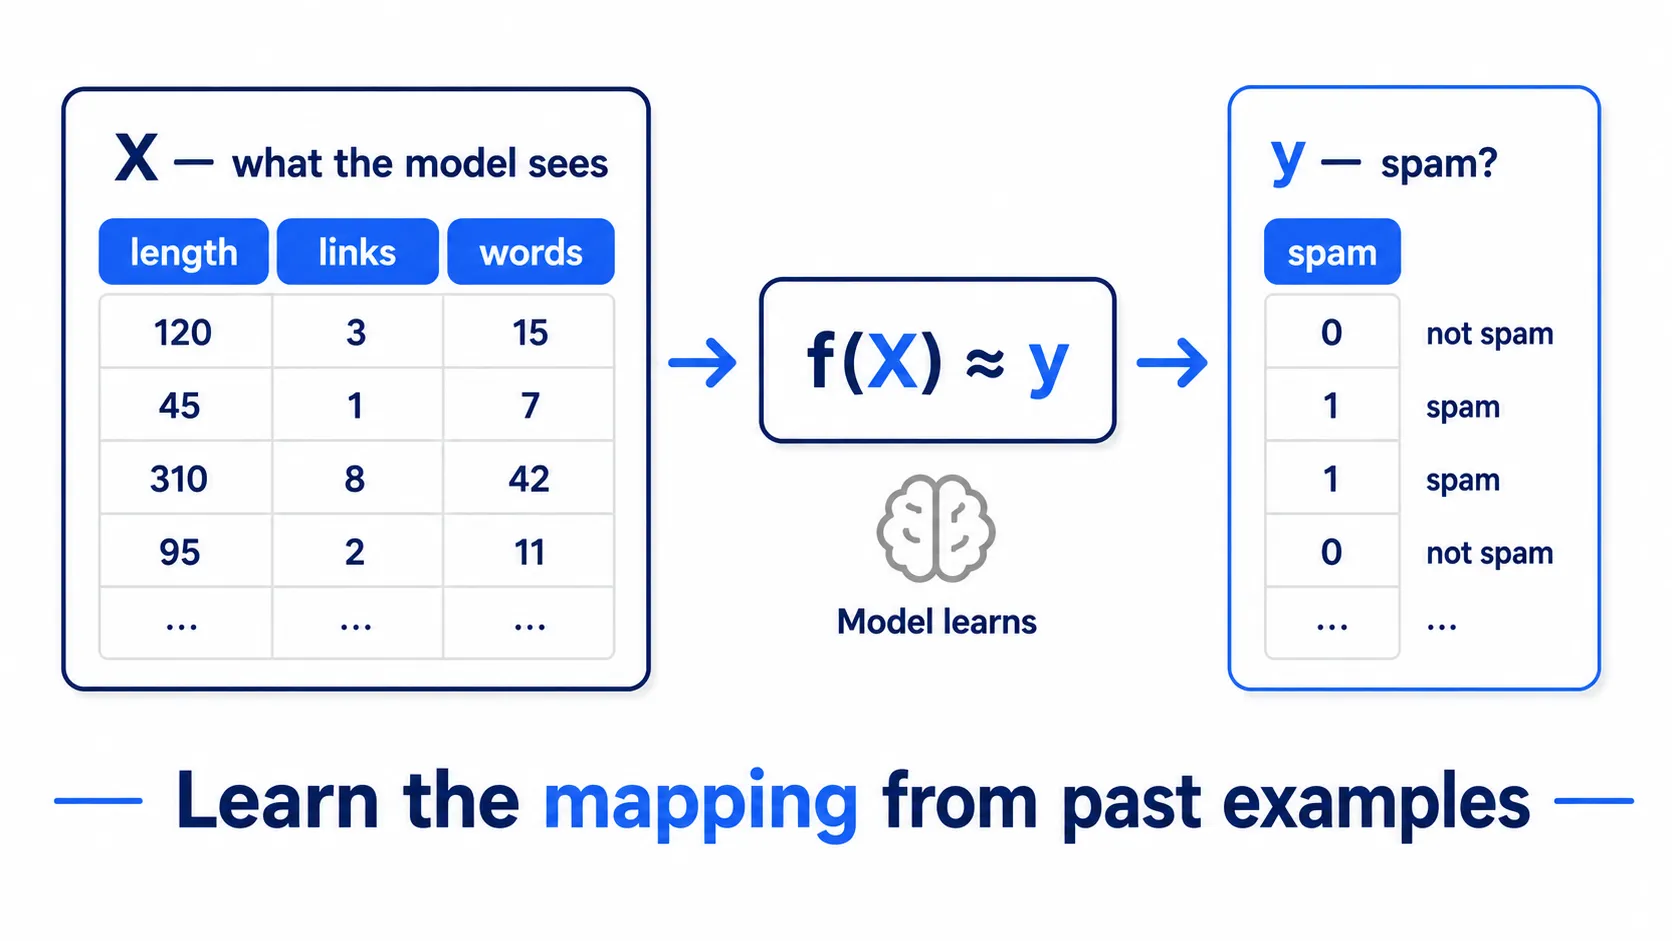
Supervised Learning คือการให้โมเดลเรียนรู้จากตัวอย่างในอดีตที่รู้คำตอบอยู่แล้ว
หัวใจของ Supervised Learning มีสองอย่าง:
-
X — Features คือข้อมูล Input ที่ป้อนให้โมเดลดู เช่น ความยาวของอีเมล จำนวนลิงก์ Domain ของผู้ส่ง หรือจำนวนคำบางประเภท
-
y — Labels คือเฉลยของแต่ละตัวอย่าง เช่น
spamหรือnot spam
พูดง่าย ๆ คือ:
X = ข้อมูลที่โมเดลใช้ดู y = คำตอบที่ต้องการให้โมเดลเรียนรู้
เพื่อให้จับต้องได้จริง ตลอดบทความนี้จะใช้ไฟล์ตัวอย่างเล็ก ๆ — สร้างไฟล์ spam.csv ในโฟลเดอร์เดียวกับ notebook (copy ไปบันทึกได้เลย):
length,num_links,num_capital_words,sender_domain_new,spam
420,0,1,0,0
380,1,0,0,0
510,0,2,0,0
290,0,0,0,0
600,1,2,0,0
440,0,1,0,0
350,1,0,0,0
470,0,2,0,0
530,3,8,1,1
400,0,0,0,0อ่านเข้ามาด้วย pandas:
import pandas as pd

df = pd.read_csv("spam.csv")
print(df.shape)   # (10, 5)
dfในไฟล์นี้ X คือ 4 คอลัมน์แรก และ y คือคอลัมน์ spam (0 = ไม่ใช่ spam, 1 = ใช่)
หน้าที่ของ Machine Learning Algorithm คือพยายามเรียนรู้ความสัมพันธ์ระหว่างสองอย่างนี้
เขียนแบบย่อได้ว่า:
f(X) ≈ y
หรือพูดเป็นภาษาคนก็คือ:
เมื่อเห็นข้อมูลแบบ X แล้ว ควรตอบ y ว่าอะไร?
ถ้า y เป็น กลุ่มหรือประเภท โจทย์นั้นเรียกว่า Classification
เช่น:
Email → Spam / Not Spam
แต่ถ้า y เป็น ค่าตัวเลขต่อเนื่อง จะเรียกว่า Regression
เช่น:
ข้อมูลบ้าน → ราคาบ้าน
2.2 แล้ว Machine Learning แบบอื่นล่ะ?#
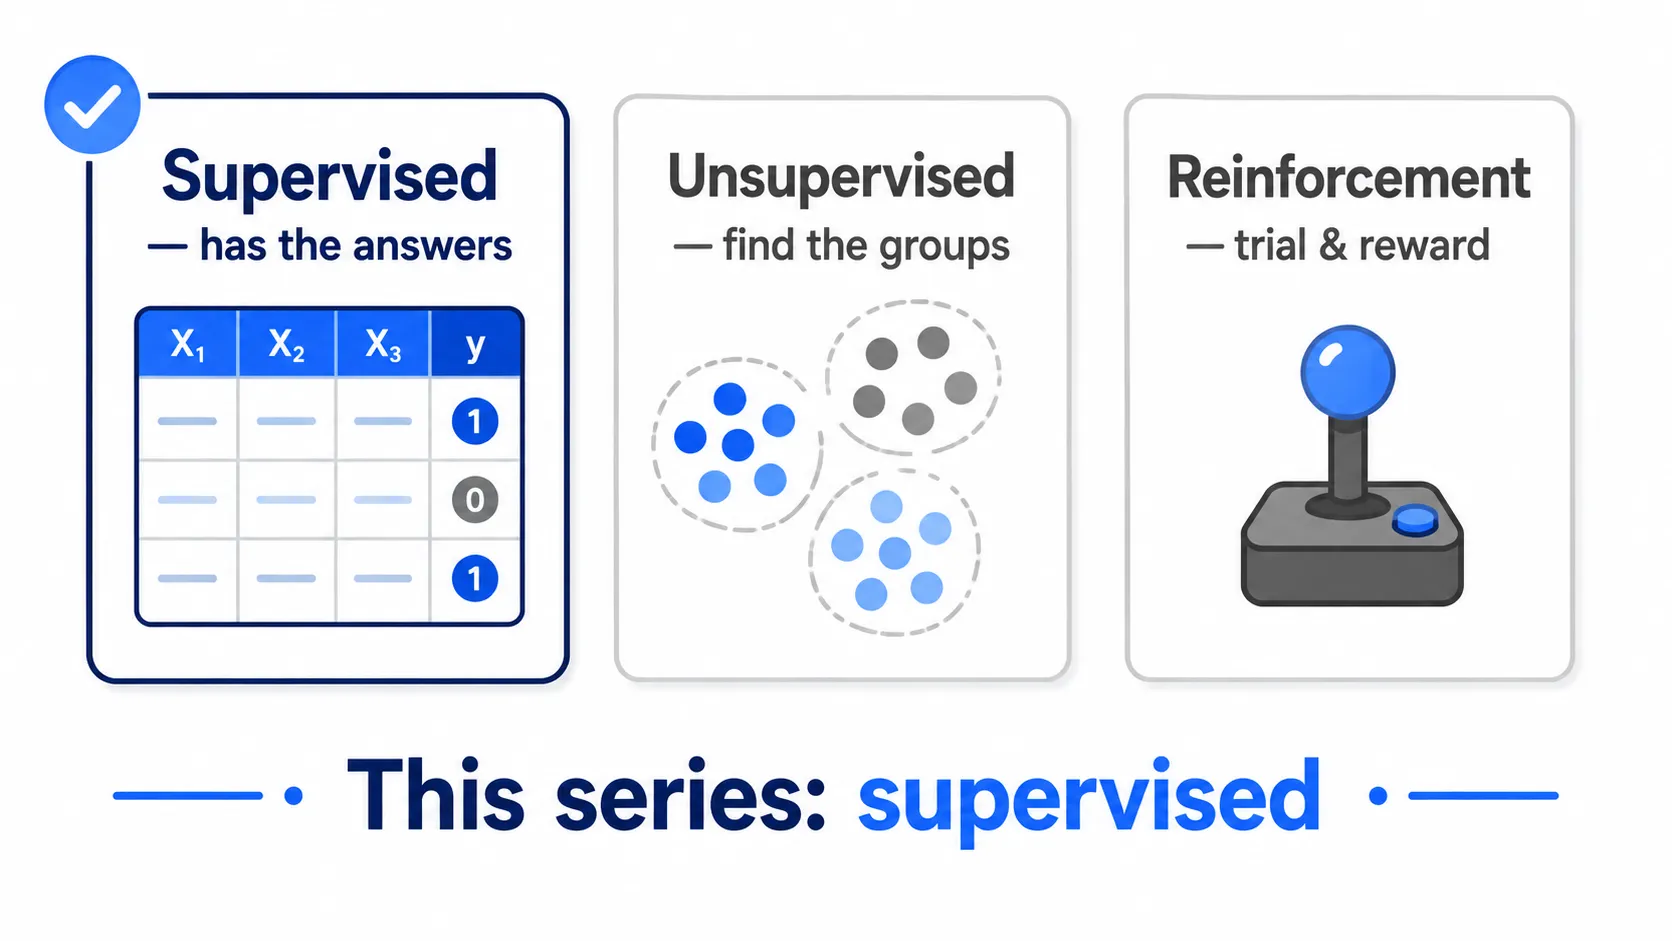
จริง ๆ แล้ว Machine Learning จำแนกใหญ่ ๆ ได้สามแบบ:
- Supervised Learning — มีตัวอย่างพร้อมเฉลย (มีทั้ง X และ y) เรียนรู้จากอดีตเพื่อทำนายอนาคต
- Unsupervised Learning — มีแค่ X ไม่มีเฉลย ใช้จับ Pattern หรือจัดกลุ่มข้อมูล เช่น Customer Segmentation หรือ Anomaly Detection
- Reinforcement Learning — เรียนรู้จากการลองผิดลองถูก พร้อมรางวัลและบทลงโทษ เช่น หุ่นยนต์ หรือ AI เล่นเกม
ซีรีส์นี้จะโฟกัสที่ Supervised Learning เป็นหลัก
เพราะงาน Machine Learning ในองค์กรส่วนใหญ่ที่ต้อง ขึ้น Production เป็น Service มักเป็นโจทย์แบบมีเฉลย เช่น ใช่ Fraud หรือไม่ ลูกค้าจะยกเลิกหรือไม่ หรือราคาควรเป็นเท่าไหร่
และปัญหาที่กำลังจะทบทวนต่อจากนี้ — Schema, Skew, Drift, Monitoring — ก็เกิดกับทุกประเภทเหมือนกัน
2.3 Train / Validation / Test — ทำไมต้องมีถึงสามชุด#
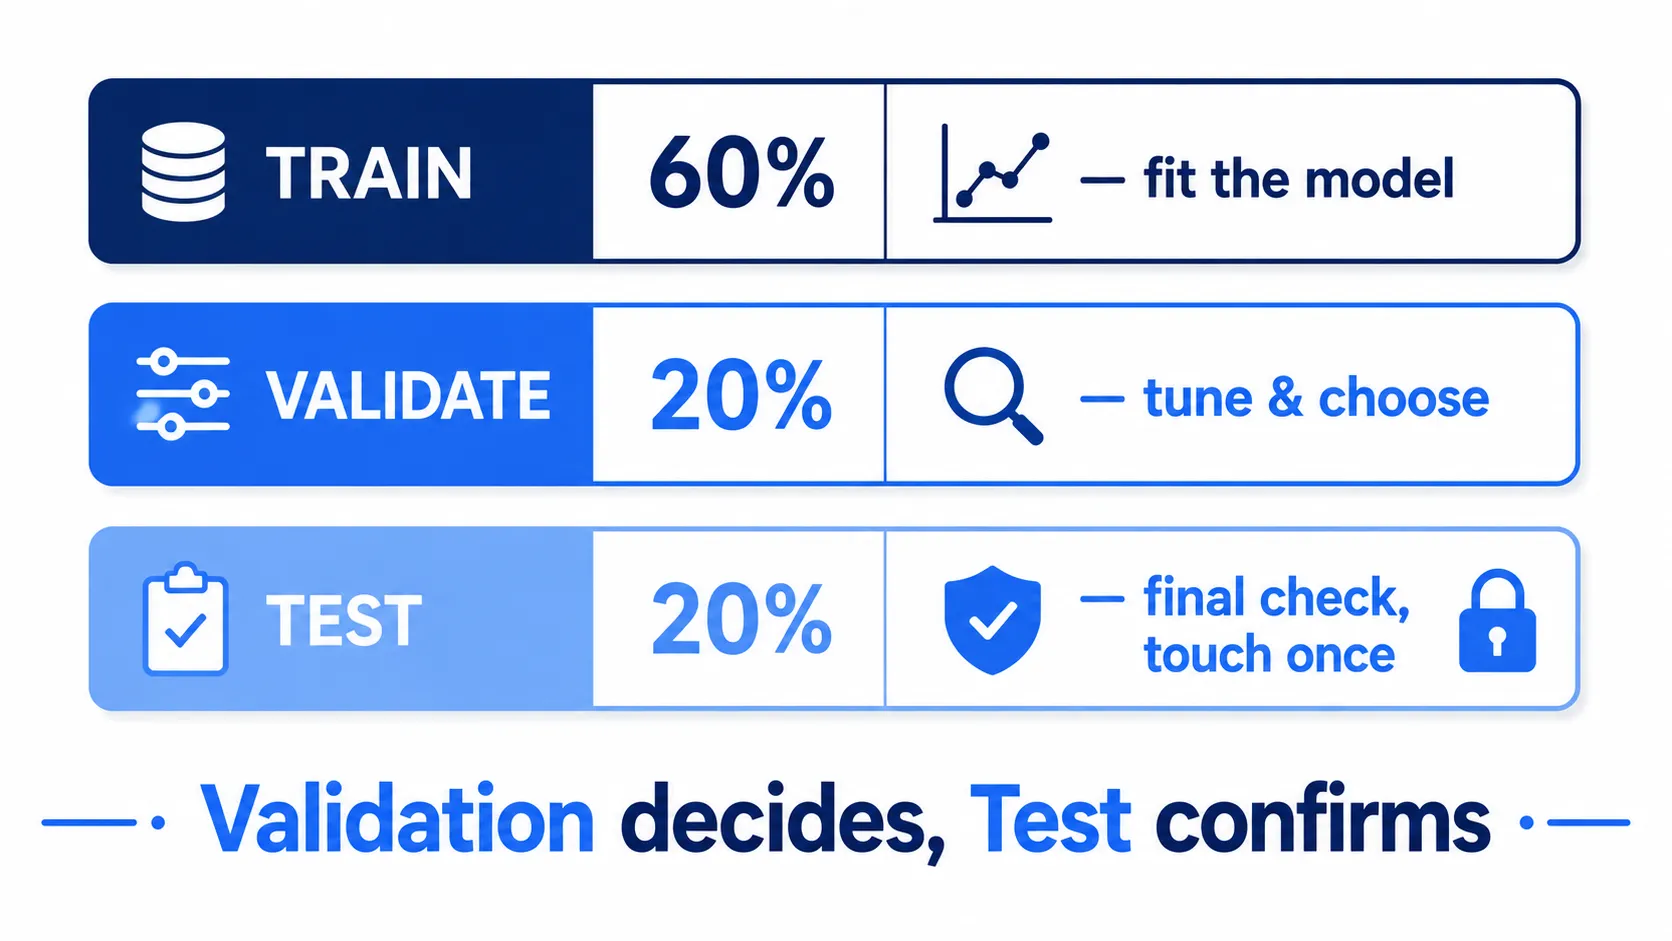
ตอนเรียน Machine Learning ครั้งแรก การแบ่งข้อมูลมักมีแค่สองชุด คือ Training กับ Test
แต่ในงานจริง ต้องการถึง สามชุด:
- Training Set — ใช้ Fit โมเดล
- Validation Set — ใช้วัดผลระหว่างพัฒนา ปรับ Hyperparameter และเลือกว่าโมเดลแบบไหนดีที่สุด
- Test Set — ใช้วัดผล ครั้งเดียวตอนจบ เพื่อยืนยันผลลัพธ์สุดท้าย
ทำไมต้องแยก Validation ออกมา?
เพราะทุกครั้งที่ใช้ผลจากชุดหนึ่งตัดสินใจ เช่น ลองโมเดล 20 แบบแล้วเลือกแบบที่คะแนนดีที่สุด ชุดข้อมูลนั้นก็เริ่มไม่ใช่ข้อมูลที่โมเดล “ไม่เคยเห็น” อีกต่อไป
คะแนนที่ได้จึงมีผลของ การคัดเลือกจากหลายครั้ง ปนอยู่ด้วย ไม่ใช่ความสามารถจริงของโมเดล
import pandas as pd
from sklearn.model_selection import train_test_split

df = pd.read_csv("spam.csv")
X = df[["length", "num_links", "num_capital_words", "sender_domain_new"]]
y = df["spam"]

# แบ่งครั้งแรก: หยิบ Test set ออกไปล็อกไว้ก่อน
X_train_val, X_test, y_train_val, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# แบ่งอีกครั้ง: หยิบ Validation ออกจากชุดที่เหลือ
X_train, X_val, y_train, y_val = train_test_split(
    X_train_val, y_train_val, test_size=0.25, random_state=42
)กติกาจึงมีแค่บรรทัดเดียว:
Validation ใช้ตัดสินใจได้หลายครั้ง Test ใช้ครั้งเดียว และครั้งนั้นต้องเป็นครั้งสุดท้าย
ถ้าข้อมูลมีน้อย ทางเลือกหนึ่งคือใช้ Cross-Validation แทน คือแบ่งข้อมูลเป็น k ส่วนแล้วหมุนเวียนให้แต่ละส่วนได้เป็น Validation บ้าง วิธีนี้ให้ตัวเลขที่เสถียรกว่าเมื่อข้อมูลจำกัด
และเดี๋ยวเรื่องนี้จะกลับมาอีกครั้งใน Production — เพราะข้อมูลจริงที่ไหลเข้าหาโมเดลทุกวัน คือ Test Set ที่ไม่มีวันหมดและไม่มีเฉลยแนบมา
2.4 เริ่มจาก Baseline ก่อนเสมอ#
ก่อนจะ Train โมเดลอะไรที่ซับซ้อน มีขั้นตอนหนึ่งที่มือใหม่มักข้าม แต่คนทำงานจริงแทบไม่เคยข้าม นั่นคือการสร้าง Baseline
Baseline คือ วิธีที่ง่ายที่สุดในการตอบโจทย์นั้น ๆ ง่ายจนดูเหมือนโง่
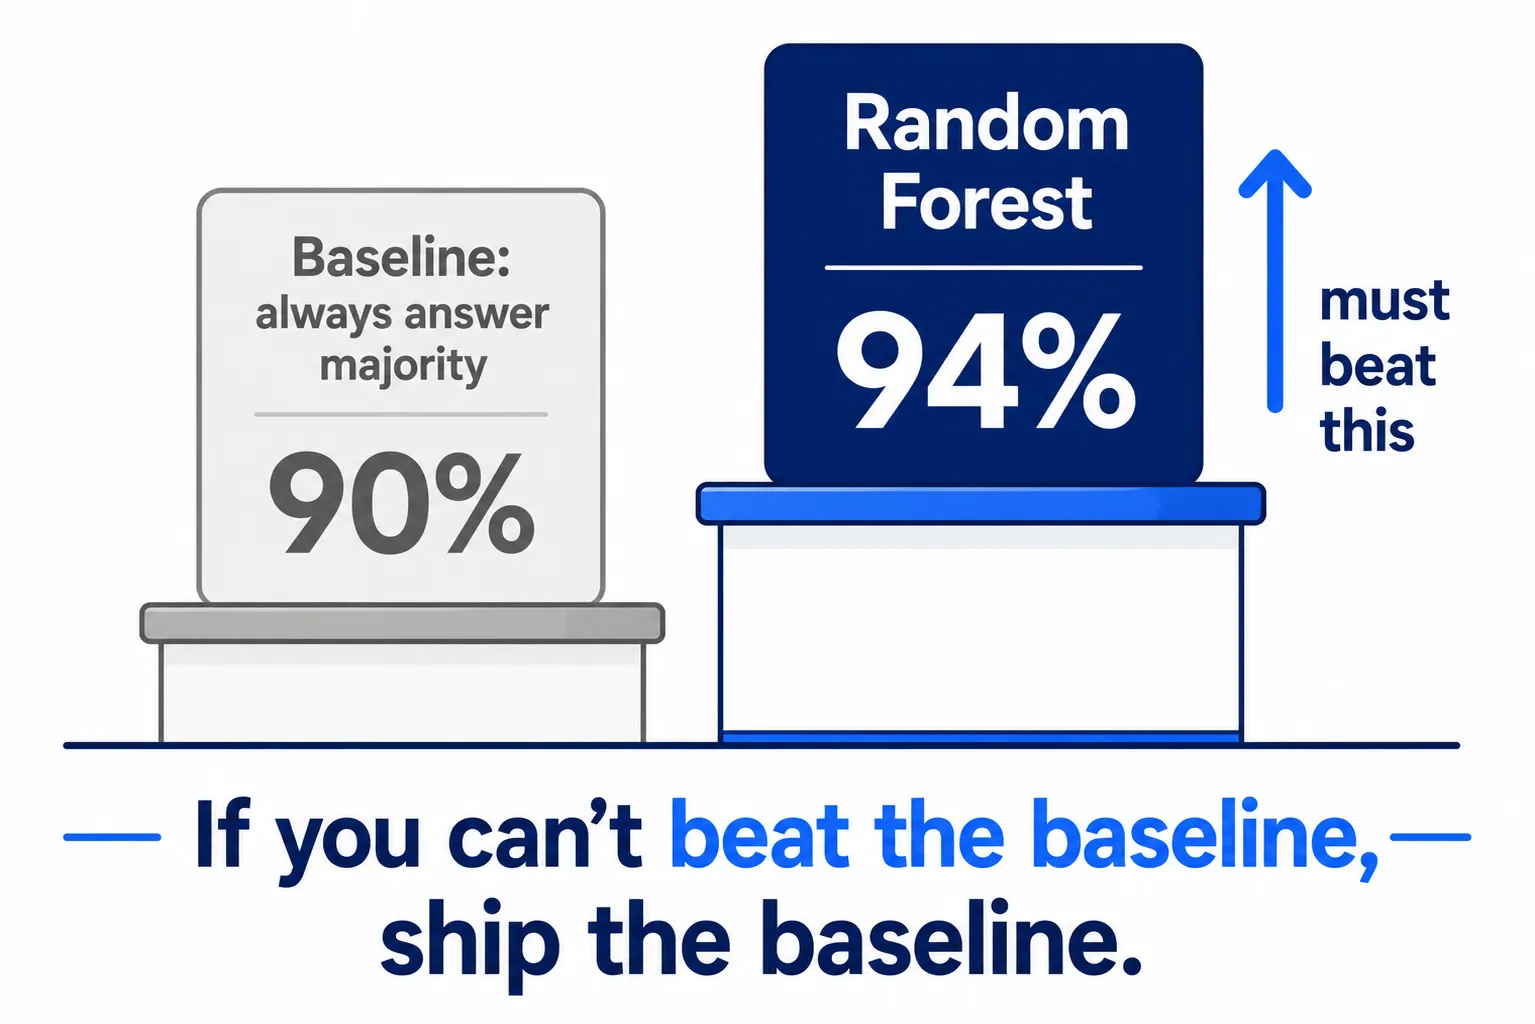
เช่น โจทย์ Spam Detection ที่อีเมล 90% ไม่ใช่ Spam baseline ที่ง่ายที่สุดคือ “ตอบว่าไม่ใช่ Spam ทุกครั้ง”
ใน Scikit-learn เขียนได้ไม่กี่บรรทัด:
import pandas as pd
from sklearn.dummy import DummyClassifier

df = pd.read_csv("spam.csv")            # 9 ใน 10 ฉบับไม่ใช่ spam
X = df.drop(columns="spam")
y = df["spam"]

baseline = DummyClassifier(strategy="most_frequent")  # ตอบ class ที่เจอบ่อยที่สุดทุกครั้ง
baseline.fit(X, y)
print(baseline.score(X, y)) # 0.9 — ตอบ "ไม่ใช่ spam" ทุกครั้งก็ได้ 90% แล้วหรือโจทย์ Regression อย่างทำนายราคาบ้าน baseline อาจเป็นแค่ “ตอบค่าเฉลี่ยของราคาบ้านทั้งหมดทุกครั้ง”
ประโยชน์ของ baseline มีสองข้อ
ข้อแรก — เป็นเส้นที่โมเดลทุกตัวต้องเอาชนะ
ถ้า Random Forest ได้ 94% แต่ baseline ง่าย ๆ ได้ 90% แปลว่าโมเดลที่ซับซ้อน เพิ่มคุณค่าจริงแค่ 4 แต้ม ถ้าเพิ่มไม่ได้เลย ก็ไม่มีเหตุผลจะเอาความซับซ้อนนั้นขึ้น Production
ข้อสอง — ช่วยกันหลอกตัวเอง
ตัวเลข Accuracy ไม่มีความหมายถ้าไม่มีอะไรให้เทียบ 94% ฟังดูเก่ง แต่ถ้า baseline คือ 92% แปลว่าโมเดลได้ประโยชน์จากข้อมูลเพิ่มจริง ๆ แค่น้อยนิด
ถ้าเอาชนะ Baseline ไม่ได้ ก็ Ship Baseline ไปเลย — ถูกกว่า เร็วกว่า และดูแลง่ายกว่า
2.5 Classical ML ยังมีใช้อยู่มาก#
ทุกวันนี้เมื่อพูดถึง AI ภาพที่นึกถึงก่อนมักเป็น Deep Learning, Neural Network หรือ LLM
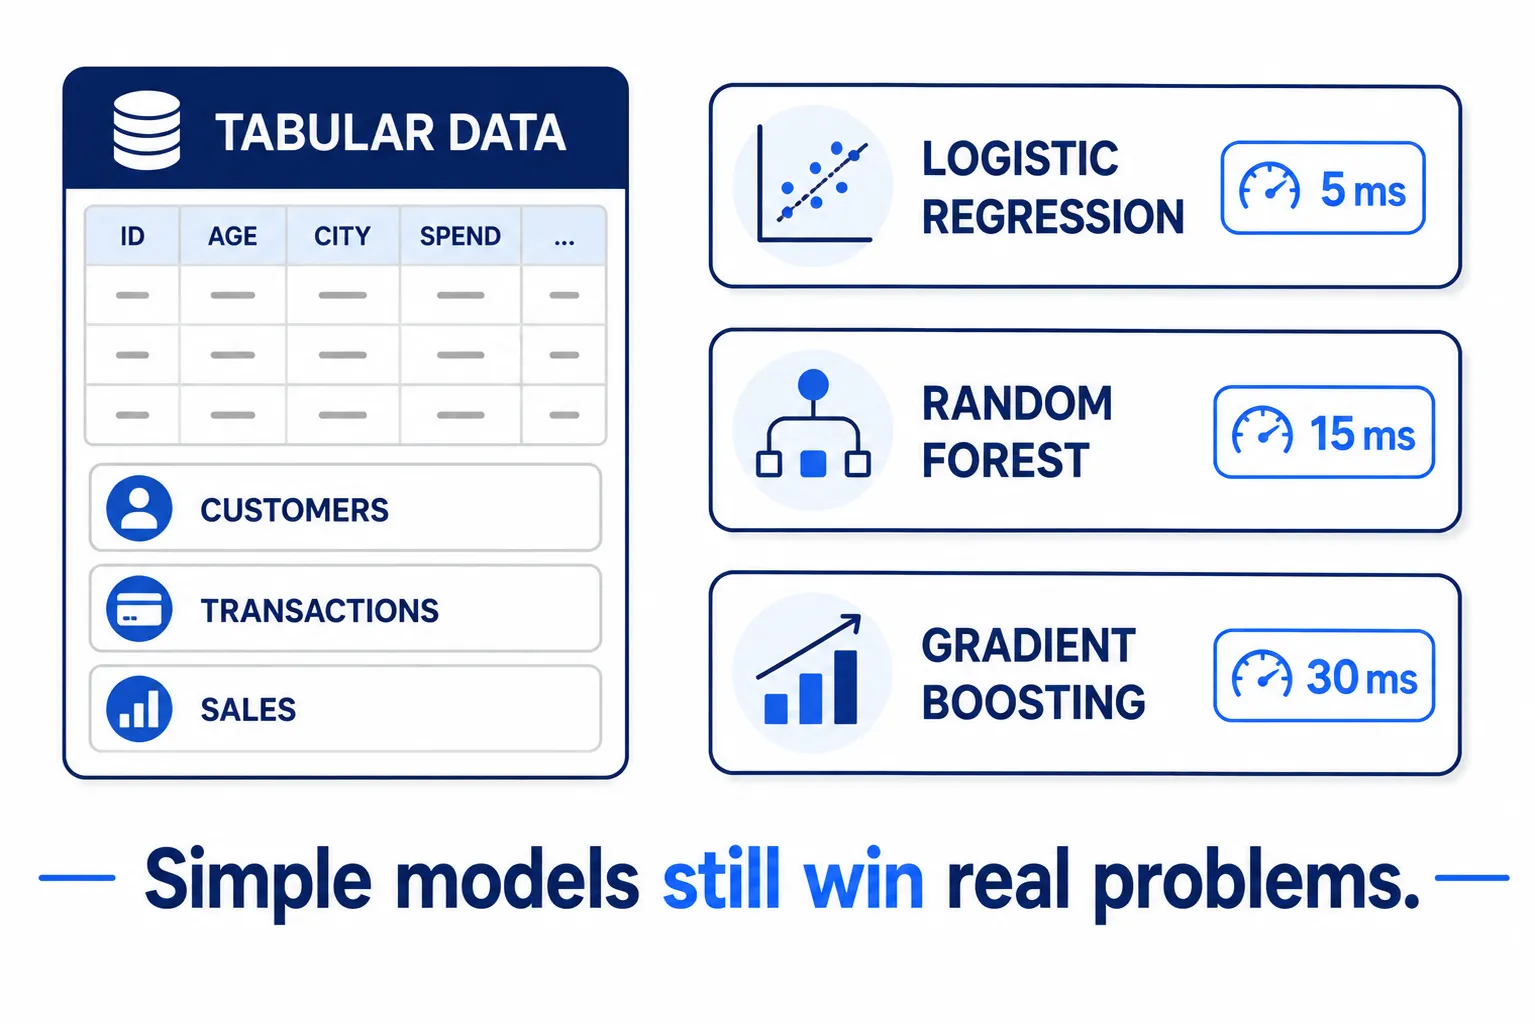
แต่ในระบบจริง Classical Machine Learning อย่าง
- Logistic Regression
- Random Forest
- Gradient Boosting
ยังถูกใช้งานอยู่มาก โดยเฉพาะกับ Tabular Data หรือข้อมูลที่อยู่ในรูปแบบแถวและคอลัมน์ เช่น ข้อมูลลูกค้า ธุรกรรม ยอดขาย สินค้า หรือข้อมูลจากระบบธุรกิจ
สำหรับโจทย์จำนวนมาก Neural Network ขนาดใหญ่แทบไม่จำเป็นเลย
โมเดลที่เรียบง่ายกว่ามักมีข้อดีหลายอย่าง เช่น Train เร็ว ใช้ทรัพยากรน้อย Deploy ง่าย และตอบ Prediction ได้เร็ว
และสำหรับซีรีส์นี้ ความง่ายตรงนี้เป็นข้อดี
ตัวหลักในการเรียนรู้เรื่อง Serving จึงเป็นโมเดลอย่าง Random Forest
ไม่ใช่เพราะ Random Forest เป็นโมเดลที่ดีที่สุดสำหรับทุกปัญหา แต่เพราะสิ่งที่ต้องการเรียนจริง ๆ คือ สิ่งที่อยู่รอบโมเดล
เป้าหมายคือได้เห็นภาพรวมทั้งเส้น:
Train → Save → Deploy → API → Predict → Monitor → Retrain
ถ้า Random Forest ตอบ Prediction ได้ในไม่กี่มิลลิวินาที การเรียนรู้เรื่องเหล่านี้ก็ทำได้เหมือนกับการใช้ Neural Network ขนาดใหญ่ที่อาจใช้เวลานานและต้องการ Hardware มากกว่า
เป้าหมายไม่ใช่การสร้างโมเดลที่ซับซ้อนที่สุด แต่คือการเรียนรู้ว่าจะเอาโมเดลไปใช้งานจริงอย่างไร
ที่สำคัญ แนวคิดที่จะได้เรียนไม่ได้ผูกติดอยู่กับ Random Forest
ไม่ว่าจะเป็น Logistic Regression, XGBoost, Neural Network, Computer Vision Model หรือแม้แต่ Application ที่เรียกใช้ LLM ผ่าน API หลักคิดหลายอย่างยังเหมือนเดิม:
มี Input → มี Model → มี Prediction → มีระบบ Serving → และต้อง Monitor สิ่งที่เกิดขึ้นหลัง Deploy
ดังนั้นโมเดลอาจเปลี่ยนไป แต่ปัญหาของการนำ Machine Learning ไปใช้งานจริงยังคงอยู่
3. สามคำศัพท์ที่ต้องรู้ก่อนขึ้น Production#
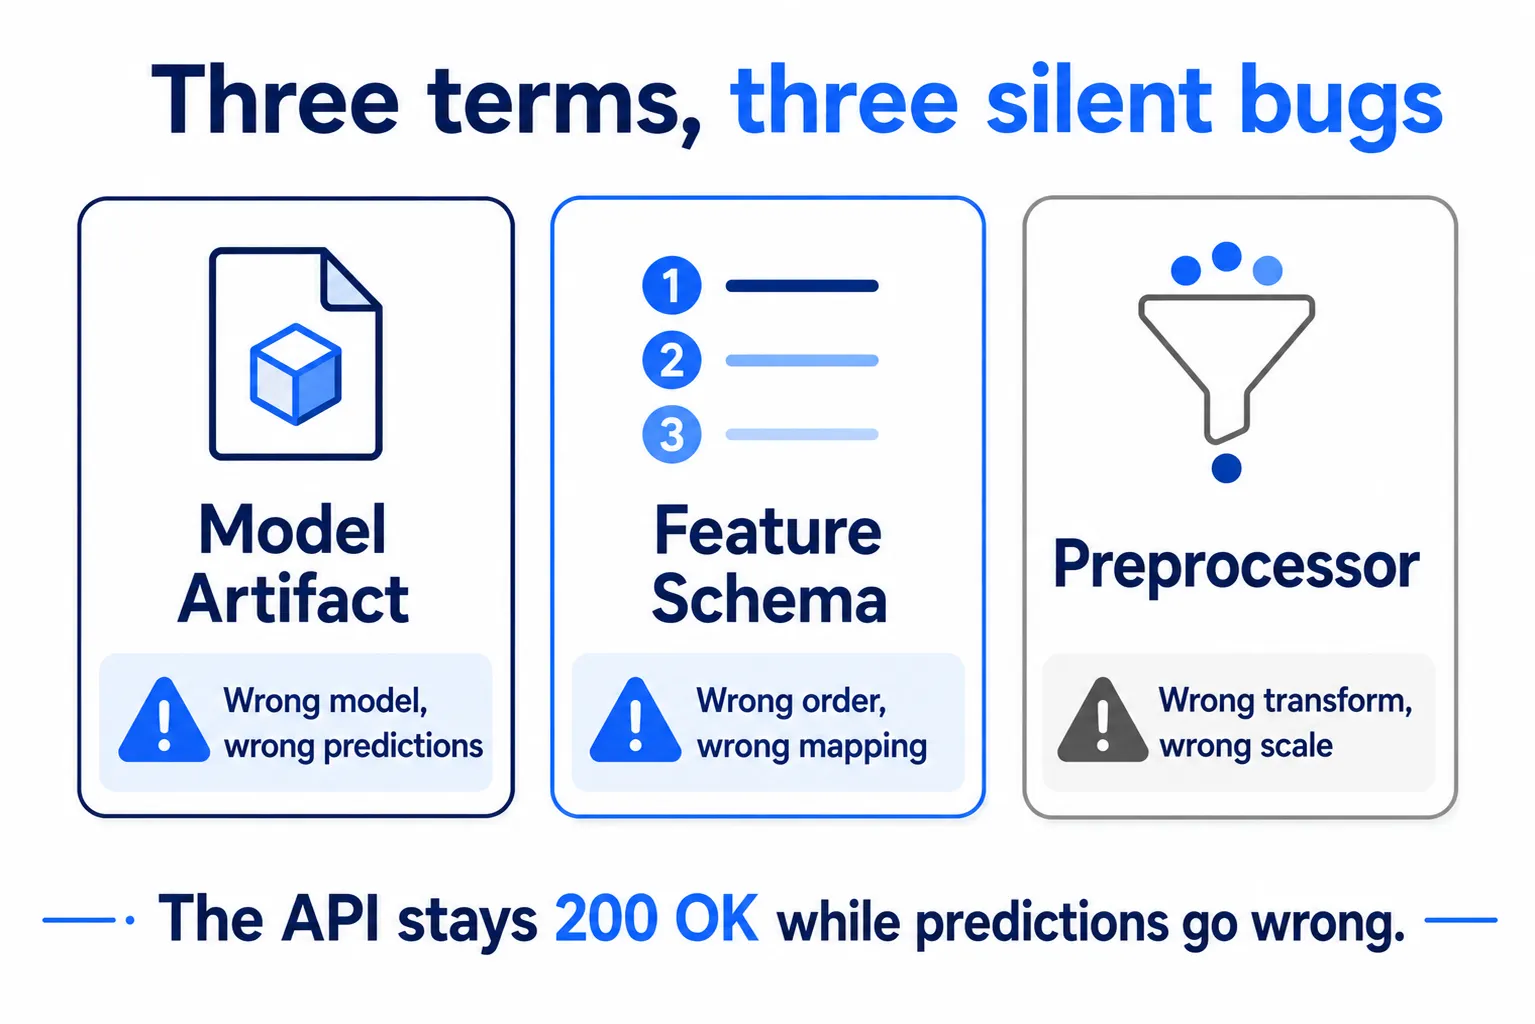
ก่อนจะไปต่อ มีคำศัพท์ 3 คำที่ต้องจำให้แม่น เพราะปัญหา Machine Learning ใน Production จำนวนมากไม่ได้มาในรูปของ Server ล่มหรือ Error สีแดง
แต่เป็นปัญหาแบบที่ ระบบยังทำงาน API ยังตอบ 200 OK แต่ Prediction ผิด
และนั่นอันตรายกว่า Error ที่มองเห็นเสียอีก
สามคำที่ต้องรู้คือ Model Artifact, Feature Schema และ Preprocessor
3.1 Model Artifact — โมเดลที่ถูกบันทึกไว้เป็นไฟล์#
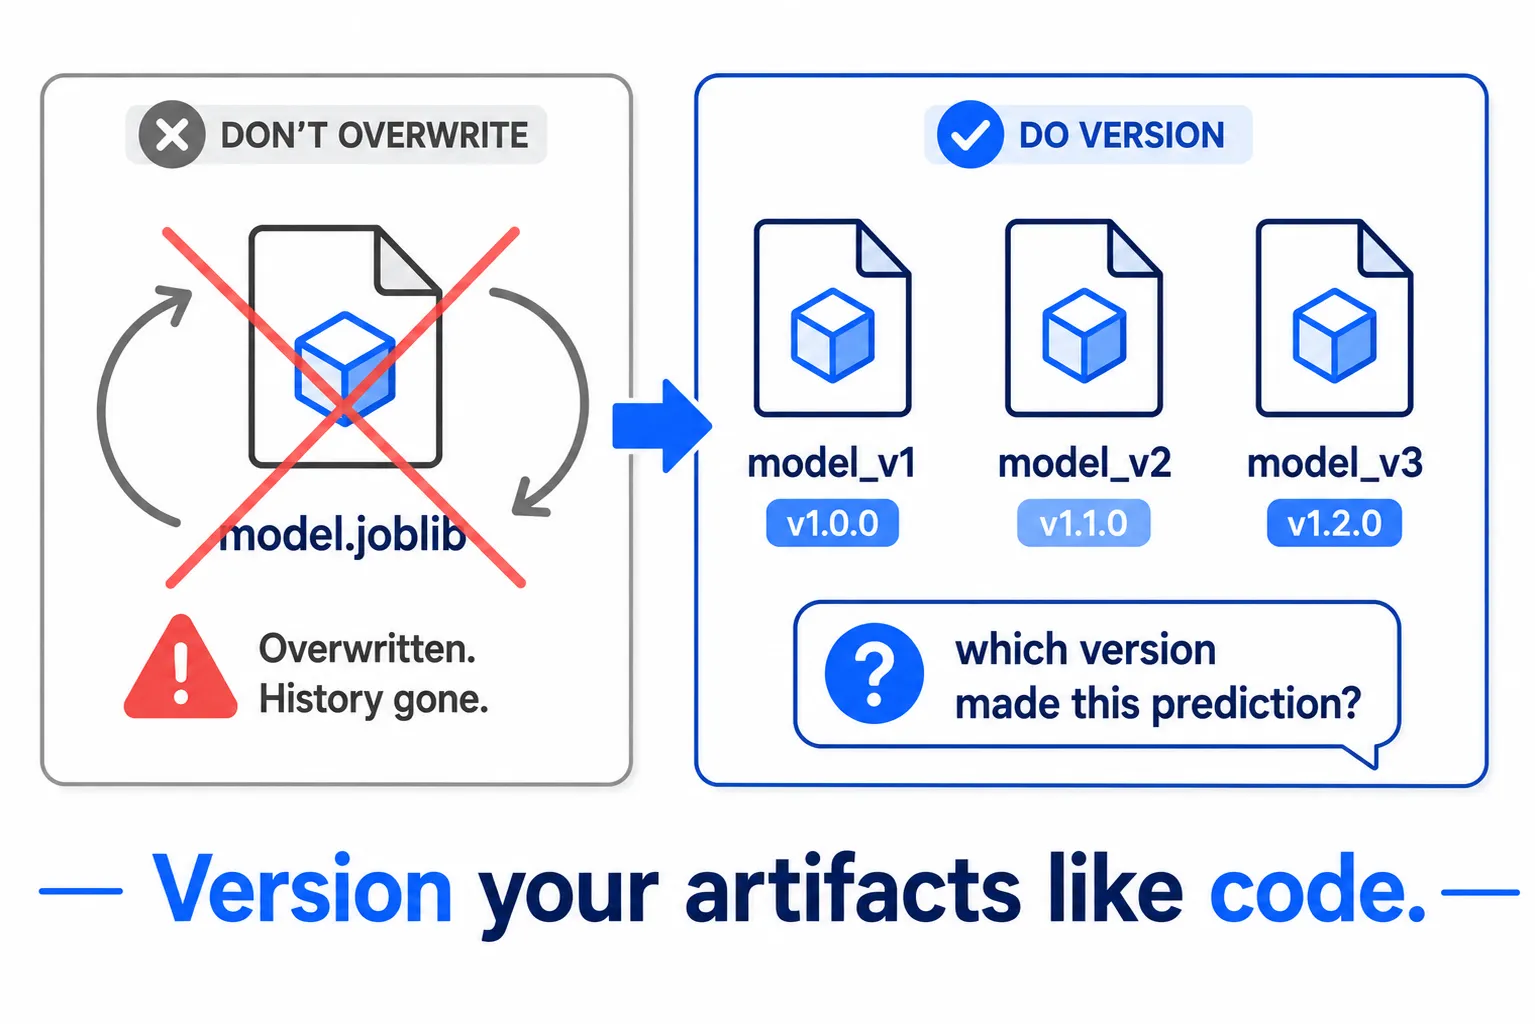
คำนี้เคยปรากฏมาแล้วในตอนก่อนหน้า
หลังจาก Train โมเดลเสร็จ โมเดลจะถูก Serialize และบันทึกออกมาเป็นไฟล์ เช่น:
model.joblib
ไฟล์นี้คือ Model Artifact และเป็นสิ่งที่ Server โหลดไปใช้สำหรับ Prediction
สิ่งสำคัญคือ Artifact ควรถูกจัดการอย่างจริงจังไม่ต่างจาก Source Code โดยเฉพาะเรื่อง Versioning
แทนที่จะมีไฟล์ชื่อ:
model.joblib
เพียงไฟล์เดียวที่ถูกเขียนทับไปเรื่อย ๆ ควรระบุให้ได้ว่า Production กำลังใช้โมเดล Version ไหน เช่น:
model_v1.joblib
model_v2.joblib
model_v3.joblib
เพราะวันหนึ่งจะต้องมีคนถามว่า:
“Prediction นี้มาจากโมเดล Version ไหน?”
ถ้าตอบไม่ได้ การ Debug หรือย้อนกลับไปตรวจสอบผลลัพธ์จะยากมาก
3.2 Feature Schema — โมเดลต้องรู้ว่า Input แต่ละช่องคืออะไร#
สมมติว่า Train โมเดลด้วย Features ตามลำดับนี้:
[age, income, days_since_signup]
โมเดลจึงเรียนรู้ว่า:
- ค่าตัวแรกคือ
age - ค่าตัวที่สองคือ
income - ค่าตัวที่สามคือ
days_since_signup
ลองด้วยไฟล์จริง — สร้าง customers.csv ในโฟลเดอร์เดียวกับ notebook:
age,income,days_since_signup,will_buy
25,30000,10,0
52,78000,200,1
34,45000,55,0
45,62000,120,1
23,28000,5,0
61,90000,300,1
29,36000,30,0
58,84000,260,1แล้ว Train โมเดลด้วยลำดับคอลัมน์นี้:
import pandas as pd
import joblib
from sklearn.ensemble import RandomForestClassifier

df = pd.read_csv("customers.csv")
X = df[["age", "income", "days_since_signup"]]   # ลำดับตรงนี้สำคัญมาก
y = df["will_buy"]

model = RandomForestClassifier(random_state=0).fit(X, y)
joblib.dump(model, "model_v1.joblib")แต่ตอน Serving โปรแกรมดันส่งข้อมูลเป็น:
[income, age, days_since_signup]
จำนวน Features ยังเท่าเดิม ชนิดข้อมูลยังเป็นตัวเลขเหมือนเดิม ไม่มีค่าไหนหายไป
ดังนั้นโปรแกรมอาจ ไม่ Error เลย
ปัญหาคือโมเดลจะเข้าใจว่า income คือ age และ age คือ income
แล้วก็ทำนายต่อไปอย่างมั่นใจ
# ฝั่ง Serving ส่งสลับลำดับ — ไม่มี error ไม่มี exception แต่คำตอบผิด
wrong_order = [[62000, 45, 120]]   # จริง ๆ คือ [income, age, days_since_signup]
model.predict(wrong_order) # ตอบ 0 — ทั้งที่คำตอบจริงของลูกค้าคนนี้คือ 1ไม่มี Error ไม่มี Exception — มีแค่ Prediction ที่ผิด
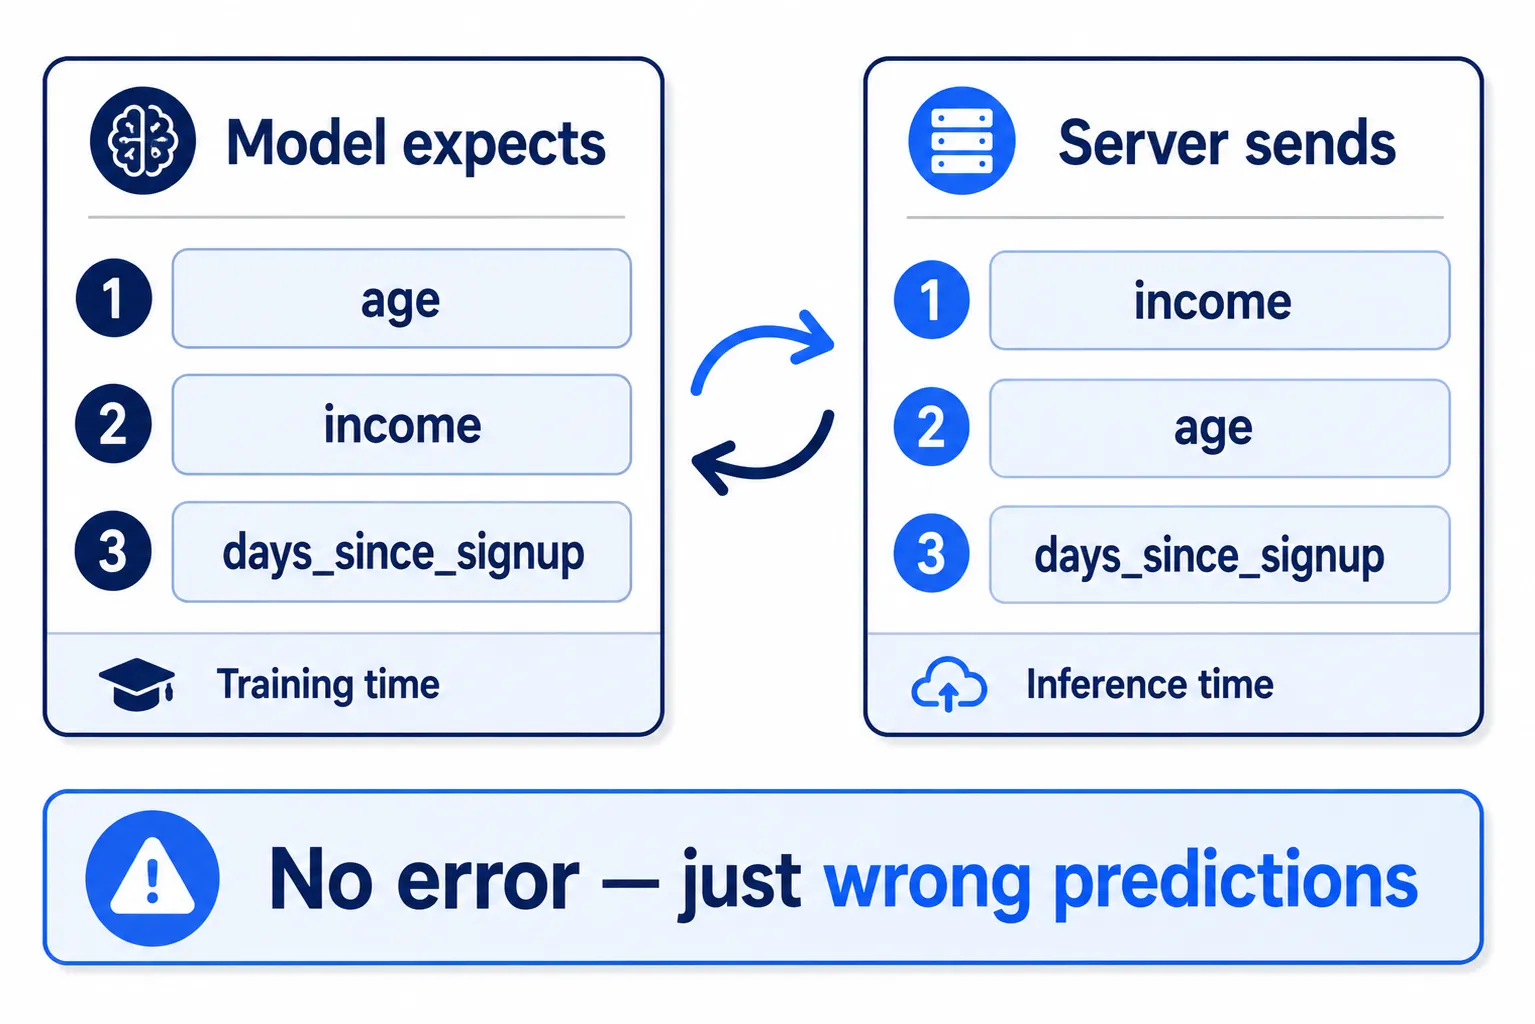
นี่คือเหตุผลที่ Feature Schema สำคัญ
ต้องระบุให้ชัดว่าโมเดลคาดหวัง:
Feature อะไร → ลำดับไหน → Data Type อะไร
และฝั่ง Serving ต้องส่งข้อมูลให้ตรงกับสิ่งที่โมเดลเห็นตอน Training
3.3 Preprocessor — ข้อมูลก่อนเข้าโมเดลถูกแปลงอะไรไปบ้าง#
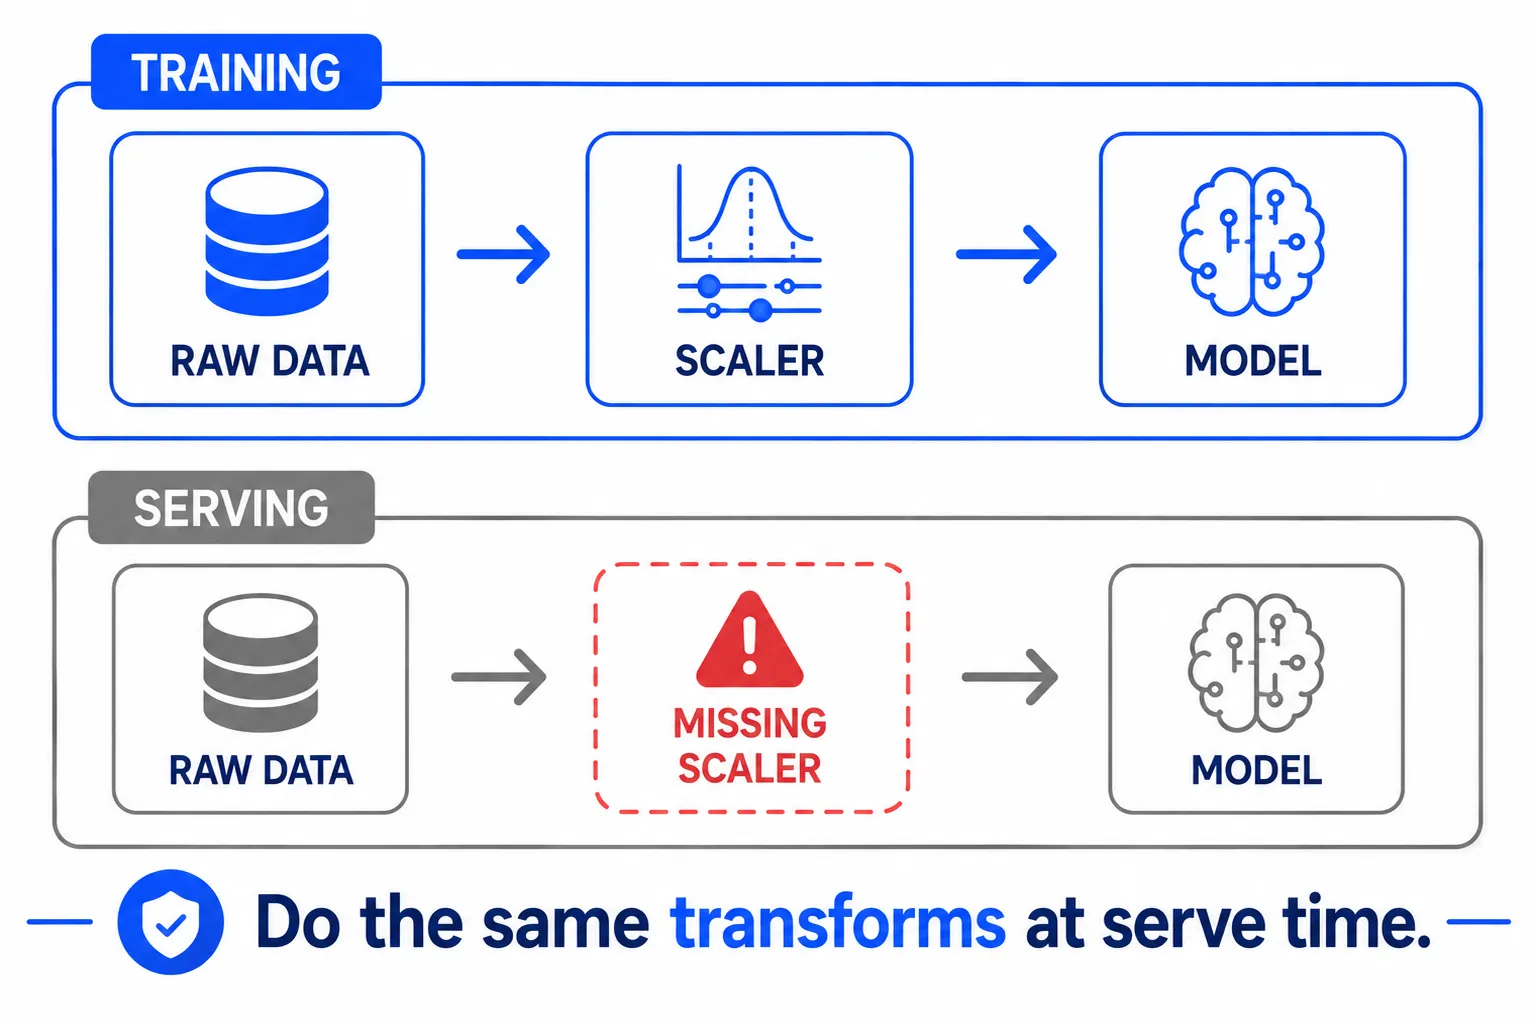
ก่อน Train โมเดล ข้อมูลดิบมักไม่ได้ถูกใส่เข้าไปตรง ๆ
ส่วนใหญ่ต้องผ่าน Preprocessing ก่อน เช่น:
- Scale ตัวเลข
- เติม Missing Value
- Encode Category
- แปลงข้อความเป็นตัวเลข
สมมติว่าตอน Training ใช้ StandardScaler แปลงข้อมูลก่อนส่งเข้าโมเดล
Flow ตอน Training จึงเป็น:
Raw Data → Scaler → Model
แต่พอ Deploy ขึ้น Production โปรแกรมฝั่ง Serving กลับทำแบบนี้:
Raw Data → Model
ขั้นตอน Scaler ถูกลืมไป
โมเดลจึงได้รับข้อมูลคนละรูปแบบกับที่เคยเห็นตอน Training
และปัญหาคืออาจ ไม่ Error
โมเดลยังคำนวณและส่ง Prediction กลับมาได้ เพียงแต่ Prediction นั้นอาจผิดไปมาก
ปัญหาที่ขั้นตอนเตรียมข้อมูลระหว่าง Training และ Serving ไม่เหมือนกันเรียกว่า Train/Serve Skew
หลักสำคัญจึงง่ายมาก:
Whatever you do to the data during Training, do exactly the same during Serving.
หรือพูดง่าย ๆ ว่า:
ก่อน Train แปลงข้อมูลอย่างไร ตอน Serve ก็ต้องแปลงแบบเดียวกัน
3.4 วิธีที่ดีกว่า: Save Pipeline ไม่ใช่ Save แค่ Model#
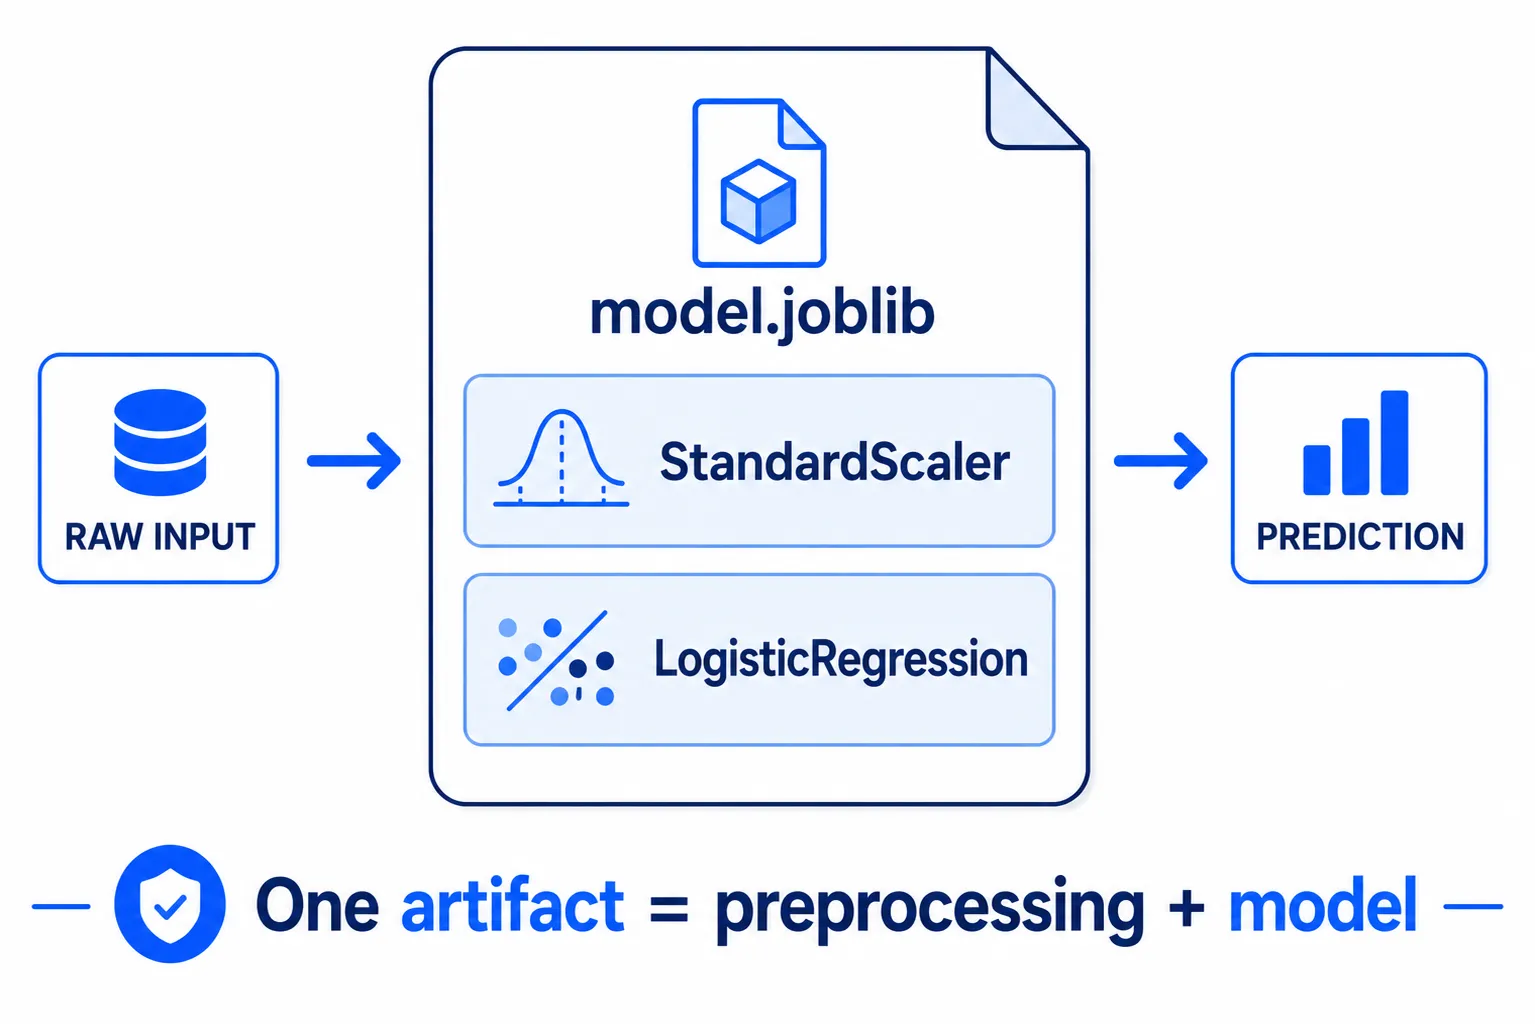
แทนที่จะหวังว่าโปรแกรมฝั่ง Serving จะจำได้ว่าต้องเรียก Scaler ก่อนทุกครั้ง ทางที่ดีกว่าคือ รวม Preprocessor และ Model เข้าไว้ด้วยกัน
ใน Scikit-learn ทำได้ด้วย Pipeline
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

df = pd.read_csv("customers.csv")                      # ใช้ไฟล์เดิมจากตัวอย่างก่อน
X = df[["age", "income", "days_since_signup"]]
y = df["will_buy"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)

pipe = Pipeline([
    ("scale", StandardScaler()),      # ขั้น 1: Scale ข้อมูล
    ("clf", LogisticRegression()),    # ขั้น 2: ส่งเข้า Model
])

pipe.fit(X_train, y_train)

joblib.dump(pipe, "model.joblib")จุดสำคัญคือ ตอนนี้ model.joblib ไม่ได้เก็บแค่ Logistic Regression
แต่เก็บทั้ง:
Scaler + Model
ไว้ด้วยกันใน Artifact เดียว
ดังนั้นตอน Serving เหลือเพียง:
pipe = joblib.load("model.joblib")

prediction = pipe.predict([[52, 78000, 200]]) # ลำดับ [age, income, days_since_signup]เมื่อเรียก predict() ตัว Pipeline จะจัดการให้เอง:
Input → StandardScaler → Logistic Regression → Prediction
ฝั่ง Serving จึงไม่ต้องจำว่า “ก่อน Predict ต้อง Scale ก่อนนะ”
เพราะขั้นตอนนั้นถูกฝังอยู่ใน Artifact ตั้งแต่ตอน Training แล้ว
นี่เป็นหลักการออกแบบที่สำคัญมากของ ML Serving:
อย่าฝากความถูกต้องไว้กับความจำของคน ถ้าบังคับให้ถูกต้องด้วยการออกแบบระบบได้
แทนที่จะเขียน Training Pipeline ชุดหนึ่ง แล้วพยายามเขียน Serving Pipeline ให้เหมือนกันอีกชุด ทางที่ดีกว่าคือสร้าง Pipeline เดียว แล้ว Serialize ทั้งหมดไปพร้อมกัน
Artifact จึงกลายเป็น Single Source of Truth สำหรับวิธีแปลงข้อมูลและวิธี Prediction
และนั่นช่วยกำจัด Train/Serve Skew หลายรูปแบบออกไปตั้งแต่ต้น
สรุปสามบั๊กเงียบที่ควรจำไว้:
| สิ่งที่ต้องระวัง | ถ้าพลาดจะเกิดอะไรขึ้น |
|---|---|
| Model Artifact | ไม่รู้ว่า Prediction มาจากโมเดล Version ไหน |
| Feature Schema | ส่ง Feature ผิดลำดับหรือผิดรูปแบบ แต่ระบบอาจยังทำงาน |
| Preprocessor | Training กับ Serving แปลงข้อมูลไม่เหมือนกัน เกิด Train/Serve Skew |
ทั้งสามกรณีมีสิ่งหนึ่งเหมือนกัน:
ระบบอาจไม่พัง แต่คำตอบพัง
และนี่คือเหตุผลว่าทำไม ML Production ต้องสนใจมากกว่าแค่ว่า API เปิดได้หรือ Server ยังทำงานอยู่
4. อะไรเปลี่ยนไปเมื่อโมเดลขึ้น Production#
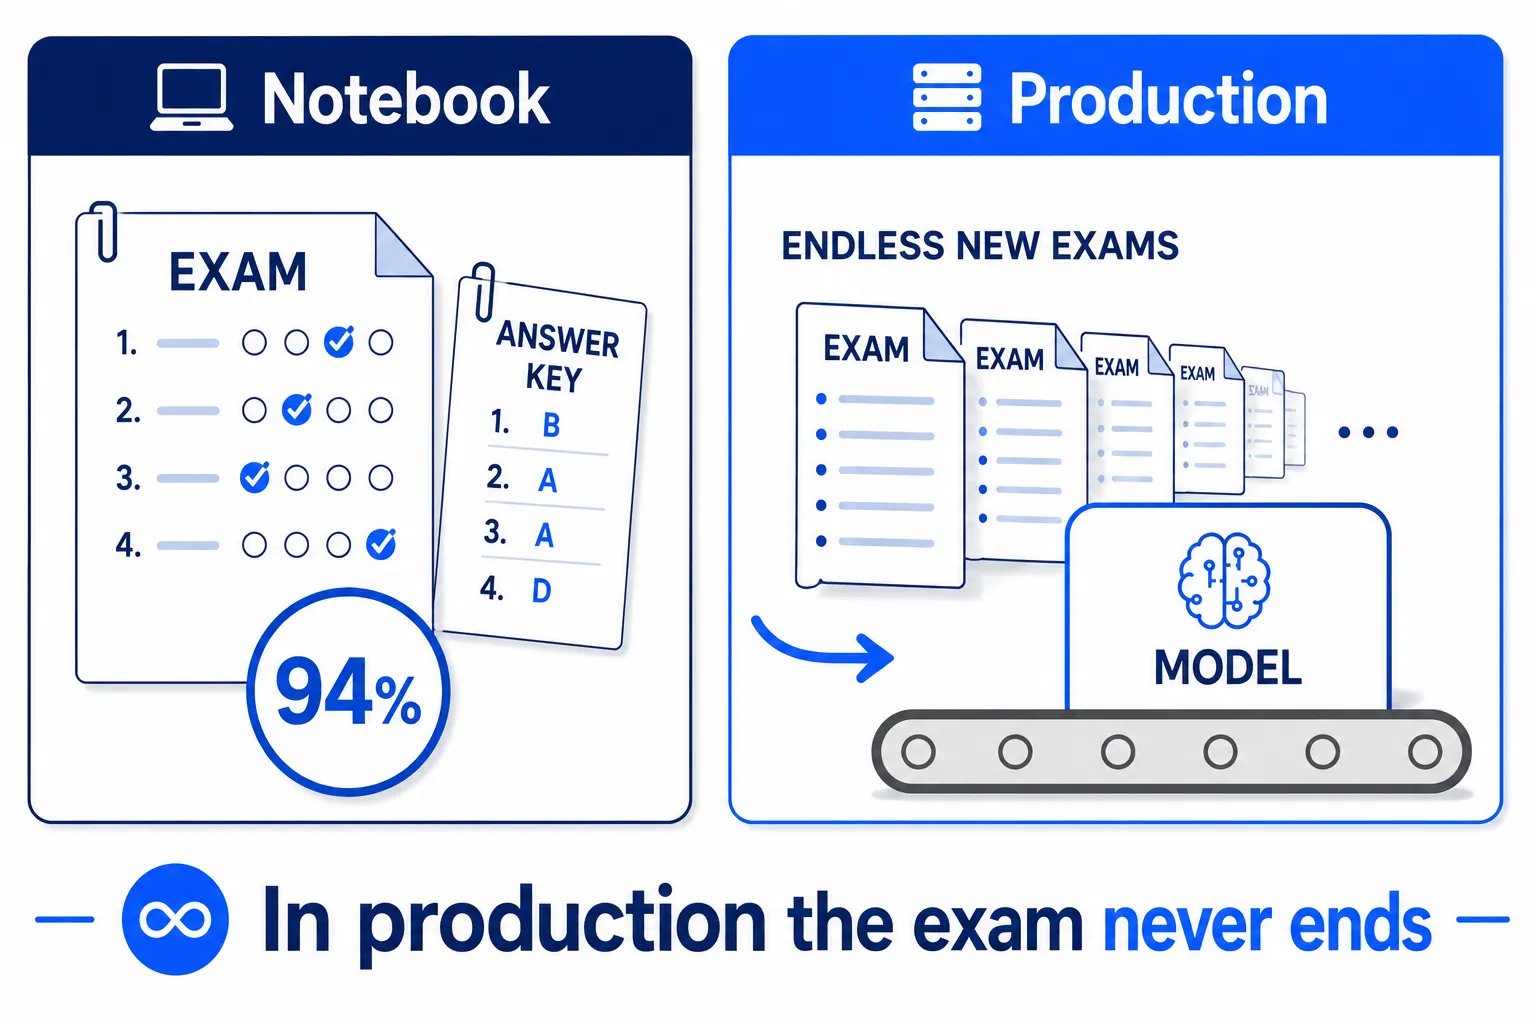
ตอนเรียน Machine Learning การประเมินโมเดลมักทำด้วยวิธีที่ค่อนข้างตรงไปตรงมา
แบ่งข้อมูลออกเป็น Training Set และ Test Set จากนั้น Train โมเดลด้วย Training Set แล้ววัดผลกับข้อมูลที่โมเดลไม่เคยเห็นมาก่อน
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model.fit(X_train, y_train)
model.score(X_test, y_test)สุดท้ายก็ได้ตัวเลขออกมาหนึ่งค่า เช่น:
Accuracy = 94%
ดูเหมือนง่าย — โมเดลได้ 94% ก็ถือว่าดี แล้วงานก็จบ
แต่พอเอาโมเดลขึ้น Production สถานการณ์เปลี่ยนไปอย่างมาก เพราะ Test Set ไม่ได้มีแค่ชุดเดียวอีกต่อไป
ข้อมูลใหม่ไหลเข้ามาหาโมเดลทุกวัน และไม่มีวันหยุด
ทุก Request จากผู้ใช้จริง คือข้อสอบข้อใหม่ของโมเดล
และตรงนี้มีอย่างน้อย 3 เรื่องที่ต่างจากตอนอยู่ในห้องเรียน
4.1 ชุดข้อสอบไม่เคยหยุดมา#
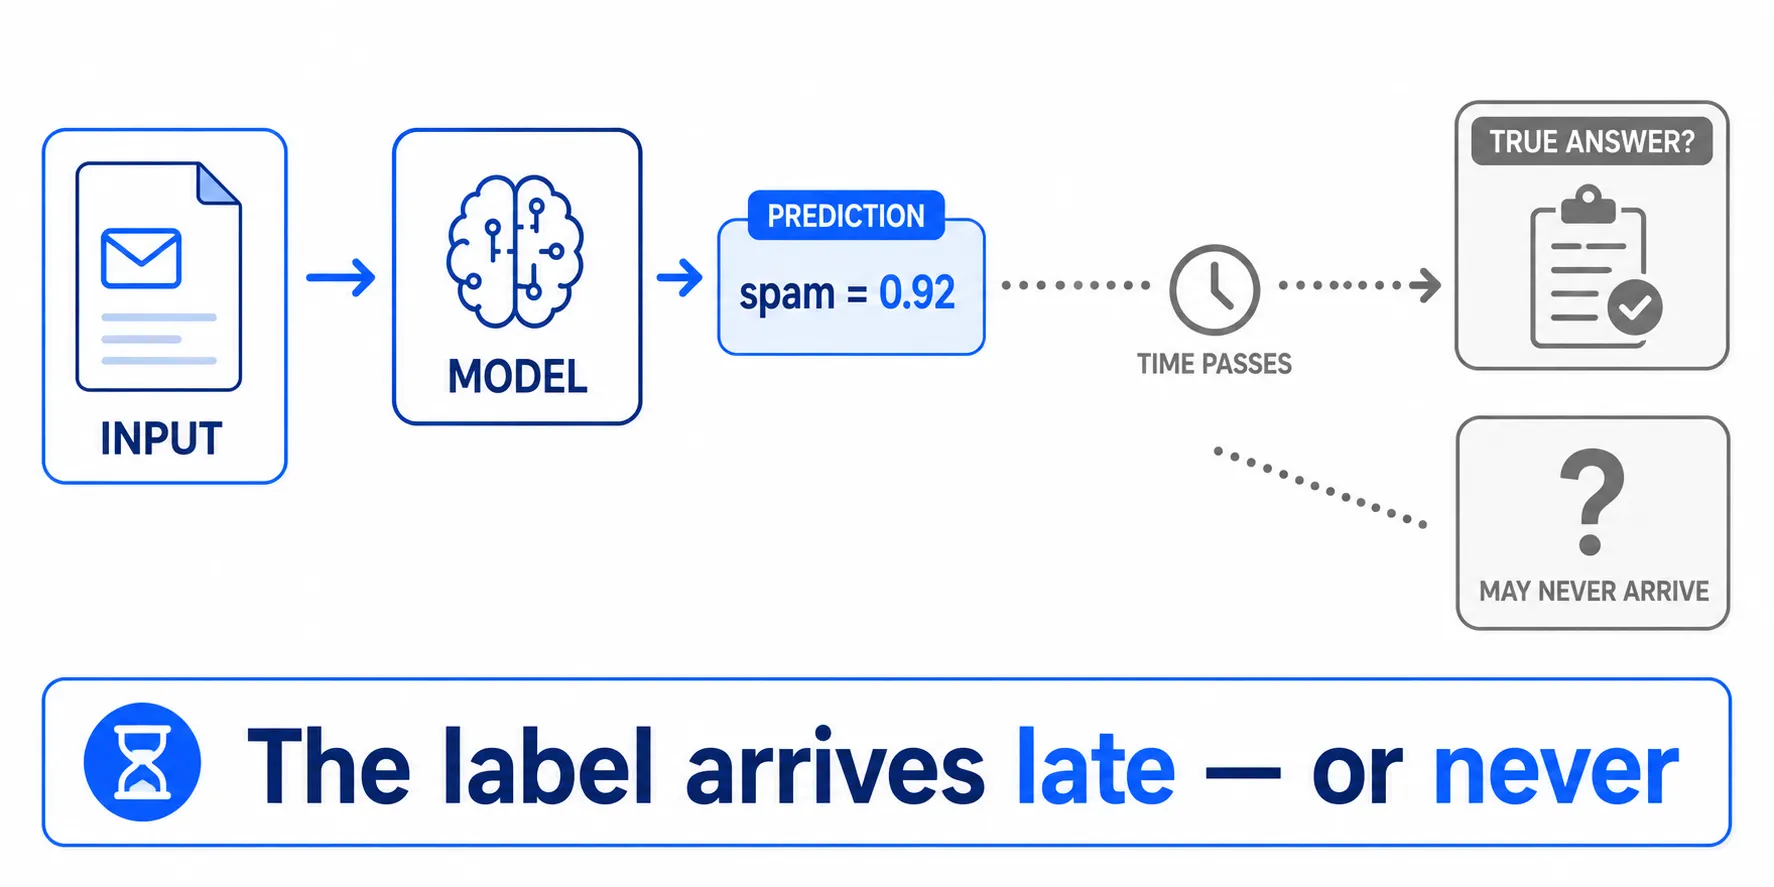
ตอนเรียน มีทั้ง X_test และที่สำคัญคือมี y_test
นั่นหมายความว่ามีทั้ง โจทย์และเฉลย
โมเดลทำนายว่าอีเมลเป็น Spam ก็เปิด y_test ดูได้ทันทีว่าคำตอบถูกหรือผิด
แต่ใน Production มักมีเพียง:
Input → Prediction → แล้วก็จบ
สมมติมีอีเมลใหม่เข้ามา โมเดลตอบว่า:
spam = 0.92
แต่ยังไม่มีทางรู้เลยว่าอีเมลนั้นเป็น Spam จริงหรือไม่
เฉลยอาจมาทีหลัง เช่น ผู้ใช้กด “Not Spam” หรืออาจไม่มีเฉลยกลับมาเลย
ดังนั้นการวัด Accuracy ใน Production จึงยากกว่าใน Notebook มาก
ตอน Training มีเฉลยพร้อม ตอน Production อาจต้องรอเฉลย — หรือไม่ได้เฉลยเลย
4.2 ข้อมูลจริงอาจไม่เหมือนข้อมูลตอน Train#
ตอนแบ่งข้อมูลด้วย train_test_split() ข้อสมมติที่มักตั้งไว้คือ Training Set และ Test Set มาจากข้อมูลชุดเดียวกัน
ดังนั้น Test Set จึงเป็นตัวแทนที่ค่อนข้างยุติธรรมของสิ่งที่โมเดลเรียนมา
แต่ Production ไม่มีใครรับประกันแบบนั้น
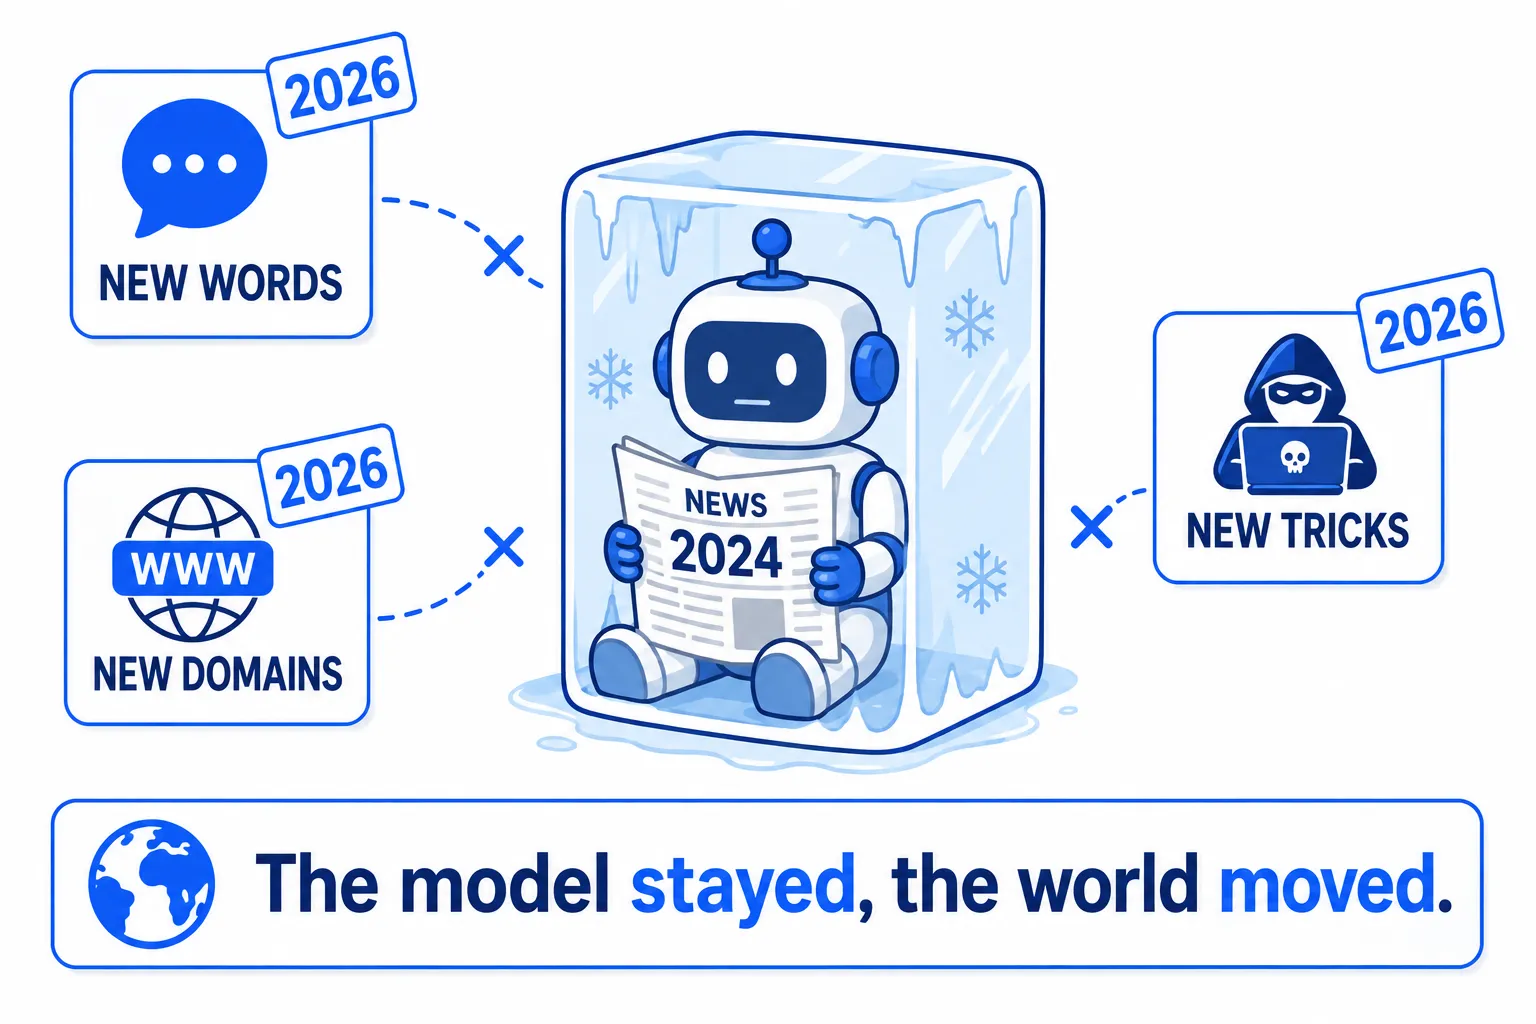
สมมติ Train โมเดล Spam Detection จากอีเมลของปีนี้
อีกหกเดือนต่อมา Spam อาจเปลี่ยนรูปแบบ คนส่ง Spam อาจใช้คำใหม่ Domain ใหม่ หรือวิธีหลบระบบแบบใหม่
โมเดลยังเป็นตัวเดิม แต่ โลกที่อยู่รอบโมเดลเปลี่ยนไปแล้ว
ข้อมูลที่เข้ามาใน Production จึงอาจค่อย ๆ แตกต่างจากข้อมูลที่ใช้ Train มากขึ้นเรื่อย ๆ
สิ่งนี้เป็นหนึ่งในเหตุผลที่โมเดลที่เคยแม่น 94% ตอน Deploy อาจค่อย ๆ ลดเหลือ 90%, 85% หรือ 70% โดยที่ Server ไม่ได้มีอะไรเสียเลย
Model ไม่ได้เปลี่ยน แต่ Data เปลี่ยน
และนี่คือเหตุผลที่ต้อง Monitor ไม่ใช่แค่ Server แต่ต้อง Monitor ข้อมูลที่ไหลเข้าหาโมเดล ด้วย
4.3 Accuracy ดีอย่างเดียวไม่พอ — Latency ก็สำคัญ#
ใน Notebook คำถามหลักมักเป็น:
“โมเดลไหนแม่นที่สุด?”
แต่ใน Production ต้องถามเพิ่มว่า:
“แล้วโมเดลตอบเร็วพอไหม?”
เพราะ model.predict() ไม่ได้รันอยู่ใน Notebook อีกต่อไป แต่ไปอยู่ใน Request Handler ของ API
Flow จริงอาจเป็น:
User → API → Model Predict → Response → User
ถ้าโมเดลใช้เวลา 20 มิลลิวินาที ผู้ใช้อาจแทบไม่รู้สึก
แต่ถ้า Prediction ใช้เวลา 5 วินาที ทุก Request ก็ต้องรอ 5 วินาที
และเมื่อมีผู้ใช้จำนวนมากเข้ามาพร้อมกัน ปัญหาก็ยิ่งชัดขึ้น
ดังนั้นโมเดลที่มี Accuracy สูงที่สุด ไม่ได้แปลว่าเป็นโมเดลที่เหมาะกับ Production ที่สุดเสมอไป
บางครั้งการยอมเสีย Accuracy ไปเล็กน้อย เพื่อแลกกับโมเดลที่เร็วกว่า ใช้ Memory น้อยกว่า และรองรับ Request ได้มากกว่า ก็คุ้มค่ากว่า
นี่คือ Trade-off ใหม่ที่เกิดขึ้นเมื่อโมเดลออกจาก Notebook:
Prediction Quality ↔ Latency ↔ Cost
โมเดลที่ดีใน Production จึงไม่ใช่แค่โมเดลที่ ทำนายแม่น
แต่ต้อง เร็วพอ เสถียรพอ และมีต้นทุนที่รับได้ ด้วย
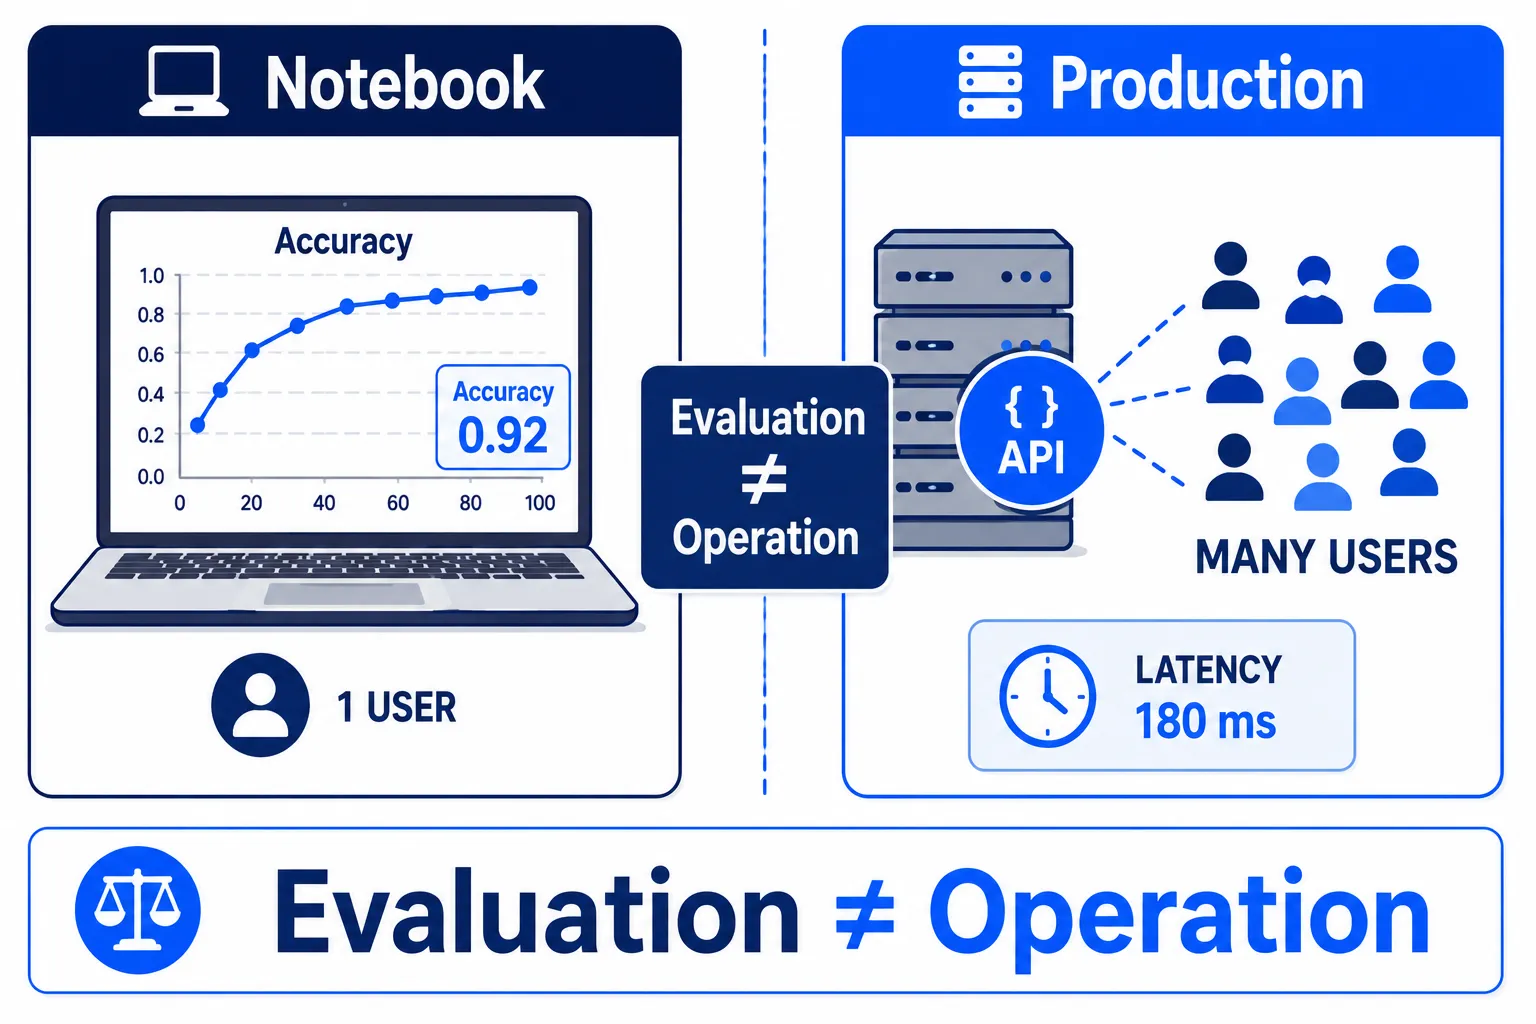
นี่คือความแตกต่างสำคัญระหว่างการ Evaluate Model กับการ Operate Model
ในห้องเรียน อาจจบด้วยตัวเลขเดียว:
Accuracy = 94%
แต่ใน Production ต้องถามต่อไปเรื่อย ๆ ว่า:
ตอนนี้โมเดลยังแม่นอยู่ไหม? ข้อมูลที่เข้ามายังเหมือนเดิมหรือเปล่า? ตอบเร็วพอไหม? รองรับจำนวน Request ได้หรือไม่? และรู้หรือยังว่าคำตอบที่โมเดลให้ไปนั้นถูกจริงหรือไม่?
เพราะใน Production ชุดข้อสอบไม่เคยหมด และโมเดลก็ไม่มีวันสอบเสร็จจริง ๆ
ยังมีอีกสองปัญหาพื้นฐานของ Machine Learning ที่ต้องทบทวนก่อนขึ้น Production คือ Overfitting และ Data Leakage
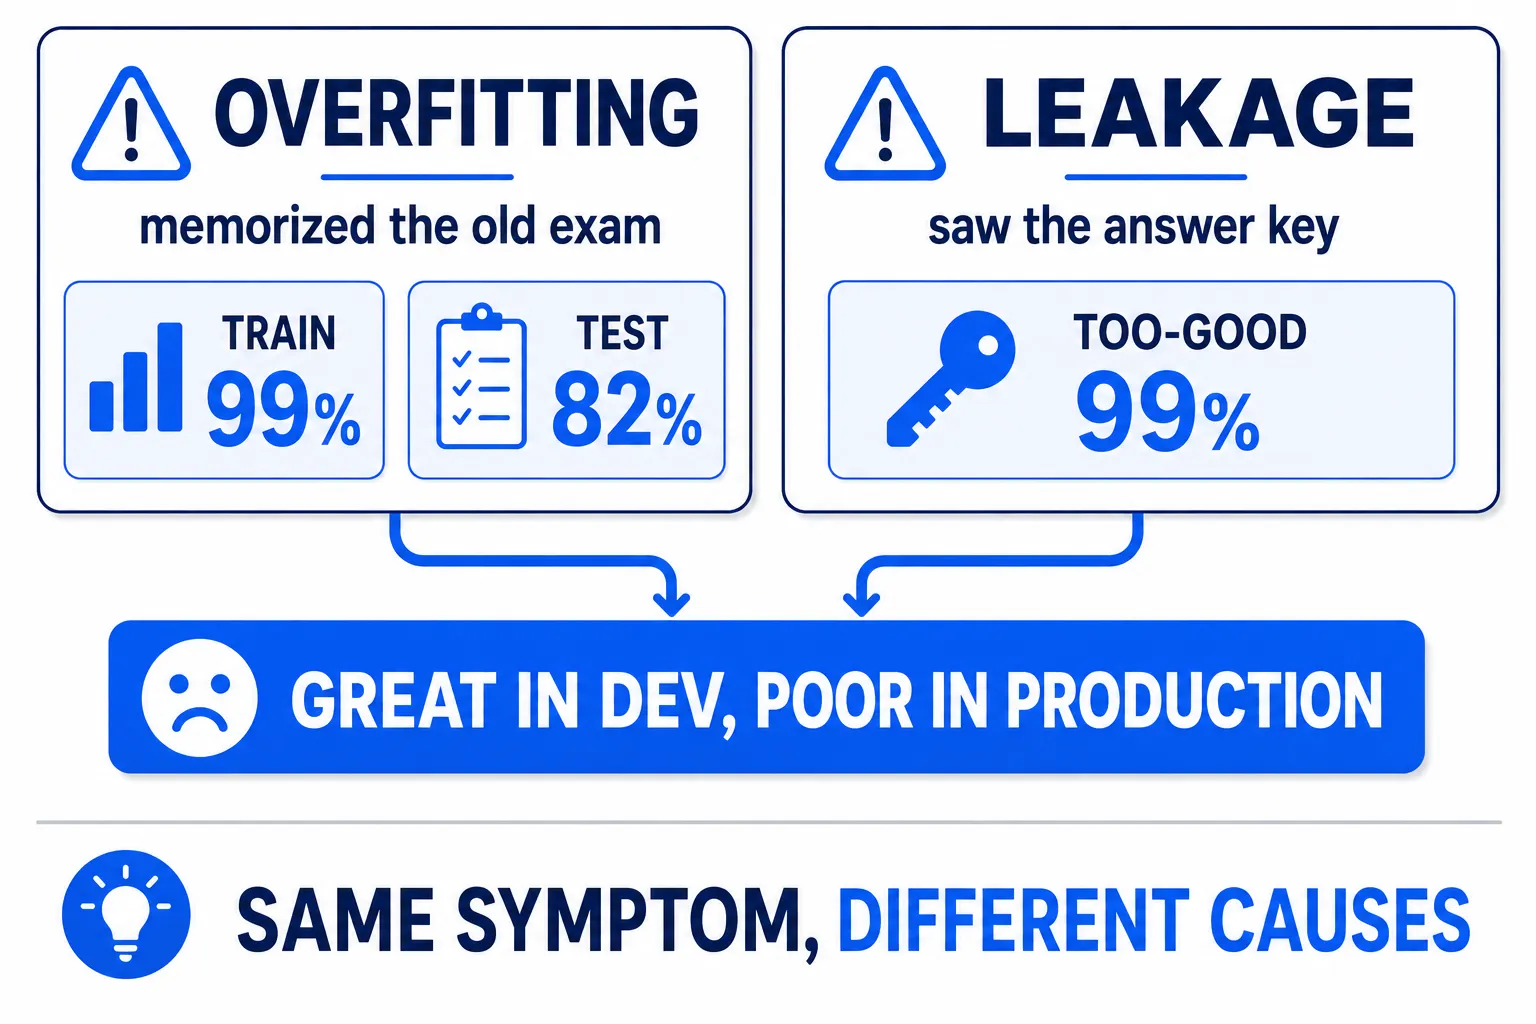
สองอย่างนี้ทำให้เกิดอาการคล้ายกันมาก:
ตอนทดลองดูดีมาก แต่พอใช้จริงกลับแย่กว่าที่คิด
แต่สาเหตุต่างกัน
4.4 Overfitting — จำเก่งเกินไป จนเอาไปใช้กับของใหม่ไม่ได้#
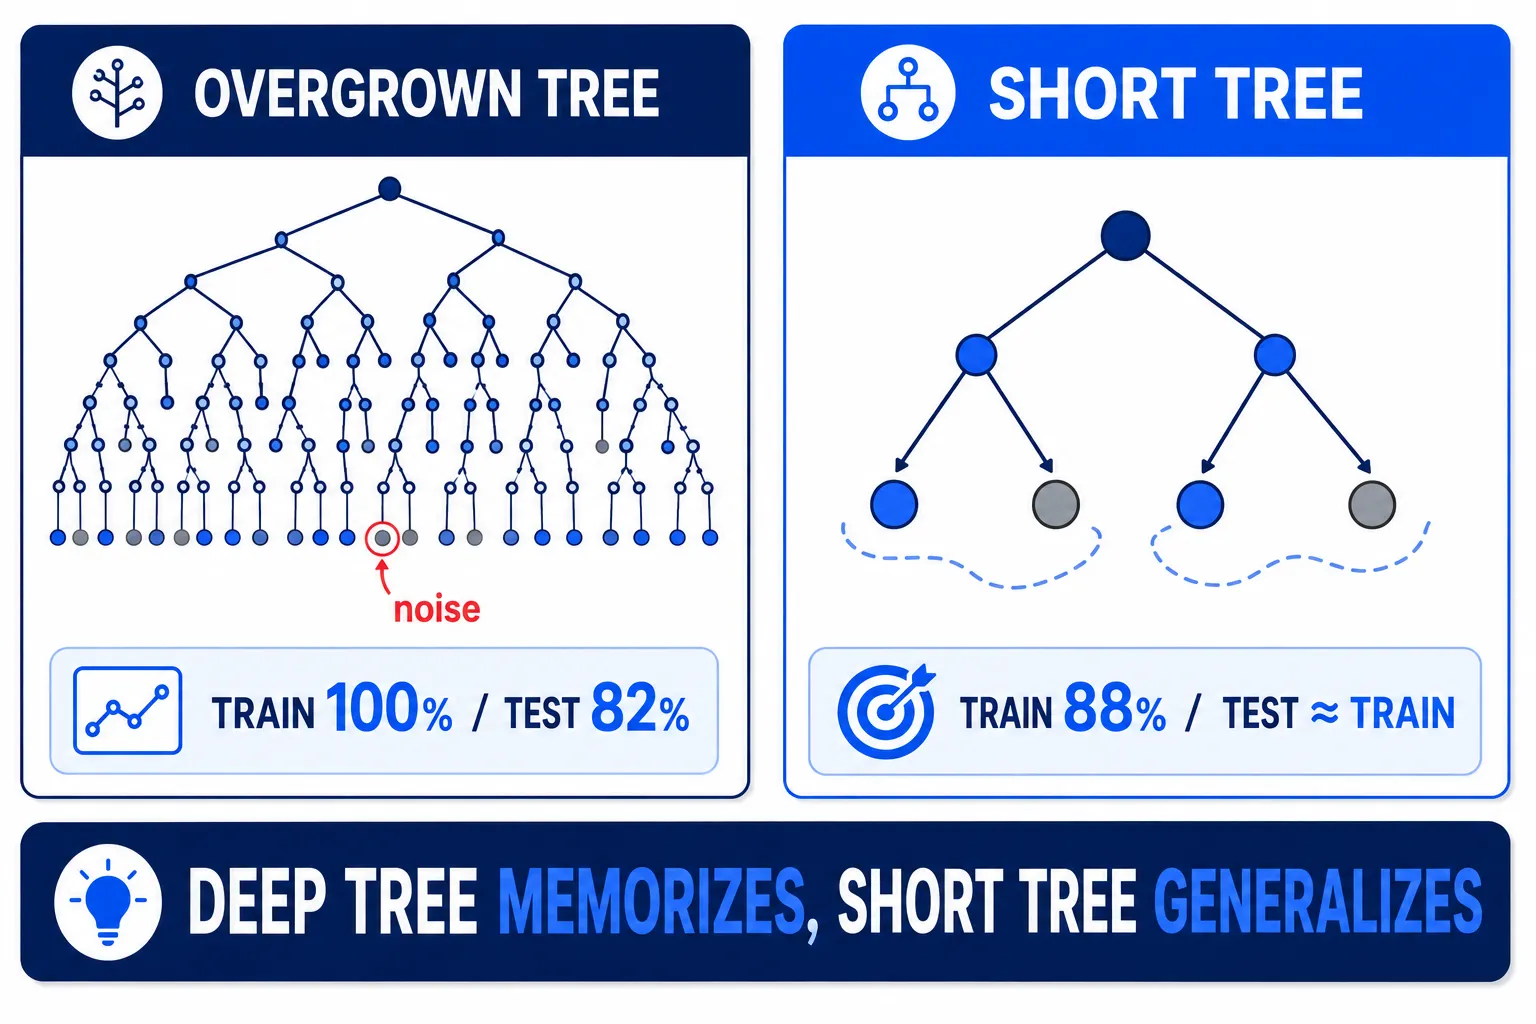
Overfitting เกิดขึ้นเมื่อโมเดลไม่ได้เรียนรู้ Pattern ที่ใช้กับข้อมูลใหม่ได้ดีพอ แต่กลับไปจำรายละเอียดของ Training Data มากเกินไป
ลองนึกถึงนักเรียนที่ไม่ได้เข้าใจเนื้อหา แต่จำข้อสอบเก่าพร้อมเฉลยทั้งหมด
ถ้าข้อสอบจริงออกเหมือนข้อสอบเก่า ก็ได้คะแนนเต็ม
แต่พอเปลี่ยนโจทย์นิดเดียวก็เริ่มทำไม่ได้
Machine Learning ก็เหมือนกัน
อาการที่มักเห็นคือ:
Training Score สูงมาก แต่ Test Score ต่ำกว่าชัดเจน
เช่น:
Training Accuracy = 99%
Test Accuracy = 82%
เห็นกับตาได้ด้วยไฟล์จริง — สร้าง signups.csv โจทย์ทำนายว่าลูกค้าจะ subscribe หรือไม่ (แถวส่วนใหญ่ตาม pattern “มาเยี่ยมมากกว่า 2 ครั้ง = subscribe” แต่มี 2 แถวที่ไม่ตาม pattern ทำหน้าที่เป็น noise):
age,income,visits,subscribed
22,28000,1,0
25,31000,2,0
27,33000,1,0
24,30000,2,0
26,35000,1,0
23,29000,2,0
29,38000,2,0
28,36000,1,0
35,52000,4,1
33,48000,3,1
38,60000,5,1
36,55000,4,1
31,44000,3,1
40,66000,6,1
34,50000,3,0
26,34000,2,1ลอง Decision Tree ที่ไม่จำกัดความลึก:
import pandas as pd
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("signups.csv")
X = df.drop(columns="subscribed")
y = df["subscribed"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)

tree = DecisionTreeClassifier()      # ไม่จำกัดความลึก → โตจนจำทุกแถวได้
tree.fit(X_tr, y_tr)

print("train:", tree.score(X_tr, y_tr))   # 1.0 — จำหมดทุกแถว
print("test :", tree.score(X_te, y_te)) # ต่ำกว่า train ชัดเจนต้นไม้ที่โตเต็มที่สร้างกฎเฉพาะเพื่อจำแม้แต่แถว noise พอเจอข้อมูลใหม่ที่ไม่เคยเห็น จึงเดาผิด
วิธีแก้มีหลายทาง เช่น เพิ่มข้อมูล ลดความซับซ้อนของโมเดล หรือใช้ Regularization เพื่อไม่ให้โมเดลพยายามจำ Training Data มากเกินไป
ลองวิธีที่ง่ายที่สุดดู — จำกัดความลึกของต้นไม้:
simple = DecisionTreeClassifier(max_depth=2)   # บังคับให้เรียนแค่ pattern หลัก
simple.fit(X_tr, y_tr)

print("train:", simple.score(X_tr, y_tr))   # ลดลงจาก 1.0
print("test :", simple.score(X_te, y_te)) # ช่องว่างระหว่าง train–test แคบลงพูดง่าย ๆ คือ:
Overfitting = โมเดลจำมากไป แต่เข้าใจ Pattern จริงน้อยไป
4.5 Data Leakage — โมเดลแอบเห็นเฉลย#
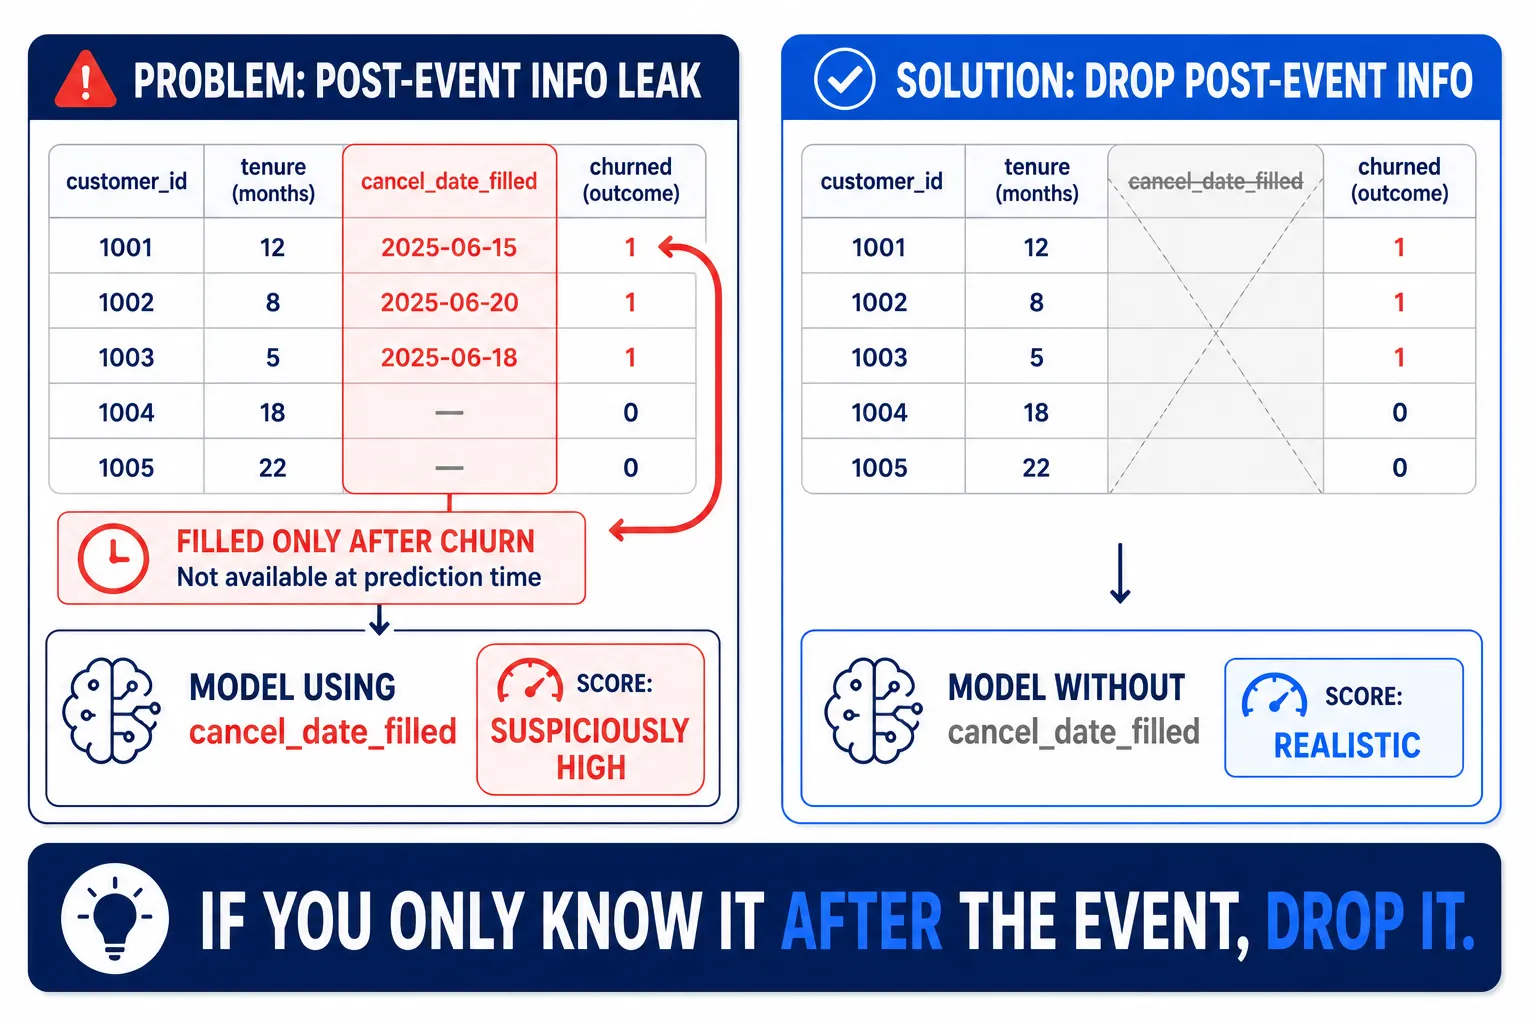
Data Leakage เป็นปัญหาที่เจ้าเล่ห์กว่า เพราะผลการทดลองอาจออกมาดีมากจนดูเหมือนโมเดลยอดเยี่ยม
ถ้าจะจำ Leakage ด้วยประโยคเดียว ให้จำว่า:
Data Leakage = โมเดลแอบได้ดูเฉลย
กฎสำคัญมีเพียงข้อเดียว:
ทุก Feature ที่ใช้ ต้องเป็นข้อมูลที่รู้แล้ว ณ เวลาที่ต้องทำ Prediction จริง
ถ้า Feature บางตัวเกิดขึ้น หลังจากเหตุการณ์ที่กำลังพยายามทำนาย ข้อมูลนั้นไม่ควรถูกใช้เป็น Input
ตัวอย่างเล็กก่อน — สร้าง churn.csv โจทย์ทำนายว่าลูกค้าจะยกเลิกบริการหรือไม่ โดยมีคอลัมน์ cancel_date_filled ที่ระบบกรอก หลัง ลูกค้ายกเลิกไปแล้วเท่านั้น:
months,plan_price,support_calls,cancel_date_filled,churned
14,299,0,0,0
8,499,2,0,0
3,199,1,0,0
11,399,2,0,0
17,599,1,0,0
15,299,3,0,0
6,399,2,1,1
3,599,4,1,1
16,299,3,1,1
4,199,2,1,1
2,499,5,1,1
12,399,1,1,1ลอง train สองแบบ — ใช้และไม่ใช้คอลัมน์นั้น (แบ่ง train/test ชุดเดียวกันเพื่อเทียบให้ยุติธรรม):
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("churn.csv")
X_leaky = df.drop(columns="churned")                          # มี cancel_date_filled
X_clean = X_leaky.drop(columns="cancel_date_filled")          # ตัดคอลัมน์ที่รู้ค่าทีหลังออก
y = df["churned"]

X_tr, X_te, y_tr, y_te = train_test_split(X_leaky, y, test_size=0.25, random_state=42)
X_tr_c = X_tr.drop(columns="cancel_date_filled")
X_te_c = X_te.drop(columns="cancel_date_filled")

leaky = RandomForestClassifier(random_state=42).fit(X_tr, y_tr)
clean = RandomForestClassifier(random_state=42).fit(X_tr_c, y_tr)

print("มีคอลัมน์ leakage :", leaky.score(X_te, y_te))    # สูงผิดปกติ
print("ตัดคอลัมน์ทิ้ง :", clean.score(X_te_c, y_te)) # ต่ำกว่า — และนี่คือตัวเลขจริงคอลัมน์เดียวที่รู้ค่า “ทีหลัง” ดันคะแนนให้ดูดีเกินจริง ทั้งที่พอขึ้น Production คอลัมน์นี้จะเป็น 0 สำหรับทุกคน เพราะตอนทำนายยังไม่มีใครยกเลิกเลย
และถ้าอยากเห็นเวอร์ชันที่อันตรายกว่านี้จากโรงพยาบาลจริง ไปต่อที่กรณีศึกษาถัดไป
4.6 กรณีศึกษา: โมเดลทำนายการเข้า ICU#
สมมติโรงพยาบาลต้องการสร้างโมเดลเพื่อทำนาย ตั้งแต่ตอนผู้ป่วยเข้ารับการรักษา ว่าผู้ป่วยคนใดมีความเสี่ยงที่จะอาการทรุดจนต้องย้ายเข้า ICU
ทีมข้อมูลรวบรวม Features จำนวนมากจากเวชระเบียน เช่น:
- อายุ
- ความดันโลหิต
- ผลตรวจทางห้องปฏิบัติการ
- ยาที่ได้รับ
- โรคประจำตัว
และมีอีกหนึ่งคอลัมน์ชื่อ:
icu_transfer_count
ซึ่งหมายถึง จำนวนครั้งที่ผู้ป่วยถูกย้ายเข้า ICU
ไฟล์ patients.csv เวอร์ชันย่อสำหรับทดลอง (ของจริงมีหลักพันแถว):
age,blood_pressure,lab_result,icu_transfer_count,icu_admitted
68,150,1.9,2,1
61,152,2.1,0,0
72,146,2.4,3,1
66,138,1.8,0,0
65,154,2.2,1,1
69,135,2.3,0,0
70,144,1.6,2,1
63,148,1.5,0,0
67,141,2.0,3,1
62,147,1.7,0,0
71,149,1.2,1,1
64,139,2.5,0,0Train ด้วยทุกคอลัมน์รวม icu_transfer_count:
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

df = pd.read_csv("patients.csv")
X = df.drop(columns="icu_admitted")
y = df["icu_admitted"]

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)
model = RandomForestClassifier(random_state=42).fit(X_tr, y_tr)
print(model.score(X_te, y_te)) # คะแนนดีผิดปกติ — สงสัยไว้ก่อนได้เลยจากนั้นนำข้อมูลทั้งหมดไป Train โมเดล
ผลออกมาสวยมาก:
Accuracy = 99%
ทุกคนดีใจ เพราะดูเหมือนว่าโมเดลรู้ได้เกือบหมดว่าใครจะต้องเข้า ICU
แต่จริง ๆ แล้วโมเดลอาจค้นพบ Shortcut ง่าย ๆ:
ถ้า icu_transfer_count > 0
→ ผู้ป่วยมีโอกาสเป็นเคสรุนแรงมาก
ดูเผิน ๆ เหมือนโมเดลเก่งมาก
แต่ลองถามคำถามสำคัญ:
icu_transfer_countถูกกรอกเมื่อไหร่?
คำตอบคือ หลังจากผู้ป่วยถูกย้ายเข้า ICU ไปแล้ว
นี่คือปัญหา
โจทย์คือสร้างโมเดลเพื่อทำนายว่า “ผู้ป่วยคนนี้จะต้องเข้า ICU หรือไม่?”
แต่กลับป้อนข้อมูลที่บอกทางอ้อมว่า “ผู้ป่วยคนนี้เข้า ICU ไปแล้วกี่ครั้ง”
โมเดลจึงไม่ได้เรียนรู้การทำนายอนาคต
แต่แค่ อ่านอนาคตที่หลุดเข้ามาอยู่ในข้อมูล Training
ผลลัพธ์ถูกปลอมตัวมาเป็น Input
แล้วเกิดอะไรขึ้นตอน Deploy?#
ตอน Training ข้อมูลถูกดึงจากเวชระเบียนย้อนหลัง
ดังนั้นผู้ป่วยที่เคยเข้า ICU แล้วอาจมีค่า:
icu_transfer_count = 2
โมเดลจึงใช้ Feature นี้เป็นสัญญาณสำคัญในการทำนาย
แต่ใน Production ต้องการ Prediction ตั้งแต่ตอนรับผู้ป่วยเข้าโรงพยาบาล
ณ เวลานั้น ผู้ป่วยยังไม่ได้ถูกย้ายเข้า ICU
ดังนั้น:
icu_transfer_count = 0
สำหรับแทบทุกคน
Feature ที่เคยช่วยให้โมเดลได้ Accuracy 99% จึงแทบไม่มีประโยชน์เลยในเวลาที่ต้องใช้งานจริง
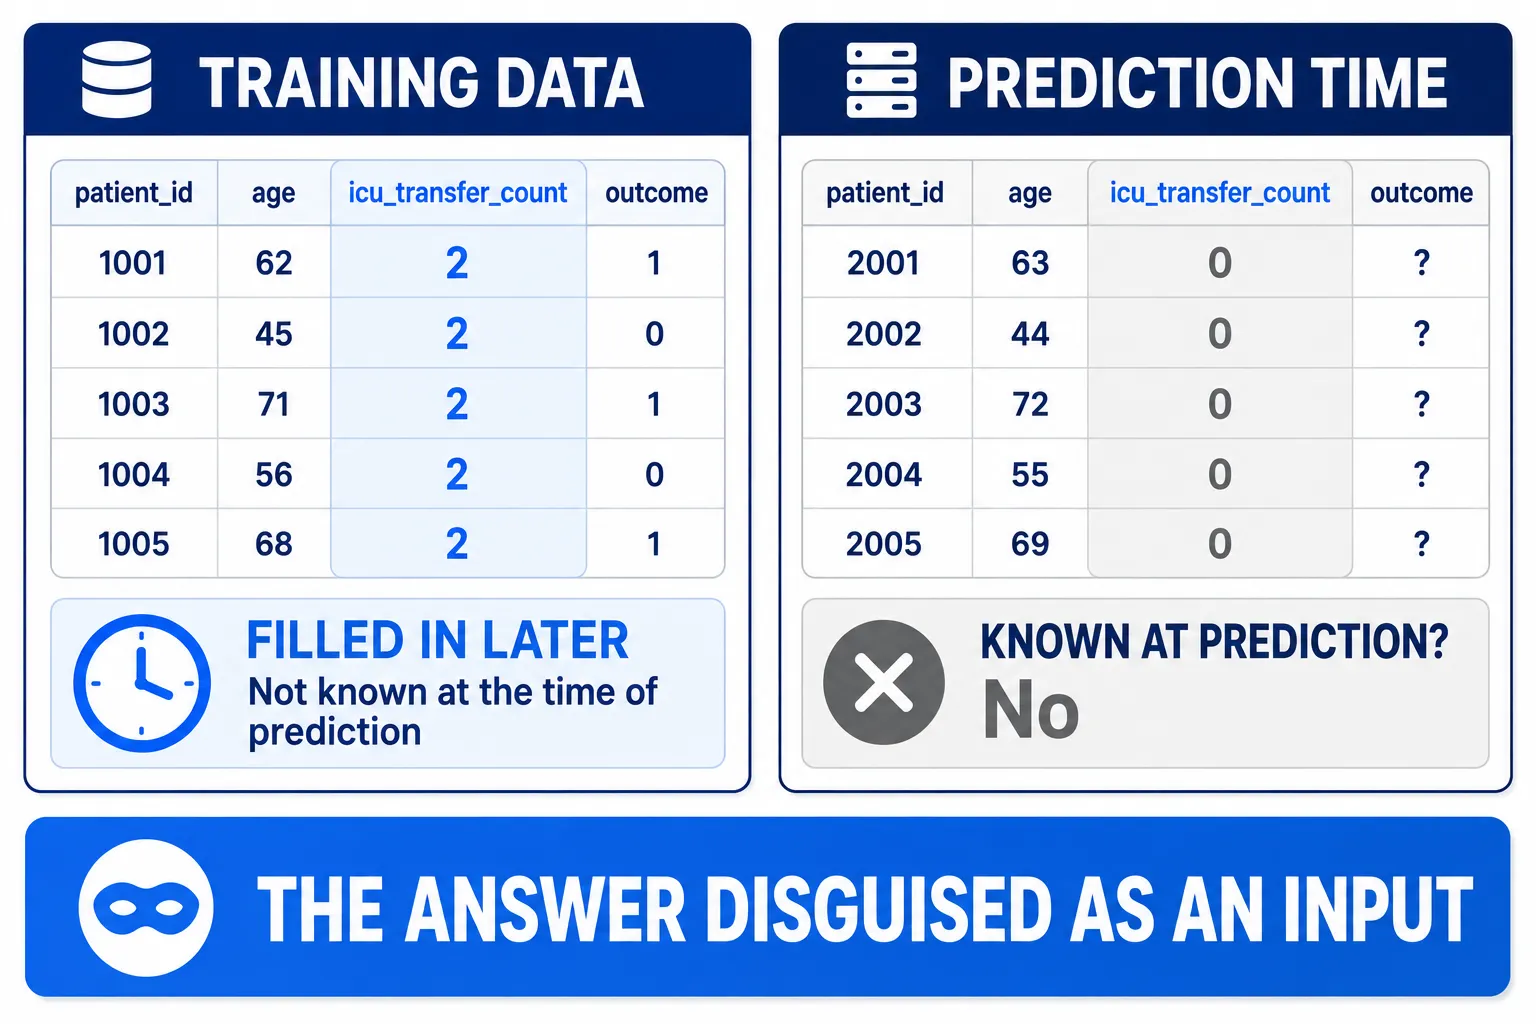
ลองเทียบให้ชัด ๆ:
| ตอน Training | ตอน Prediction จริง | |
|---|---|---|
| ผู้ป่วยที่ภายหลังต้องเข้า ICU | icu_transfer_count = 2 | icu_transfer_count = 0 |
| ผู้ป่วยที่ไม่ต้องเข้า ICU | icu_transfer_count = 0 | icu_transfer_count = 0 |
คอลัมน์ชื่อเดียวกัน แต่ ความหมายของข้อมูลต่างกันอย่างสิ้นเชิง
ตอน Training เป็นการมองข้อมูลย้อนหลังและเห็นสิ่งที่เกิดขึ้นไปแล้ว
แต่ตอน Prediction เป็นการยืนอยู่ในปัจจุบัน และพยายามทำนายสิ่งที่ ยังไม่เกิดขึ้น
นี่คือจุดที่ Data Leakage มักซ่อนตัวอยู่
คำถามเดียวที่ช่วยจับ Leakage ได้#
เวลาจะเลือก Feature ไม่ต้องเริ่มจากคำถามซับซ้อน
ให้ถามทุกคอลัมน์ว่า:
“ณ วินาทีที่ระบบต้องทำ Prediction จริง ๆ รู้ค่านี้แล้วหรือยัง?”
ถ้าคำตอบคือ รู้แล้ว ก็มีโอกาสใช้เป็น Feature ได้
- อายุตอนรับเข้า → รู้แล้ว
- ความดันตอนรับเข้า → รู้แล้ว
- ผล Lab ที่ออกก่อนเวลาทำนาย → รู้แล้ว
- จำนวนครั้งที่ถูกย้ายเข้า ICU หลังจากรับเข้า → ยังไม่รู้
ถ้ายังไม่รู้ ณ เวลาที่ต้อง Prediction ก็ไม่ควรให้โมเดลเห็นข้อมูลนั้น
4.7 Overfitting กับ Leakage ต่างกันอย่างไร?#
ทั้งคู่ทำให้โมเดลดูดีตอนพัฒนา แต่พังเมื่อเจอโลกจริง
แต่ต้นเหตุไม่เหมือนกัน:
| Overfitting | Data Leakage | |
|---|---|---|
| ปัญหาคือ | โมเดลจำ Training Data มากเกินไป | โมเดลได้รับข้อมูลที่ไม่ควรรู้ |
| อาการทั่วไป | Training ดี แต่ Test แย่ | Training และ Test อาจดีมากผิดปกติ |
| ปัญหาหลัก | Generalize กับข้อมูลใหม่ไม่ได้ | Evaluation หลอกว่าโมเดลเก่ง |
| วิธีคิดง่าย ๆ | จำข้อสอบเกินไป | แอบเห็นเฉลย |
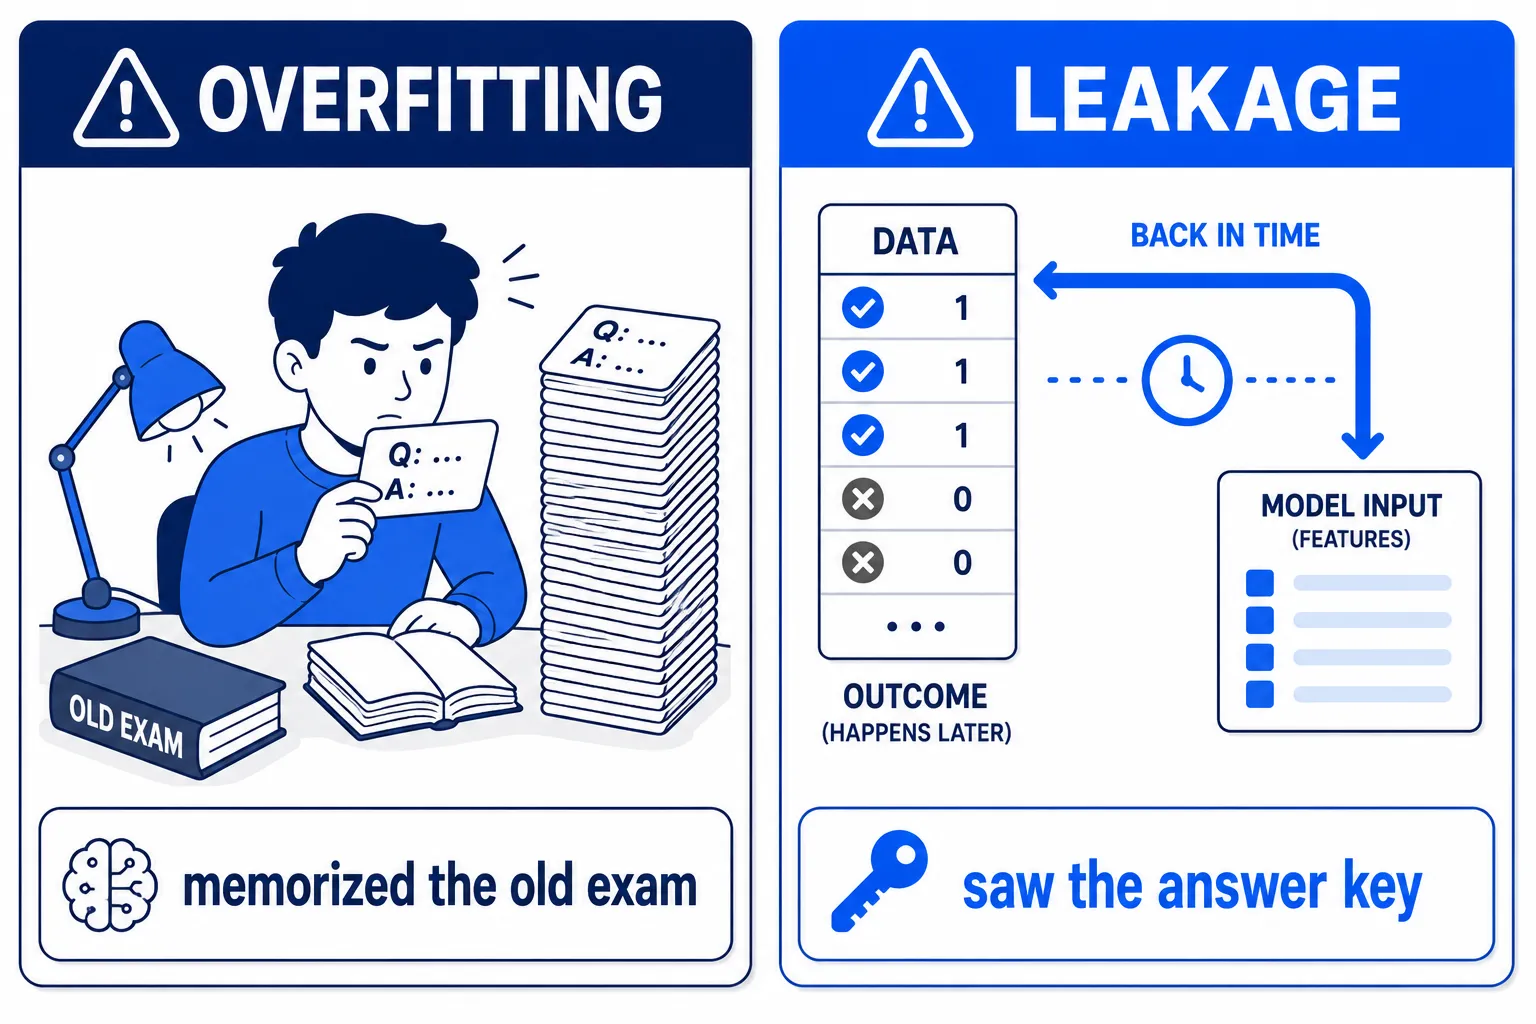
Data Leakage จึงเป็นหนึ่งในความผิดพลาดที่อันตรายมากของ Machine Learning เพราะไม่ได้ทำให้ผลการทดลองดูแย่
ตรงกันข้าม — กลับทำให้ผลดูดีเกินจริง
Accuracy สูง Test ผ่าน กราฟสวย ทุกคนคิดว่าพร้อม Deploy
จนกระทั่งระบบเจอข้อมูลจริง
แล้วถึงค่อยพบว่าโมเดลที่คิดว่าแม่น 99% นั้น จริง ๆ แล้วไม่ได้เก่งในการทำนายอนาคตเลย
ก่อนใช้ Feature ใด ๆ อย่าถามแค่ว่า “Feature นี้ช่วยให้โมเดลแม่นขึ้นไหม?” ต้องถามด้วยว่า “ตอนใช้งานจริง จะมีข้อมูลนี้อยู่ในมือแล้วหรือยัง?”
4.8 Model Decay: เหตุผลที่ Monitoring มีอยู่#
เริ่มจากความจริงง่าย ๆ ข้อหนึ่ง:
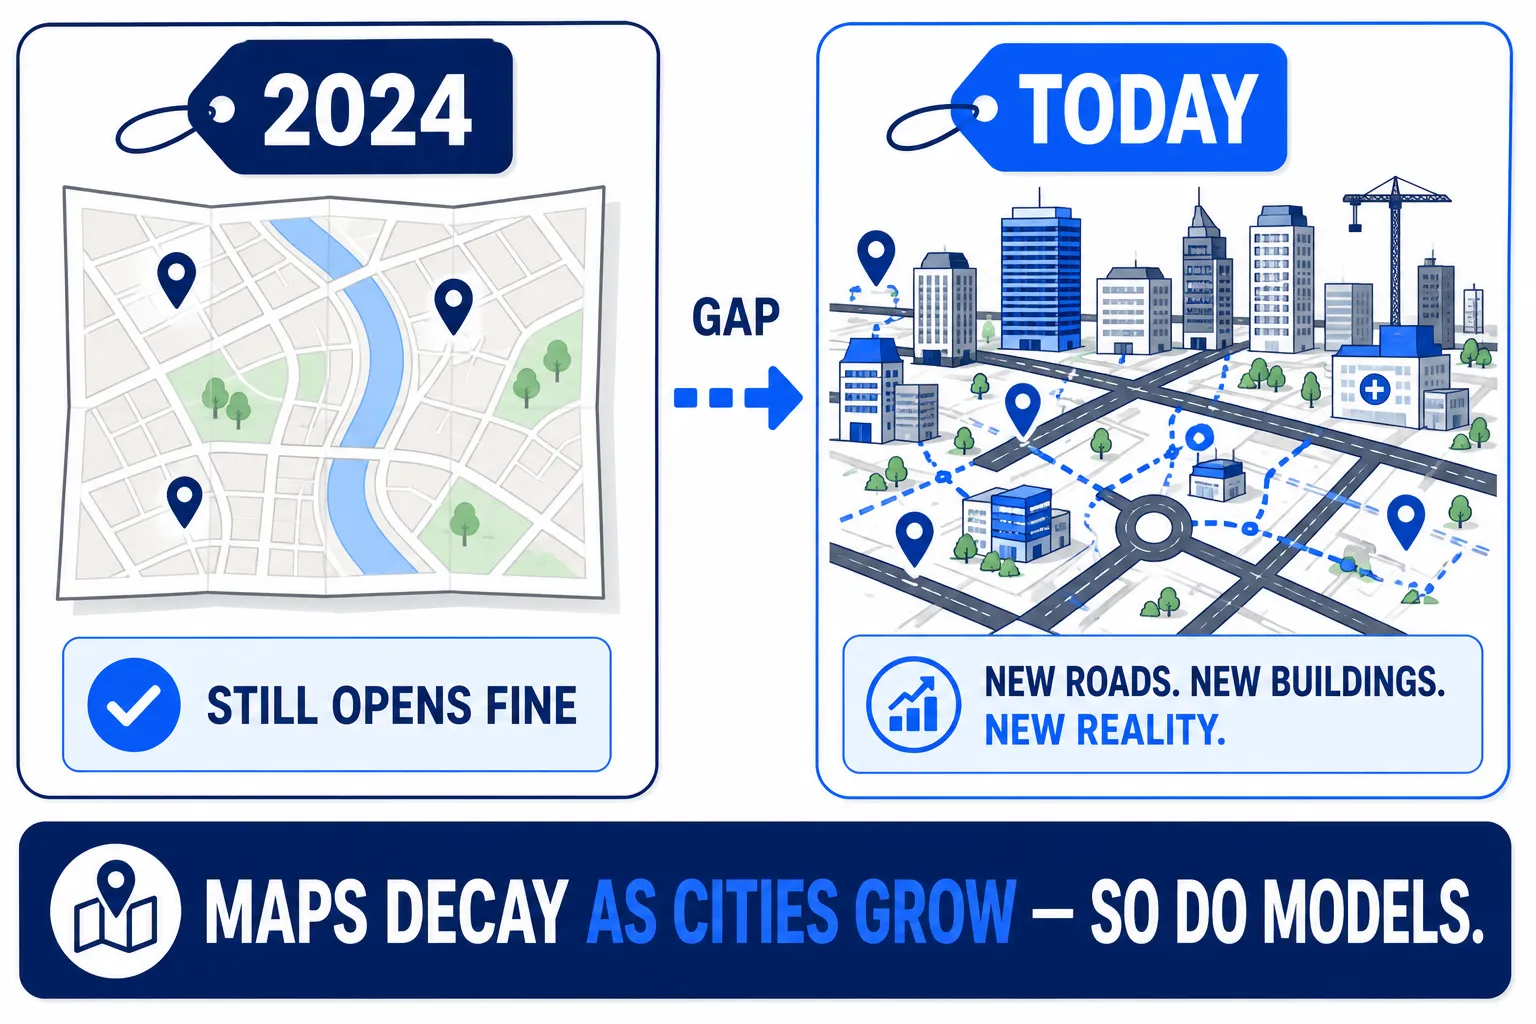
โมเดลเรียนรู้จากโลกในอดีต แต่ต้องทำงานอยู่ในโลกปัจจุบัน
ลองนึกว่าโมเดลเป็นเหมือน แผนที่เมือง
แผนที่ถูกวาดในปี 2024 จากถนน อาคาร และเส้นทางที่มีอยู่ในตอนนั้น เมื่อวาดเสร็จ แผนที่ก็หยุดอยู่ตรงนั้น
แต่เมืองจริงไม่ได้หยุดตามไปด้วย
มีถนนใหม่ ร้านใหม่ พฤติกรรมการเดินทางใหม่ ๆ เกิดขึ้นตลอดเวลา
แผนที่ไม่ได้ “พัง” ยังเปิดดูได้เหมือนเดิม เพียงแต่ค่อย ๆ ไม่ตรงกับโลกจริงมากขึ้นเรื่อย ๆ
Machine Learning Model ก็เหมือนกัน
เมื่อโมเดลเริ่ม Decay หรือคุณภาพลดลง มักมีสาเหตุสำคัญอยู่สองแบบคือ Data Drift และ Concept Drift
Data Drift — เมื่อคนที่เดินเข้าประตูเปลี่ยนไป#
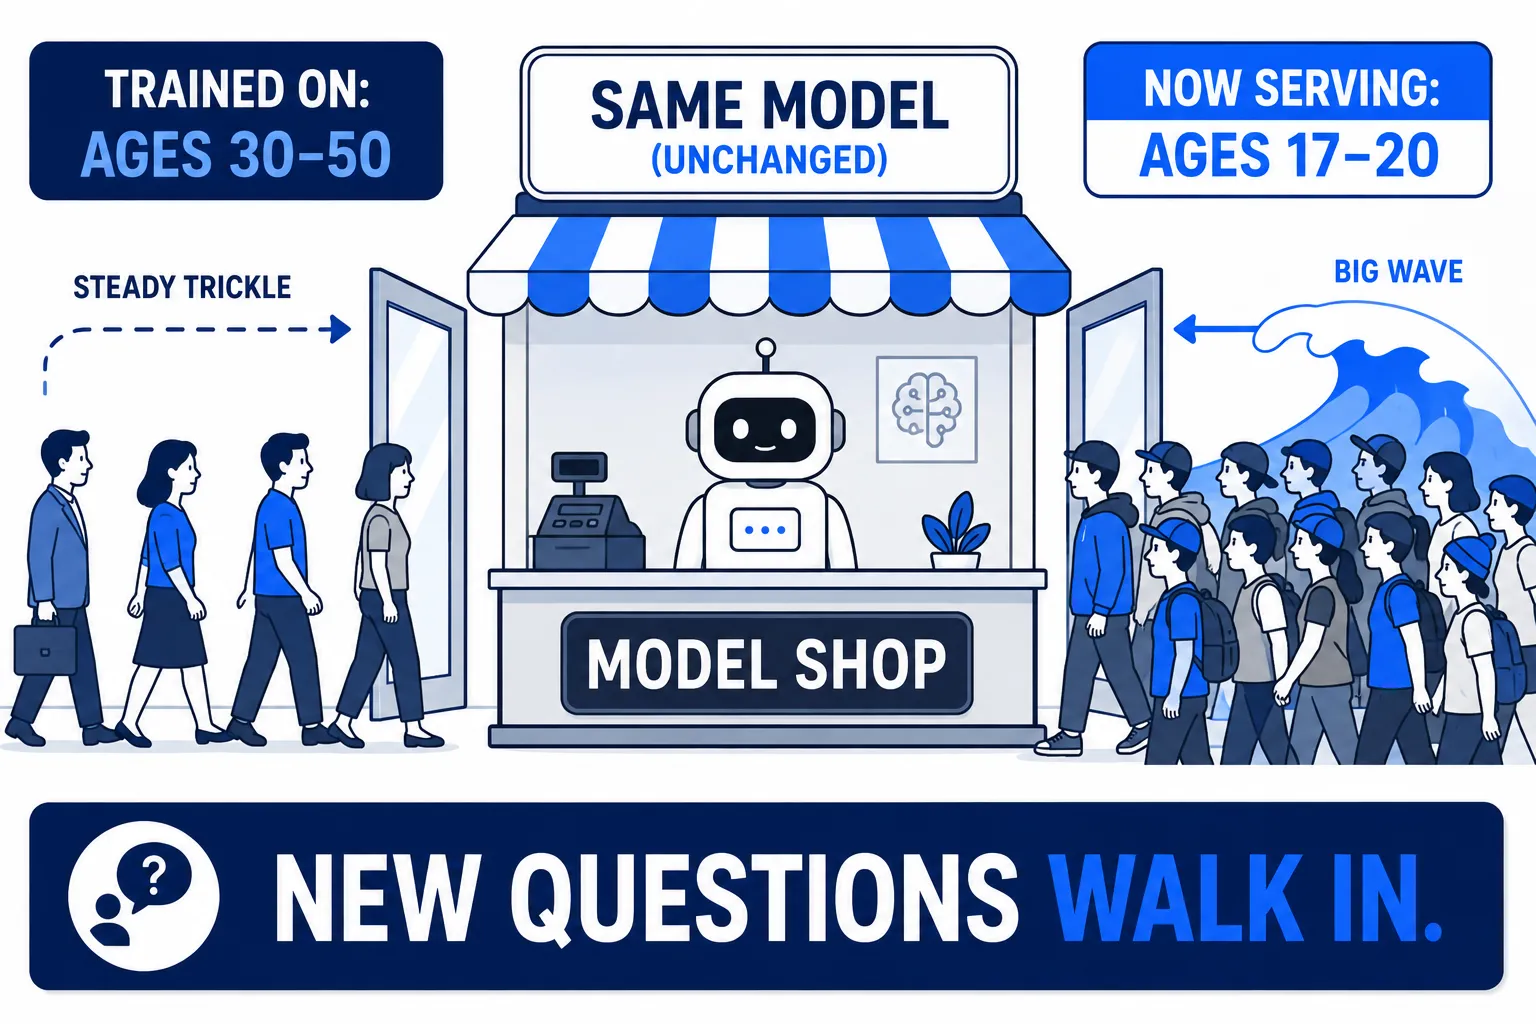
สมมติว่ามีโมเดลเพื่อทำนายว่าลูกค้าจะซื้อสินค้าอะไร
ข้อมูลที่ใช้ Train มาจากลูกค้าในปี 2024 ซึ่งส่วนใหญ่อายุประมาณ 30–50 ปี
โมเดลจึงเรียนรู้พฤติกรรมของลูกค้ากลุ่มนี้ได้ค่อนข้างดี
วันหนึ่งฝ่าย Marketing เปิดแคมเปญบน TikTok แล้วประสบความสำเร็จมาก
ทันใดนั้น ลูกค้าอายุ 17–20 ปีจำนวนมากเริ่มเข้ามาใช้ระบบ
ปัญหาคือโมเดล แทบไม่เคยเห็นลูกค้ากลุ่มนี้ตอน Training
โมเดลยังตอบ Prediction ตามปกติ ไม่มี Error และอาจตอบด้วย Confidence สูงด้วยซ้ำ
แต่ตอนนี้กลายเป็นการขอให้โมเดลตอบคำถามเกี่ยวกับกลุ่มคนที่ไม่ค่อยรู้จัก
นี่คือ Data Drift
Input เปลี่ยน แต่ Model ยังเป็นตัวเดิม
หรือจำง่าย ๆ ว่า:
Data Drift = ข้อมูลแบบใหม่เดินเข้าประตูมา
Concept Drift — ข้อมูลดูเหมือนเดิม แต่ความหมายเปลี่ยนไป#
Concept Drift ต่างออกไปเล็กน้อย
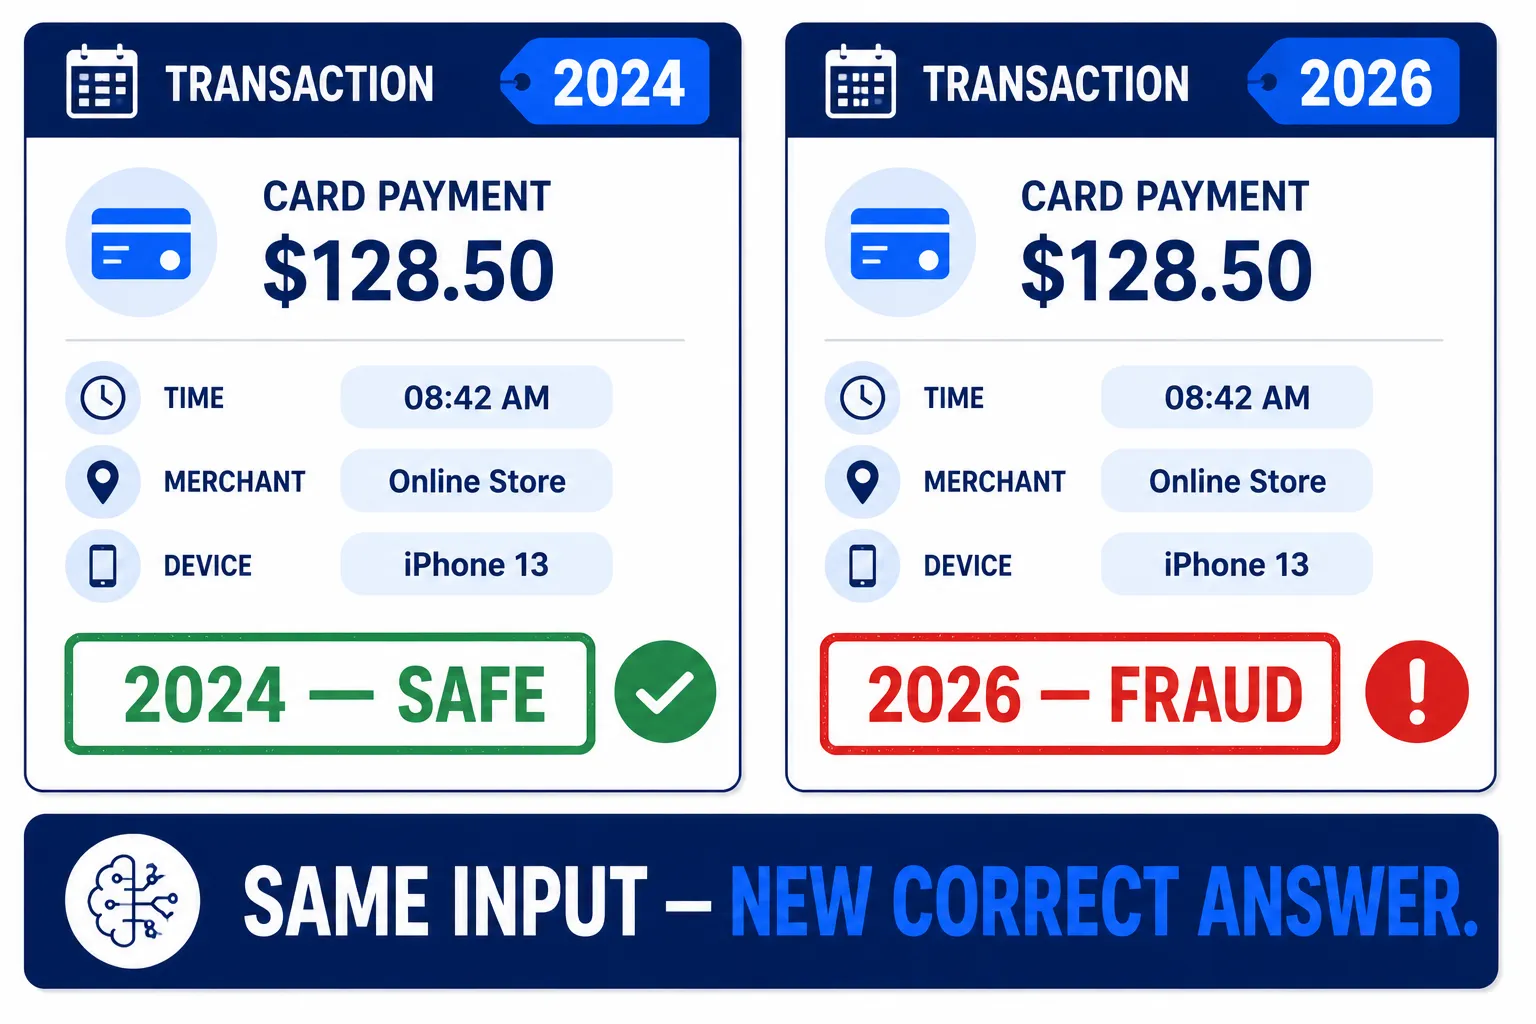
สมมติว่ามี Fraud Detection Model สร้างขึ้นในปี 2024
โมเดลเรียนรู้ว่า Transaction ที่มีลักษณะประมาณนี้น่าสงสัย:
- ซื้อหลายครั้งติดกัน
- จำนวนเงินไม่มาก
- เกิดในเวลาผิดปกติ
- มาจาก Device ใหม่
เวลาผ่านไป Fraudster ก็ปรับตัว
แทนที่จะทำ Transaction เล็ก ๆ จำนวนมากในเวลาผิดปกติ พวกเขาอาจเปลี่ยนวิธีเป็น Transaction จำนวนเงินสูงขึ้น ทำในเวลาปกติ และใช้ Account หรือ Device ที่ถูกขโมยมา
ข้อมูลบางอย่างอาจยังดูเหมือน Transaction ปกติที่โมเดลเคยเห็น
แต่ ความสัมพันธ์ระหว่าง Input กับคำตอบเปลี่ยนไปแล้ว
Pattern ที่เมื่อก่อนอาจหมายถึง “ปลอดภัย” วันนี้อาจหมายถึง “Fraud”
นี่คือ Concept Drift
Input คล้ายเดิม แต่คำตอบที่ถูกต้องเปลี่ยนไป
ถ้าจะจำความแตกต่างระหว่างสองคำนี้ด้วยประโยคเดียว:
Data Drift = คำถามใหม่ Concept Drift = คำตอบใหม่ของคำถามเดิม
4.9 สิ่งที่น่ากลัวคือ ทั้งคู่เกิดขึ้นแบบเงียบ ๆ#
Server อาจยังทำงานปกติ
API ยังตอบ:
200 OK
Latency ยัง 30 ms CPU ยัง 40% Error Rate ยัง 0%
Dashboard ฝั่ง Infrastructure อาจเขียวทั้งหมด
แต่ Prediction ของโมเดลกำลังแย่ลงเรื่อย ๆ
และตัวโมเดลเองไม่สามารถยกมือขึ้นมาบอกว่า:
“ช่วงนี้ข้อมูลที่เข้ามาไม่เหมือนที่ฉันเคยเรียนแล้วนะ”
บางครั้งกว่าจะรู้ตัวก็ต่อเมื่อ Ground Truth หรือเฉลยจริงมาถึงในอีกหลายวันหรือหลายสัปดาห์ต่อมา
เช่น Fraud Detection วันนี้บอกว่า Transaction ปลอดภัย แต่สองสัปดาห์ต่อมาลูกค้าแจ้งว่าบัตรถูกขโมย จึงค่อยรู้ว่า Prediction วันนั้นผิด
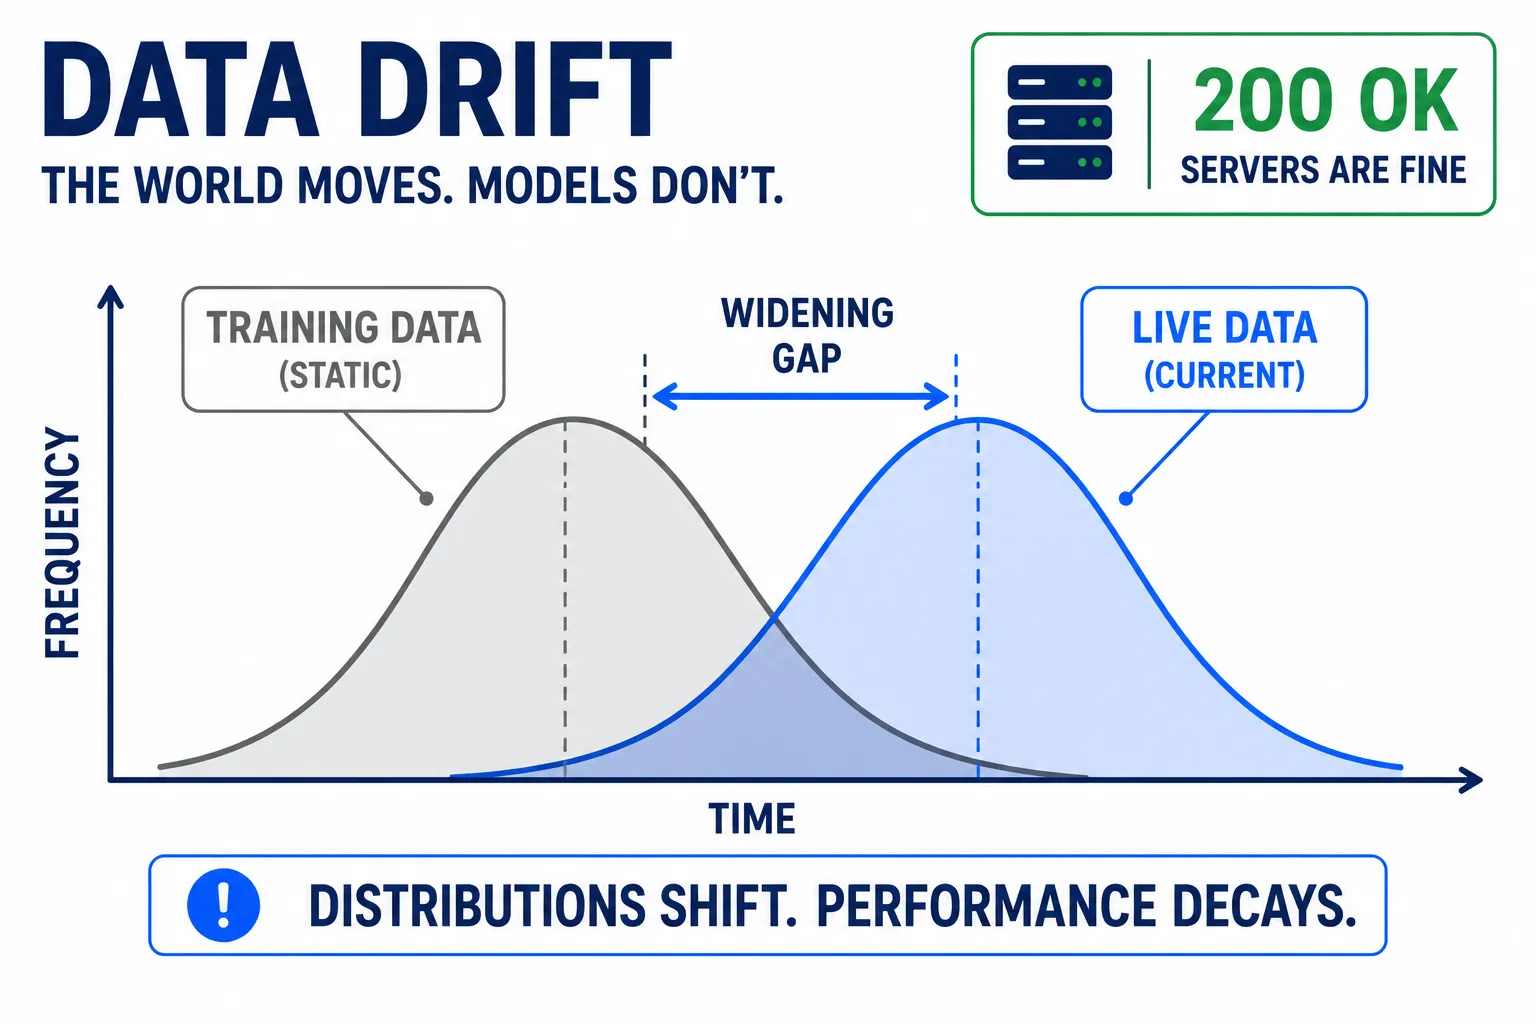
นี่คือเหตุผลที่ Serving Lifecycle ต้องเป็น วงจร ไม่ใช่เส้นตรง
Train → Serve → Monitor → Retrain → Serve → Monitor → …
และนี่คือเหตุผลที่ Production ML ต้องมีมากกว่าแค่ Health Check
Health Check ถามว่า:
“Server ยังทำงานอยู่ไหม?”
แต่ Model Monitoring ถามว่า:
“Model ยังทำงานได้ดีอยู่ไหม?”
สองคำถามนี้ไม่เหมือนกันเลย
Server อาจ Healthy 100% ในขณะที่ Model Quality กำลังลดลงทุกวัน
ดังนั้นระบบจริงจึงต้องมีทั้ง Request Logging, Prediction Monitoring และเมื่อมี Ground Truth ก็ต้องนำกลับมาเปรียบเทียบกับ Prediction
เพราะการที่ API ยังเปิดอยู่ ไม่ได้แปลว่า AI ยังดีอยู่
5. Metrics ที่สอดคล้องกับเงิน#
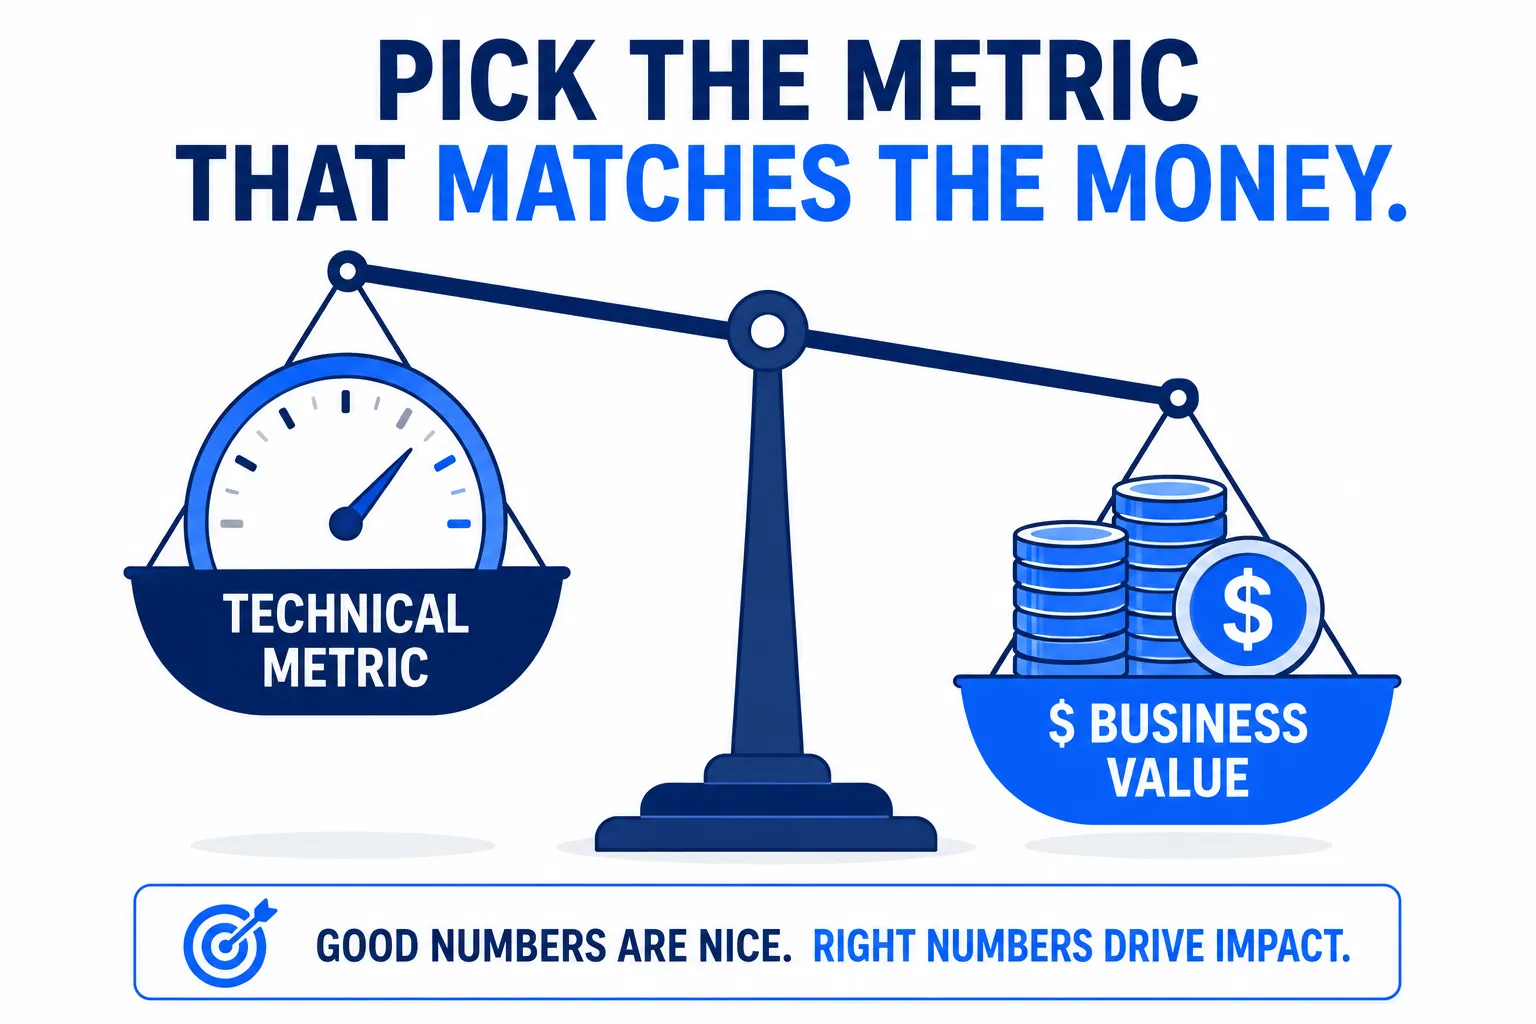
อีกเรื่องที่เปลี่ยนไปเมื่อ Machine Learning ออกจากห้องเรียนคือ Metric ที่ดีที่สุดทางเทคนิค อาจไม่ใช่ Metric ที่สำคัญที่สุดทางธุรกิจ
5.1 Accuracy หลอกได้เมื่อข้อมูลไม่สมดุล#
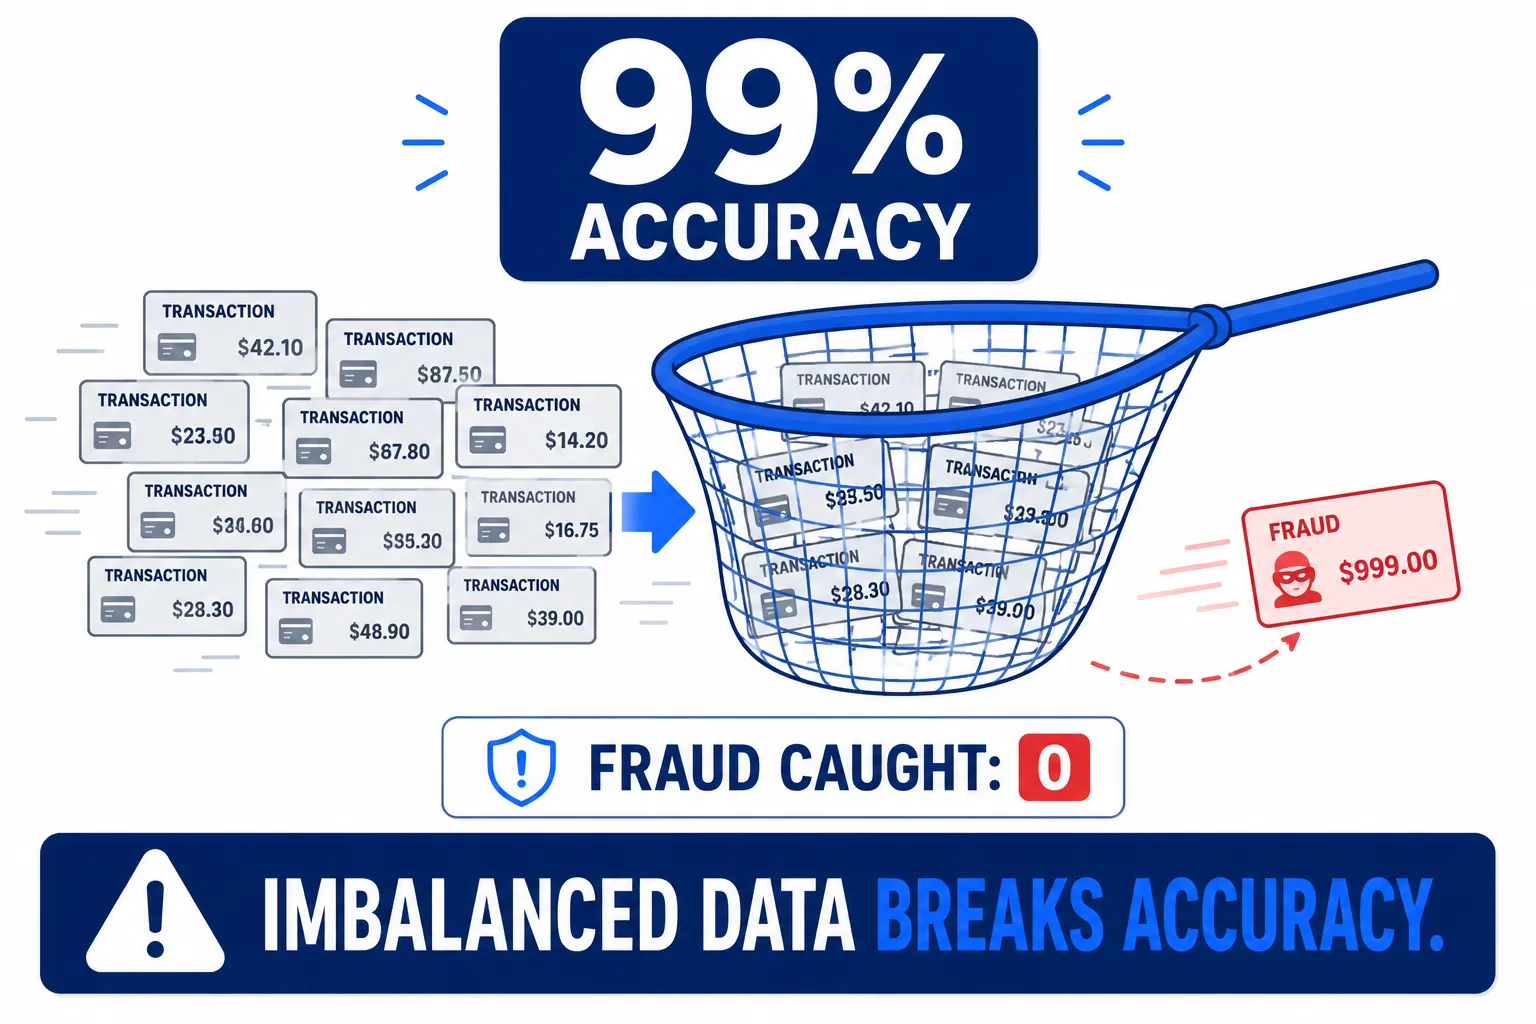
เริ่มจากตัวที่คุ้นเคยที่สุด: Accuracy
สมมติว่ามี Transaction 10,000 รายการ และมีเพียง 1% หรือ 100 รายการที่เป็น Fraud
ลองสร้าง “โมเดล” ง่าย ๆ ที่ตอบทุกครั้งว่า:
“ไม่ใช่ Fraud”
ผลคือตอบถูก 9,900 จาก 10,000 ครั้ง
ดังนั้น:
Accuracy = 99%
ฟังดูยอดเยี่ยม
แต่โมเดลนี้จับ Fraud ได้:
0
สักรายการเดียวก็จับไม่ได้
ลองพิสูจน์ด้วยไฟล์ fraud.csv:
amount,num_last_hour,new_device,night,fraud
120,2,0,0,0
45,1,0,1,0
8900,1,1,1,1
230,0,0,0,0
60,3,0,1,0
150,1,0,0,0
75,2,0,1,0
310,0,0,0,0
99,1,0,1,0import pandas as pd
from sklearn.dummy import DummyClassifier
df = pd.read_csv("fraud.csv")
X = df.drop(columns="fraud")
y = df["fraud"]
always_safe = DummyClassifier(strategy="most_frequent").fit(X, y)
print("accuracy :", always_safe.score(X, y)) # 0.888… (8 จาก 9)
print("fraud ที่จับได้ :", always_safe.predict(X).sum()) # 0ไฟล์ 9 แถวมี Fraud แค่ 1 แถว — ตอบ “ปลอดภัย” ทุกครั้งก็ได้ Accuracy สูงโดยที่ จับ Fraud ได้ 0 รายการ เหมือนกับเรื่อง 99% ของโจทย์จริงที่เล่าไป
นี่คือปัญหาของ Accuracy เมื่อข้อมูลมี Class Imbalance หรือจำนวนตัวอย่างในแต่ละ Class แตกต่างกันมาก
5.2 Confusion Matrix: ดูให้ครบว่าโมเดลผิดแบบไหน#
แทนที่จะดูเพียง Accuracy ต้องดูผลลัพธ์ที่เป็นไปได้ทั้ง 4 แบบ
| โมเดลบอก FRAUD | โมเดลบอก SAFE | |
|---|---|---|
| จริง ๆ เป็น Fraud | ✅ จับได้ | ❌ พลาด Fraud |
| จริง ๆ ปลอดภัย | ❌ False Alarm | ✅ ถูกต้อง |
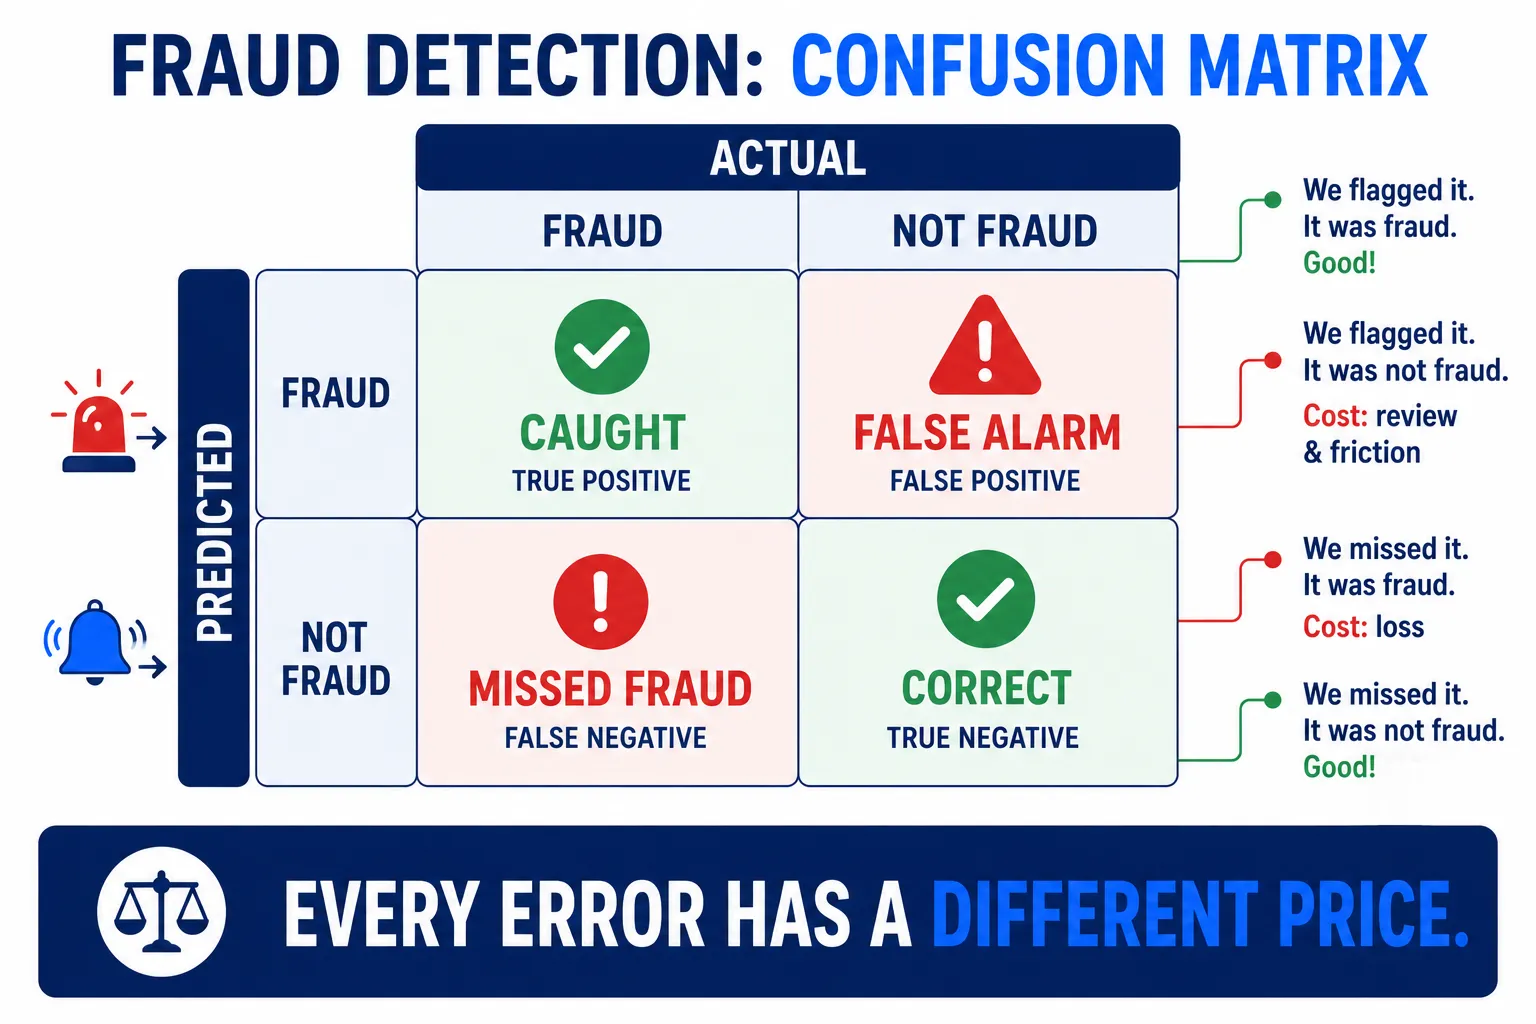
จากตรงนี้จะมี Metric สำคัญสองตัวที่ต้องเข้าใจคือ Precision และ Recall
Precision ถามว่า:
“จากทุกครั้งที่โมเดลแจ้งเตือนว่าเป็น Fraud มีกี่ครั้งที่เป็น Fraud จริง?”
Precision สูง หมายความว่าเวลาโมเดลเตือน มักจะเตือนถูก และมี False Alarm น้อย
ส่วน Recall ถามว่า:
“จาก Fraud ที่เกิดขึ้นจริงทั้งหมด โมเดลจับได้กี่เปอร์เซ็นต์?”
Recall สูง หมายความว่าโมเดลปล่อย Fraud หลุดมือน้อย
5.3 ลองนึกถึงการจับปลา — Precision กับ Recall#
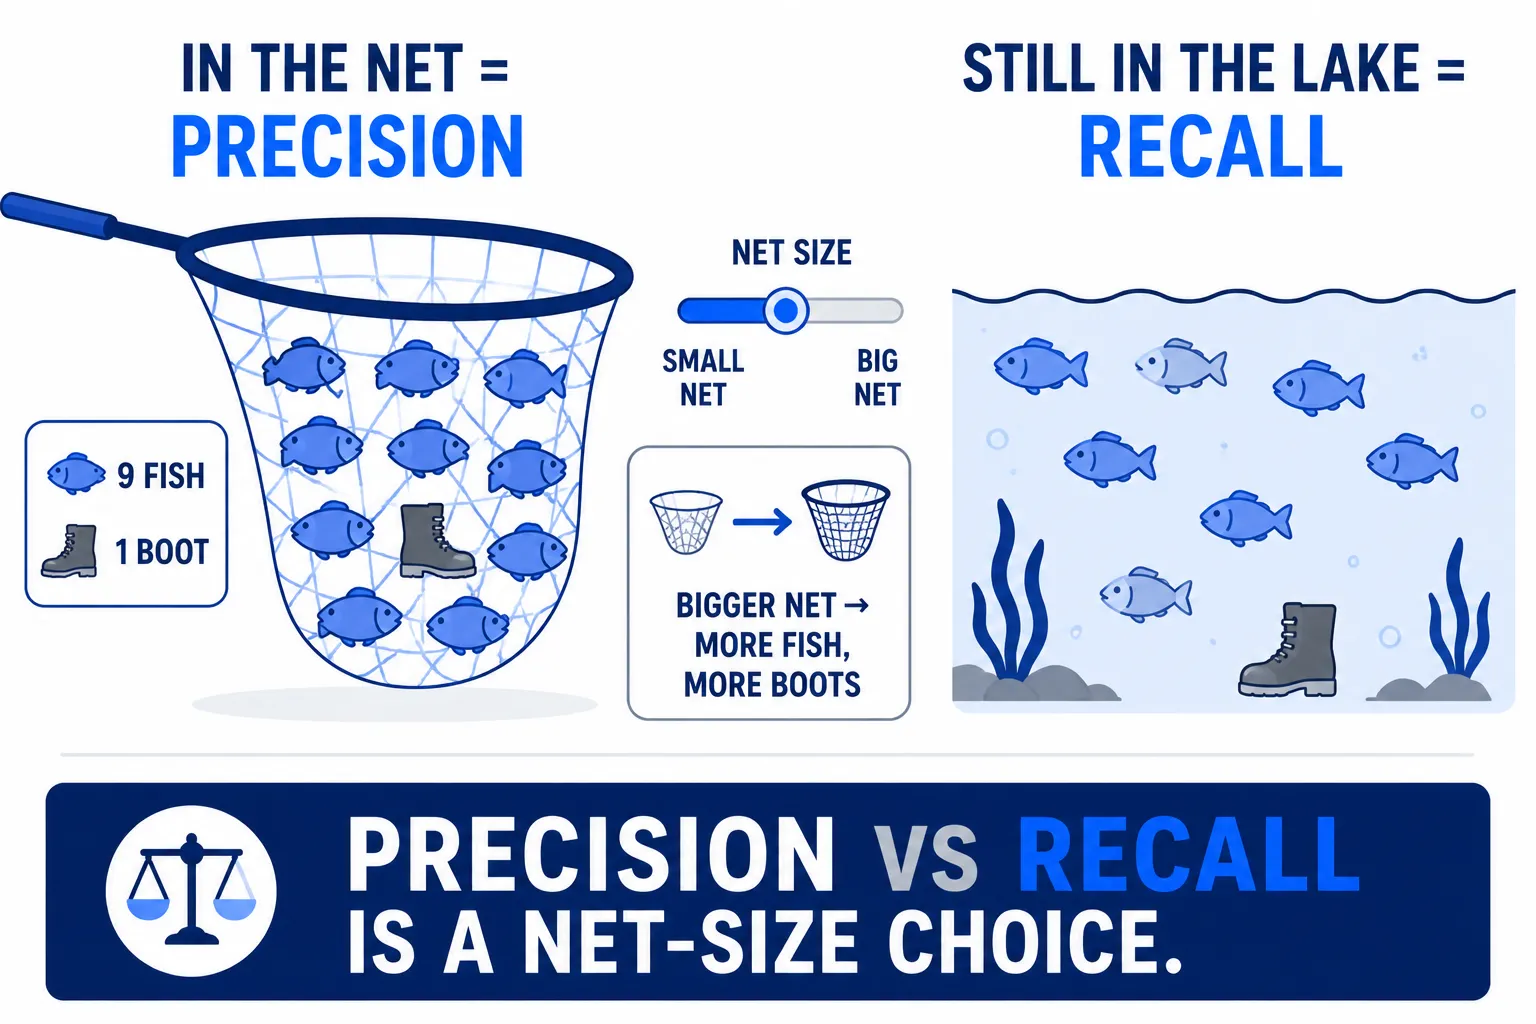
ลองนึกถึงการใช้ตาข่ายจับปลาในทะเลสาบ
Precision ถามว่า:
ของทั้งหมดที่ติดอยู่ในตาข่าย มีกี่เปอร์เซ็นต์ที่เป็นปลาจริง ๆ?
ถ้าในตาข่ายมีปลา 9 ตัวกับรองเท้า 1 ข้าง Precision ก็ดีมาก
ส่วน Recall ถามว่า:
จากปลาทั้งหมดในทะเลสาบ จับขึ้นมาได้กี่เปอร์เซ็นต์?
ถ้าอยากจับปลาให้ได้มากขึ้น วิธีหนึ่งคือใช้ตาข่ายที่ใหญ่ขึ้น
จำนวนปลาที่จับได้ก็มากขึ้น → Recall สูงขึ้น
แต่ของอย่างอื่นก็อาจติดมามากขึ้นด้วย → Precision อาจลดลง
นี่คือ Trade-off ที่เจอบ่อยมากระหว่าง Precision และ Recall
5.4 Threshold คือปุ่มที่ใช้ปรับ Trade-off นี้#
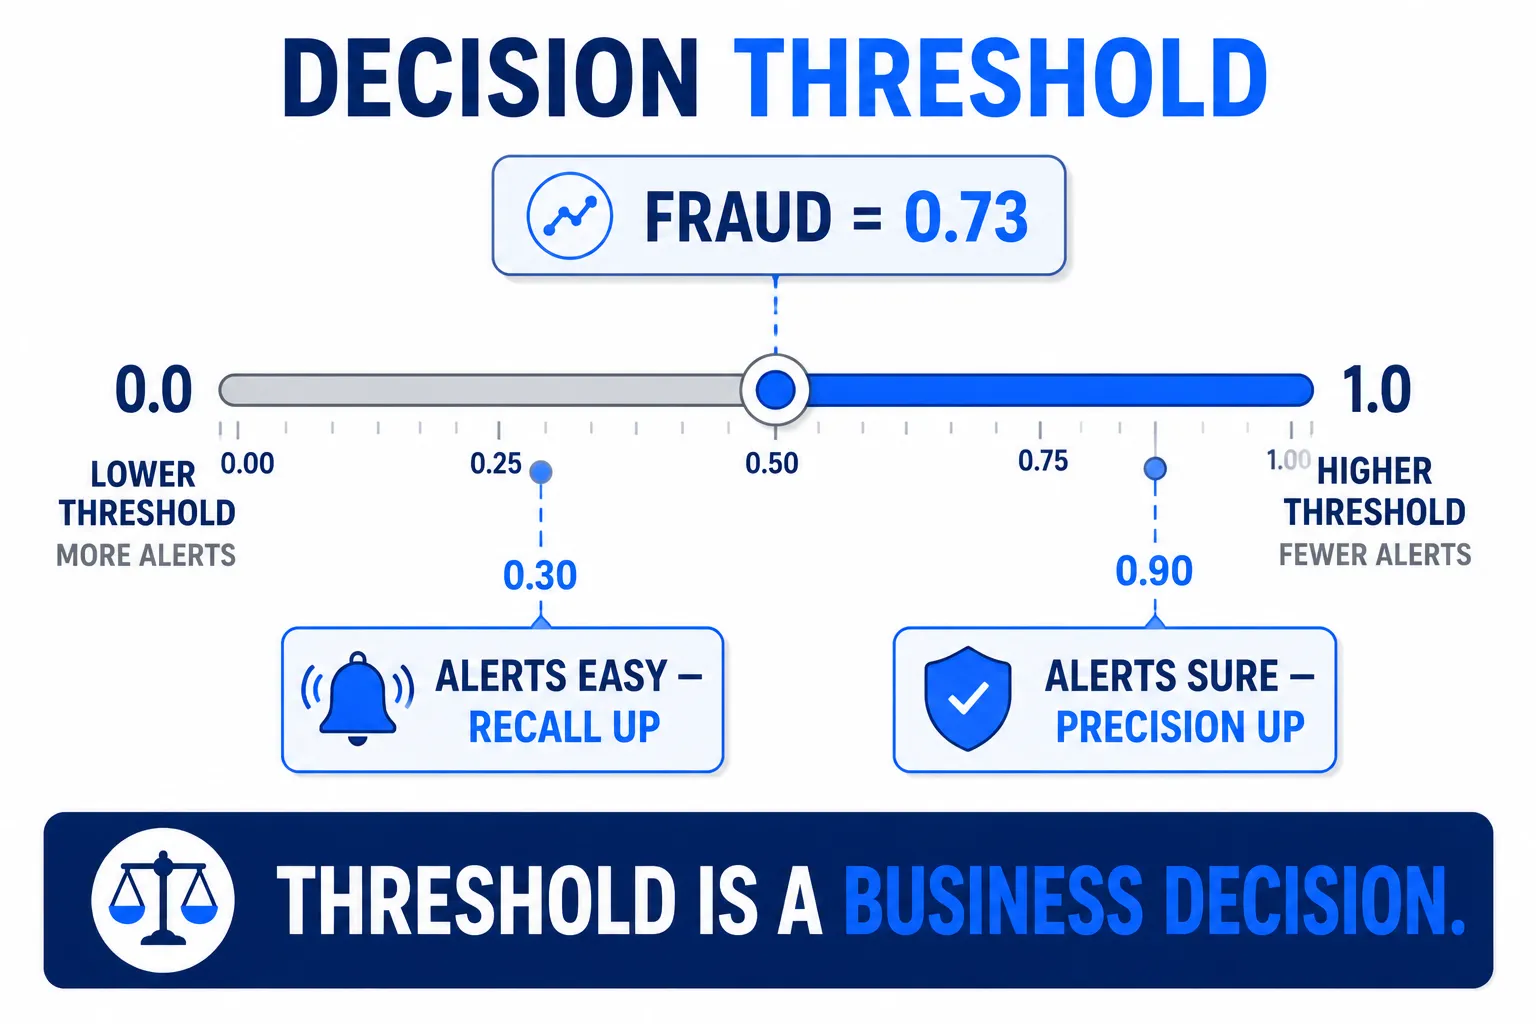
โมเดล Classification จำนวนมากไม่ได้คิดเป็นคำว่า Fraud หรือ Safe ตั้งแต่แรก
โมเดลอาจให้ Score หรือ Probability เช่น:
Fraud probability = 0.73
แล้วเป็นหน้าที่ของคนกำหนด Threshold
เช่น:
ถ้า probability >= 0.50 → FRAUD
ถ้า probability < 0.50  → SAFE
ถ้าลด Threshold ลงเป็น 0.30
โมเดลจะเตือนง่ายขึ้น
Recall มักสูงขึ้น แต่ False Positive ก็มักเพิ่มขึ้น
ถ้าเพิ่ม Threshold เป็น 0.90
โมเดลจะเตือนเฉพาะเคสที่มั่นใจมาก
Precision มักสูงขึ้น แต่ Fraud บางส่วนอาจหลุดไป ทำให้ Recall ลดลง
ดังนั้น Threshold จึงไม่ใช่เพียงตัวเลขทางคณิตศาสตร์ แต่เป็น Business Decision
| Metric | เหมาะเมื่อ |
|---|---|
| Accuracy | Class ค่อนข้างสมดุล และความผิดพลาดแต่ละแบบมีต้นทุนใกล้กัน |
| Precision | False Positive มีต้นทุนสูง เช่น บล็อกลูกค้าที่ดี |
| Recall | False Negative มีต้นทุนสูง เช่น พลาด Fraud หรือพลาดโรค |
| F1 Score | ต้องการสรุป Precision และ Recall เป็นตัวเลขเดียว |
| ROC-AUC | ต้องการดูความสามารถในการแยกหรือจัดอันดับ Class ข้ามหลาย Threshold |
| RMSE / MAE | ใช้กับ Regression หรือการทำนายค่าตัวเลข |
แต่สิ่งที่สำคัญกว่าการจำตารางนี้คือ:
ธุรกิจเป็นคนกำหนดว่า Error แบบไหนแพงกว่า
สมมติ Fraud หนึ่งรายการที่หลุดไปสร้างความเสียหายเฉลี่ย $10,000
แต่การ Block ลูกค้าปกติผิดหนึ่งครั้งอาจมีต้นทุนเป็นเพียงการโทรหา Support หนึ่งครั้ง
ในกรณีนี้ การยอมรับ False Positive เพิ่มขึ้น เพื่อแลกกับ Recall ที่สูงขึ้น ก็เป็นทางเลือกที่สมเหตุสมผล
เพราะเป้าหมายจริงไม่ได้อยู่ที่การทำให้ Metric สวยที่สุด
แต่คือ ลดต้นทุนหรือสร้างมูลค่าให้ระบบโดยรวม
5.5 โมเดล Precision 30% อาจทำเงินได้#
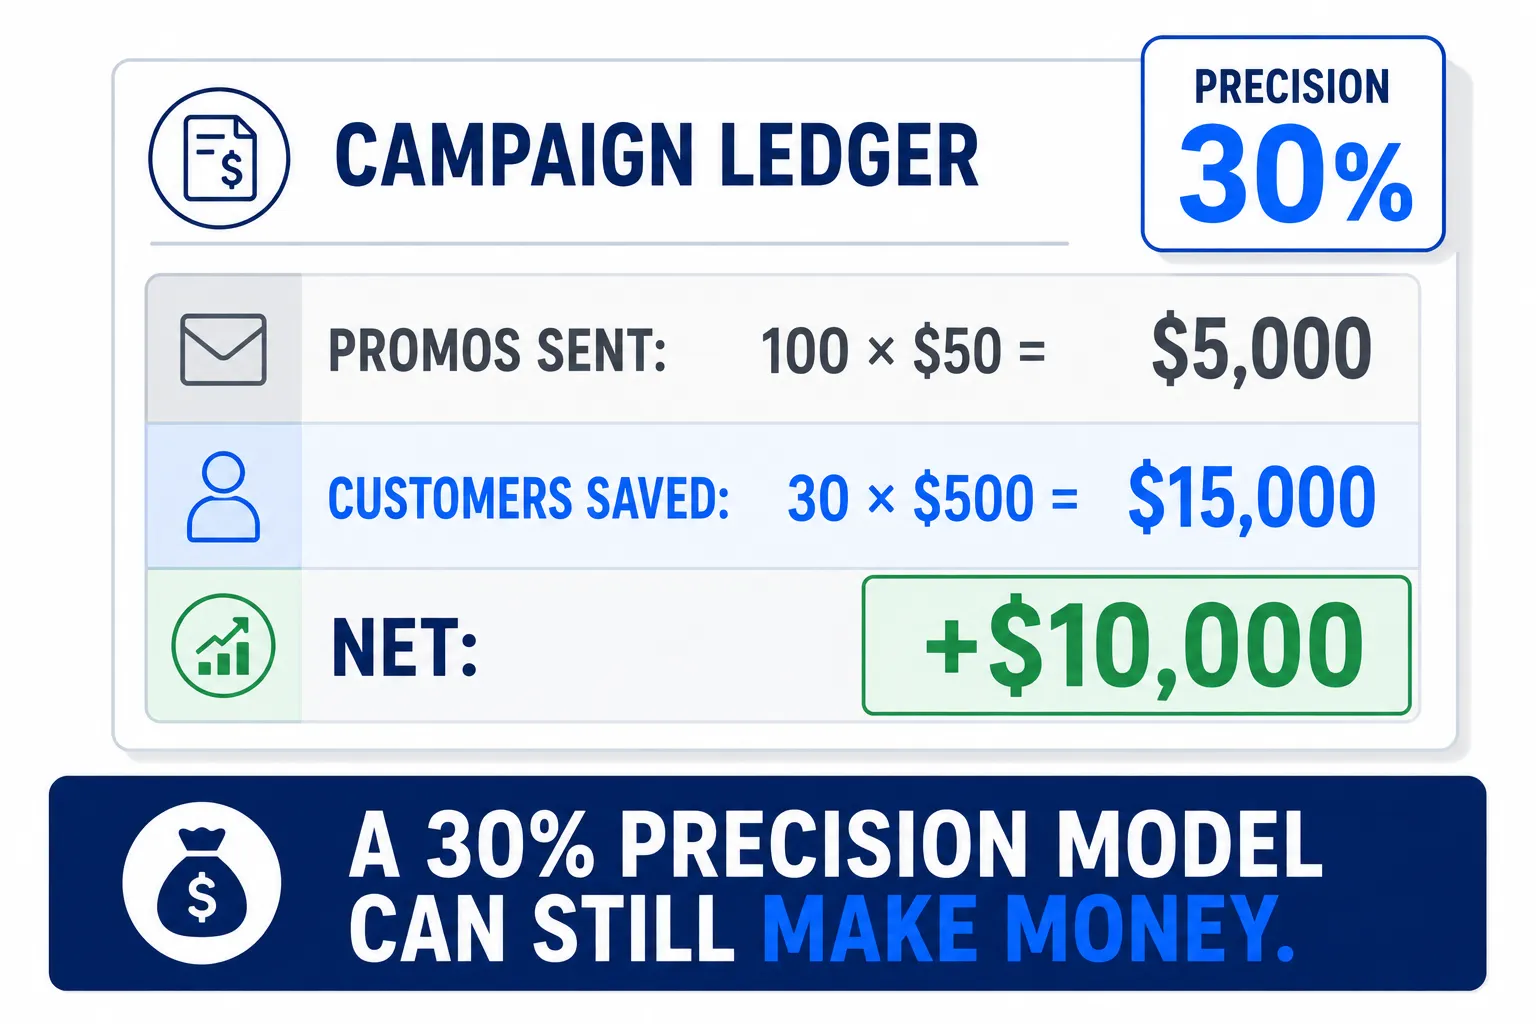
สมมติว่ามีโมเดลทำนาย Customer Churn
โมเดลเลือกว่ามีลูกค้า 100 คนที่น่าจะกำลังเลิกใช้บริการ และบริษัทตัดสินใจส่ง Promotion มูลค่า $50 ให้ทุกคน
ต้นทุนคือ:
100 × $50 = $5,000
ปรากฏว่าใน 100 คนนี้ มีเพียง 30 คนที่กำลังจะ Churn จริง
ดังนั้น Precision คือเพียง:
30 / 100 = 30%
ฟังดูไม่ค่อยดี
แต่สมมติว่าการรักษาลูกค้าแต่ละคนไว้ได้สร้างมูลค่า $500
มูลค่าที่รักษาไว้ได้คือ:
30 × $500 = $15,000
หักต้นทุน Promotion:
$15,000 - $5,000 = +$10,000
โมเดลที่มี Precision เพียง 30% จึงสร้างมูลค่าสุทธิได้ $10,000
นี่คือเหตุผลที่ไม่ควรเลือกโมเดลจาก Metric เพียงอย่างเดียว
Metric ไม่ใช่เป้าหมายสุดท้ายของธุรกิจ — เป็นเพียงเครื่องมือช่วยตัดสินใจ
โมเดลที่ Metric สวยแต่ไม่สร้างมูลค่าอาจไม่มีประโยชน์
ในทางกลับกัน โมเดลที่ Metric ดูธรรมดา แต่สร้างรายได้ ลดความเสียหาย หรือประหยัดต้นทุนได้จริง อาจเป็นโมเดลที่ควร Deploy มากกว่า
สรุป#
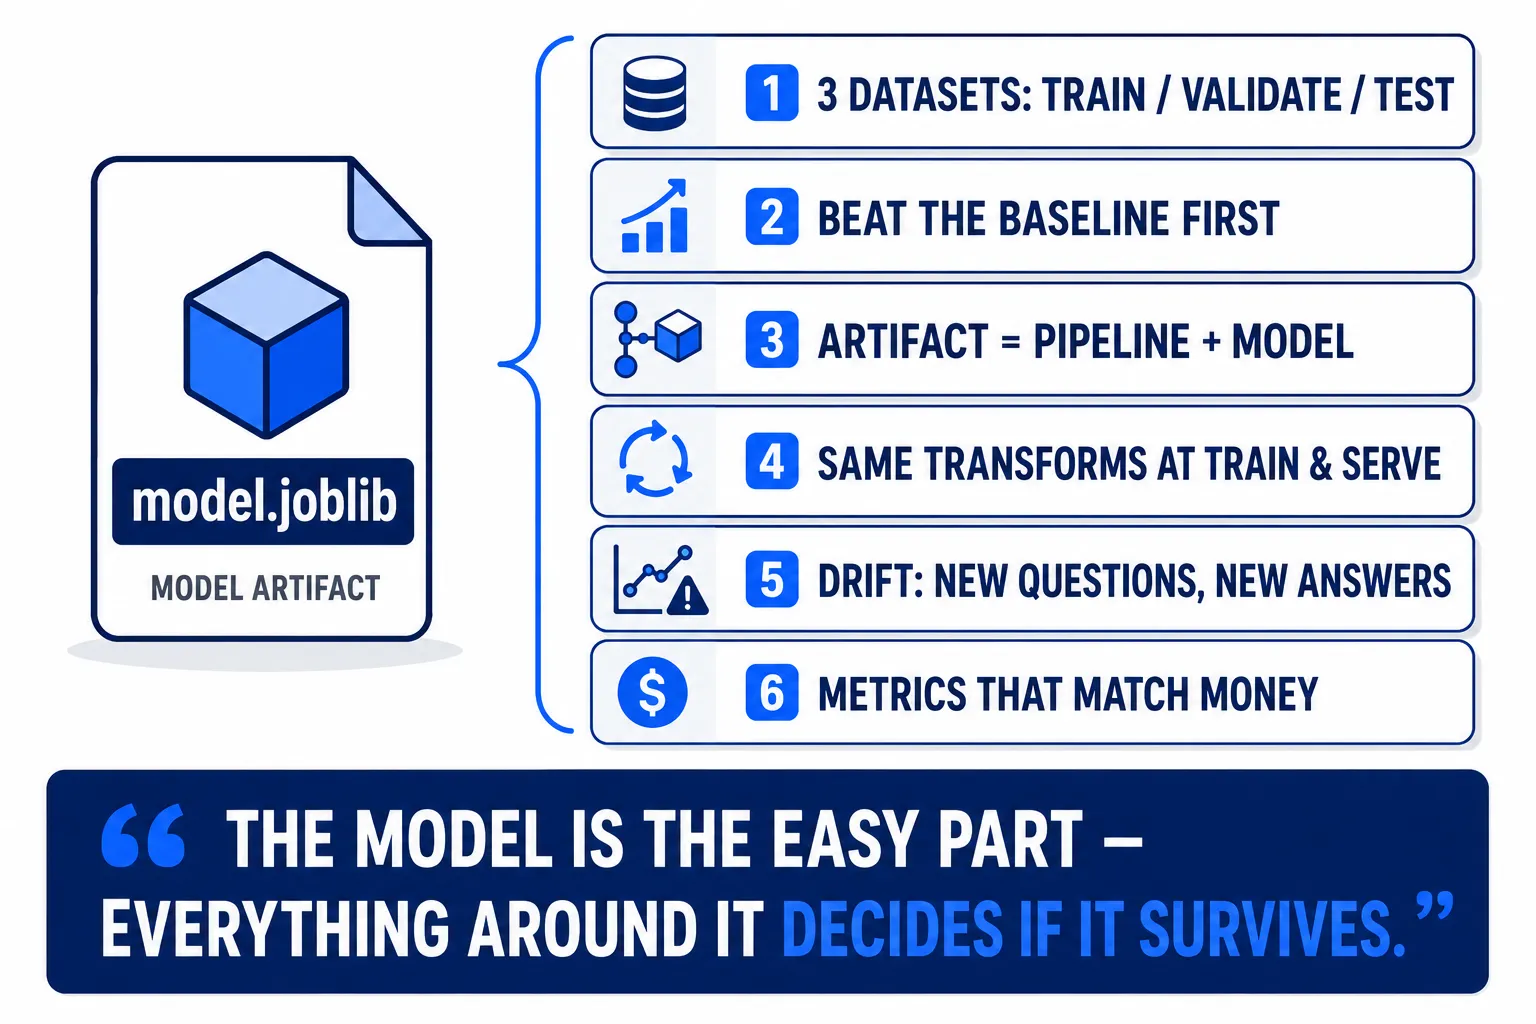
ถ้าจะเก็บประโยคเดียวจากบทความนี้ เก็บอันนี้:
โมเดลเป็นแค่ส่วนที่ง่ายที่สุดของระบบ ML — สิ่งที่ตัดสินว่าโมเดลจะอยู่รอดใน Production หรือไม่ คือทุกอย่างรอบตัวโมเดล
แผนที่สำหรับอ้างอิง:
- สามชุดข้อมูล: train ใช้ fit, validation ใช้ตัดสินใจ, test ใช้ครั้งเดียวตอนจบ
- Baseline ก่อนเสมอ: โมเดลที่ซับซ้อนต้องเอาชนะวิธีง่ายที่สุดให้ได้ ไม่งั้นอย่าขึ้น Production
- ศัพท์สำคัญสามคำ: Model Artifact, Feature Schema, Preprocessor — สามประตูของบั๊กเงียบ
- กฎทองกัน Skew: ก่อน Train แปลงข้อมูลยังไง ตอน Serve ต้องเหมือนกันทุกอย่าง — วิธีที่ดีที่สุดคือ Save Pipeline ทั้งชุดเป็น Artifact เดียว
- โมเดลเน่าแบบเงียบ ๆ: Data Drift คือคำถามใหม่, Concept Drift คือคำตอบใหม่ของคำถามเดิม — Server เขียวได้ แต่ Prediction พัง
- Metrics เชื่อมกับเงิน: Accuracy หลอกได้ตอน Imbalance, Precision/Recall คือการเลือกว่า Error แบบไหนแพงกว่า และโมเดล Precision 30% ก็ทำกำไรได้