
พื้นฐานการ Serve โมเดล Machine Learning
เข้าใจการนำ Machine Learning ขึ้น Production ตั้งแต่ Model Serving, Lifecycle, Model Decay, Monitoring และ Metrics สำหรับการใช้งานจริง
ถ้าคุณเคยเรียนวิชา Machine Learning มาก่อน คุณอาจคุ้นกับขั้นตอนประมาณนี้: เตรียมข้อมูล → train โมเดล → ดูค่า accuracy → พอผลออกมาดีก็ปิด notebook แล้วจบ
แต่ในโลกจริง การ train โมเดลเป็นแค่จุดเริ่มต้นเท่านั้น
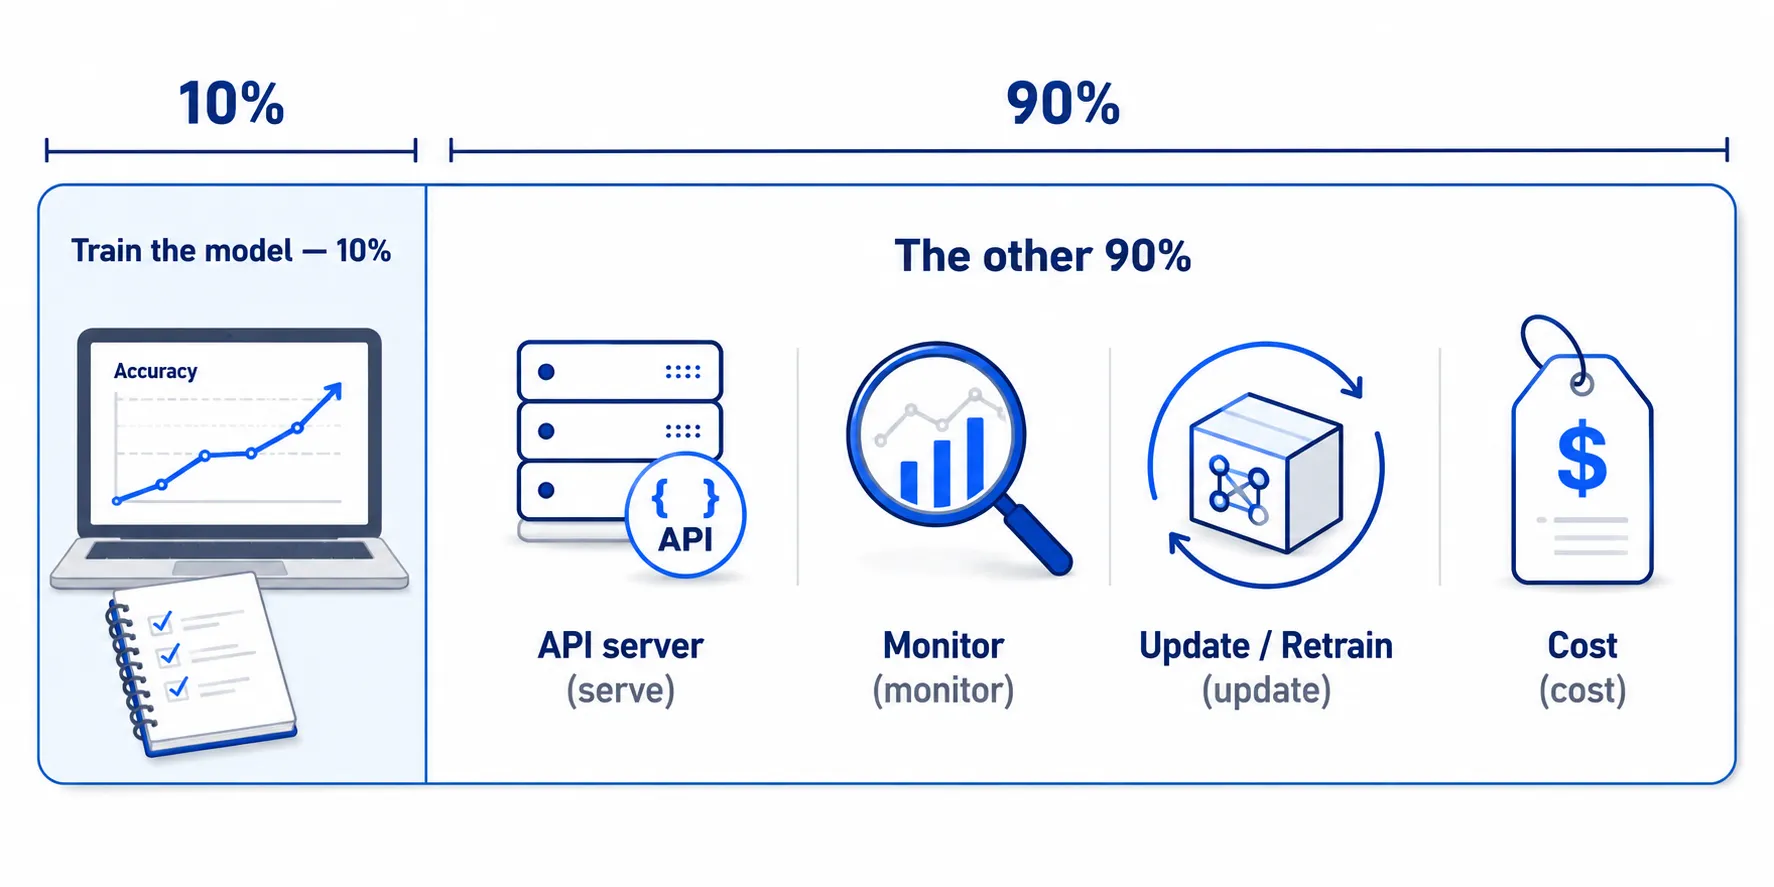
จริง ๆ แล้วการสร้างโมเดลอาจเป็นเพียงประมาณ 10% ของงานทั้งหมด ส่วนอีก 90% คือการทำให้โมเดลนั้นสามารถนำไปใช้งานจริงได้ และยังทำงานได้ดีเมื่อเวลาผ่านไป
งานส่วนที่เหลือมีตั้งแต่:
- เปลี่ยนโมเดลให้เป็น service ที่ระบบหรือแอปอื่นเรียกใช้งานได้
- คอยตรวจสอบว่าโมเดลยังทำนายได้ถูกต้องอยู่หรือไม่
- อัปเดตหรือ train โมเดลใหม่เมื่อข้อมูลและพฤติกรรมของผู้ใช้เปลี่ยนไป
- และแน่นอน… ทำความเข้าใจค่าใช้จ่ายที่ตามมา
90% ที่เหลือนี่แหละ คือสิ่งที่เราจะพูดถึงในซีรีส์นี้
แต่ก่อนจะลงรายละเอียด เรามาทำความเข้าใจคำศัพท์สำคัญ 3 คำที่เราจะเจอกันบ่อย ๆ แบบง่าย ๆ ก่อน
-
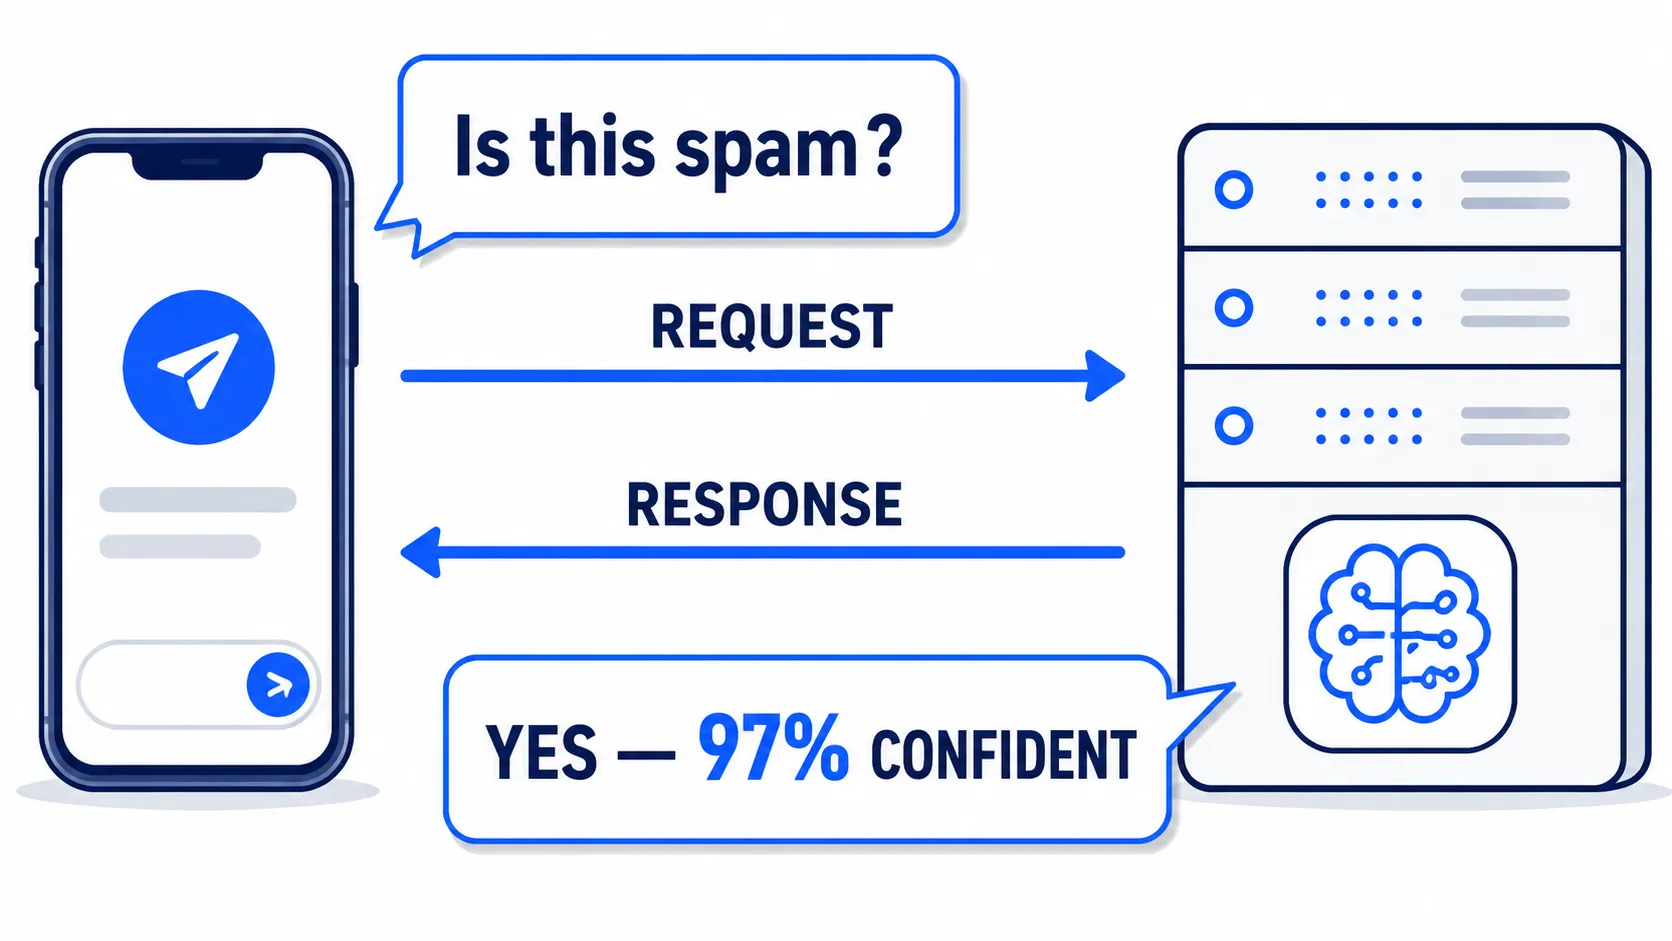
Model (โมเดล) — โปรแกรมที่เรียนรู้รูปแบบจากข้อมูลในอดีต แล้วนำสิ่งที่เรียนรู้มาใช้ทำนายข้อมูลใหม่ หรือที่เราเรียกว่า prediction เช่น เราส่งข้อความจากอีเมลเข้าไป แล้วโมเดลตอบกลับมาว่าอีเมลนั้นเป็น spam หรือ ไม่ใช่ spam
-
Serving — การทำให้โมเดลที่ train เสร็จแล้ว พร้อมให้ระบบอื่นเรียกใช้งานได้จริง เช่น แอปหรือเว็บไซต์ส่งข้อมูลเข้ามา แล้วโมเดลส่งผลการทำนายกลับไป โดยระบบสามารถเรียกใช้งานได้ตลอดเวลาที่ต้องการ
-
API — เปรียบเหมือน ช่องทางที่ซอฟต์แวร์ใช้คุยกัน แอปส่ง request เข้ามาว่า “อีเมลนี้เป็น spam ไหม?” เซิร์ฟเวอร์ที่มีโมเดลอยู่ก็ประมวลผล แล้วตอบกลับไปว่า “ใช่ มีความมั่นใจ 97%”
จากตรงนี้ เราจะค่อย ๆ เปลี่ยนมุมมองจาก “สร้างโมเดลให้แม่น” ไปสู่ “ทำอย่างไรให้โมเดลกลายเป็นระบบที่คนอื่นใช้งานได้จริง” ซึ่งเป็นหัวใจสำคัญของการทำ Machine Learning ในโลกจริง
ตอนที่ 1: ใคร Serve อะไร? บันไดความรับผิดชอบ#
ลองนึกภาพว่าวันนี้คุณอยากกินข้าวเย็น คุณมีทางเลือกอยู่ประมาณ 4 แบบ:
- ซื้อที่ ปลูกผัก เลี้ยงสัตว์ แล้วทำอาหารเองทั้งหมด — ทุกอย่างอยู่ในความรับผิดชอบของคุณ
- ซื้อวัตถุดิบจากซูเปอร์มาร์เก็ต แล้วกลับมาทำอาหารเอง — มีคนเตรียมวัตถุดิบให้ แต่เรื่องทำอาหารยังเป็นหน้าที่ของคุณ
- สั่งอาหารมาส่งที่บ้าน — คนอื่นทำอาหารให้เรียบร้อย คุณแค่รอรับแล้วกิน
- ไปกินที่ร้านอาหาร — แทบไม่ต้องจัดการอะไรเอง กินเสร็จก็กลับ ไม่ต้องล้างจานด้วยซ้ำ
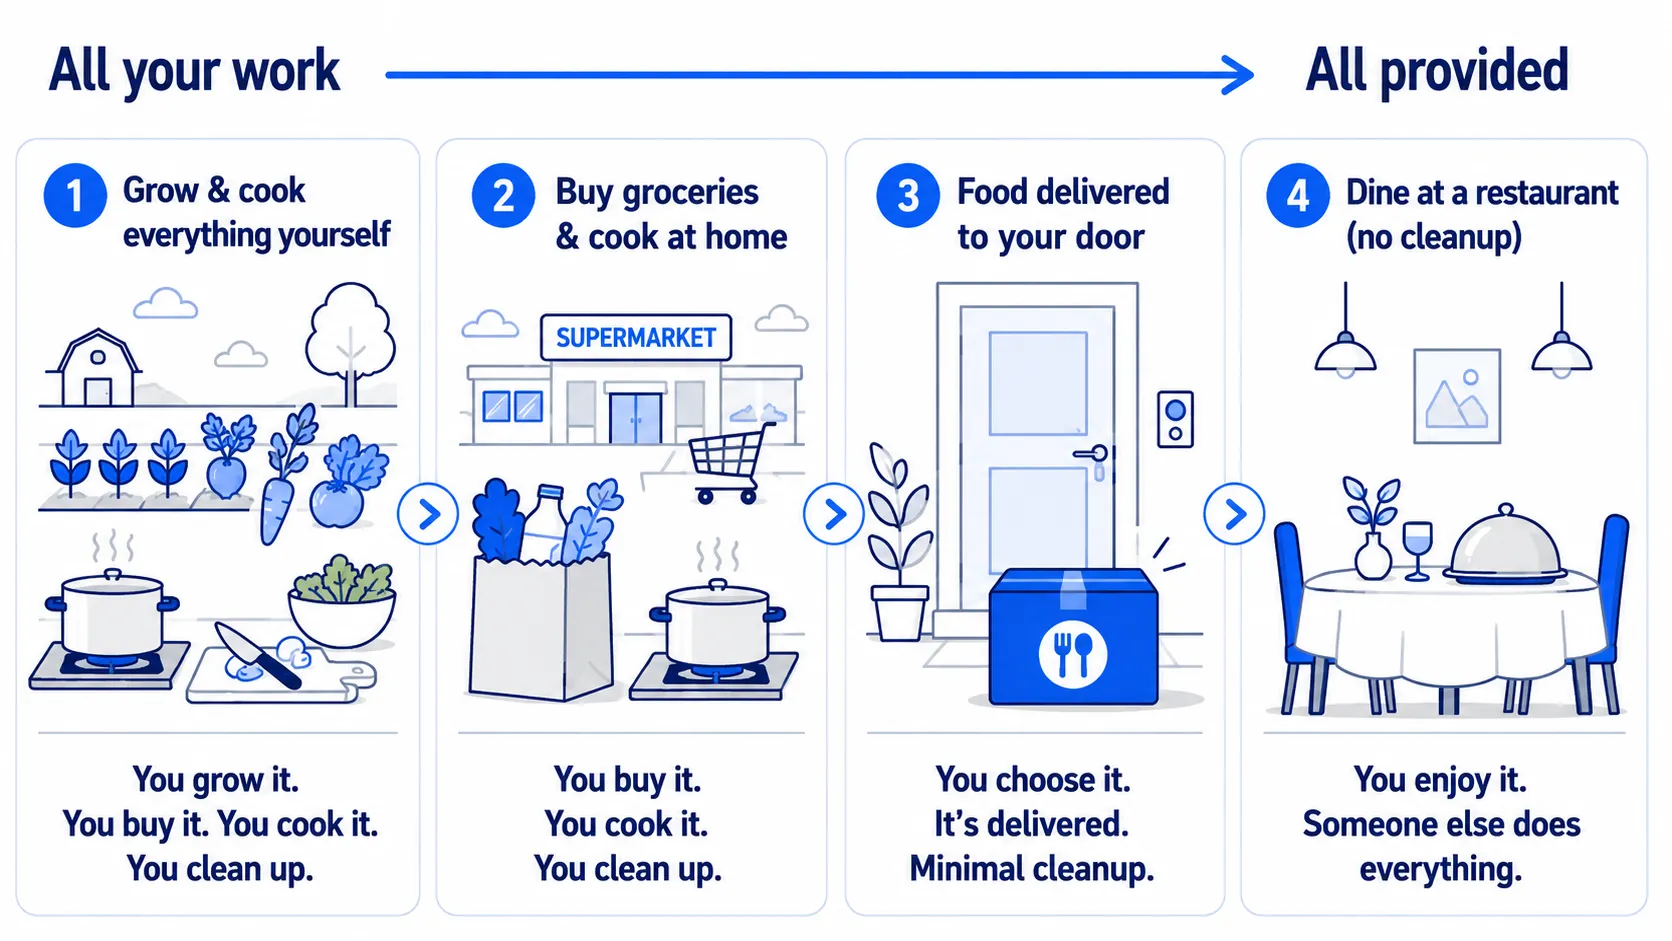
Cloud Computing ก็มีแนวคิดคล้าย ๆ กัน
เราไม่จำเป็นต้องสร้างและดูแลทุกอย่างด้วยตัวเอง ตั้งแต่เครื่อง Server, Network, Operating System ไปจนถึง Application แต่สามารถเลือกได้ว่า ส่วนไหนเราจะดูแลเอง และส่วนไหนจะให้ Cloud Provider จัดการให้
ดังนั้นคำถามสำคัญของ Cloud Computing จึงไม่ใช่แค่ว่า “จะใช้ Cloud หรือไม่?”
แต่คือ:
“เราต้องการดูแลเองแค่ไหน และอยากให้ผู้ให้บริการจัดการอะไรให้เราบ้าง?”
คำตอบของคำถามนี้จะพาเราไปสู่แนวคิดสำคัญอย่าง IaaS, PaaS, SaaS และต่อยอดไปถึง AI as a Service (AIaaS)
นี่คือ บันไดความรับผิดชอบของ Cloud — ยิ่งเราขยับขึ้นไปแต่ละขั้น งานที่เคยต้องจัดการเองก็จะถูกส่งต่อให้ผู้ให้บริการมากขึ้น
พูดง่าย ๆ คือ ยิ่งขึ้นสูง เราก็ยิ่งเหนื่อยน้อยลง แต่ก็แลกกับการควบคุมที่น้อยลงด้วย
| โมเดล | คุณดูแล | ผู้ให้บริการดูแล | ตัวอย่าง |
|---|---|---|---|
| On-Premise | ทุกอย่าง: Hardware, OS, Runtime, Application และข้อมูล | ไม่มี คุณดูแลเองทั้งหมด | Server ของคุณเองใน Rack |
| IaaS (Infrastructure as a Service) | OS, Runtime, Application และข้อมูล | Hardware, Network และ Virtualization | Linux VM ที่เช่าจาก Cloud |
| PaaS (Platform as a Service) | Application และข้อมูล | OS, Runtime, Infrastructure และการ Patch ระบบ | Heroku, Azure App Service |
| SaaS (Software as a Service) | ข้อมูลและการตั้งค่าของคุณ | ตั้งแต่ Infrastructure ไปจนถึงตัว Application | Gmail, Salesforce |
| AIaaS / MLaaS (AI / Machine Learning as a Service) | เตรียม Input และส่ง Request | Model, Hosting, Infrastructure และการ Scaling | Google Cloud Vision API |
จุดที่น่าสนใจคือ AIaaS / MLaaS ขยับไปอีกขั้น เพราะแม้แต่ ตัว Machine Learning Model เราก็ไม่จำเป็นต้องสร้างหรือดูแลเอง
เราเพียงส่งข้อมูลเข้าไป เช่น รูปภาพ ข้อความ หรือเสียง แล้วรอรับผลลัพธ์กลับมา:
Input → API Request → AI Model → Output
จากเดิมที่เราต้องคิดว่า “จะเอา Server ที่ไหนมา Run โมเดล?” คำถามอาจเหลือเพียง “จะส่งอะไรเข้า API และอยากได้อะไรกลับมา?”
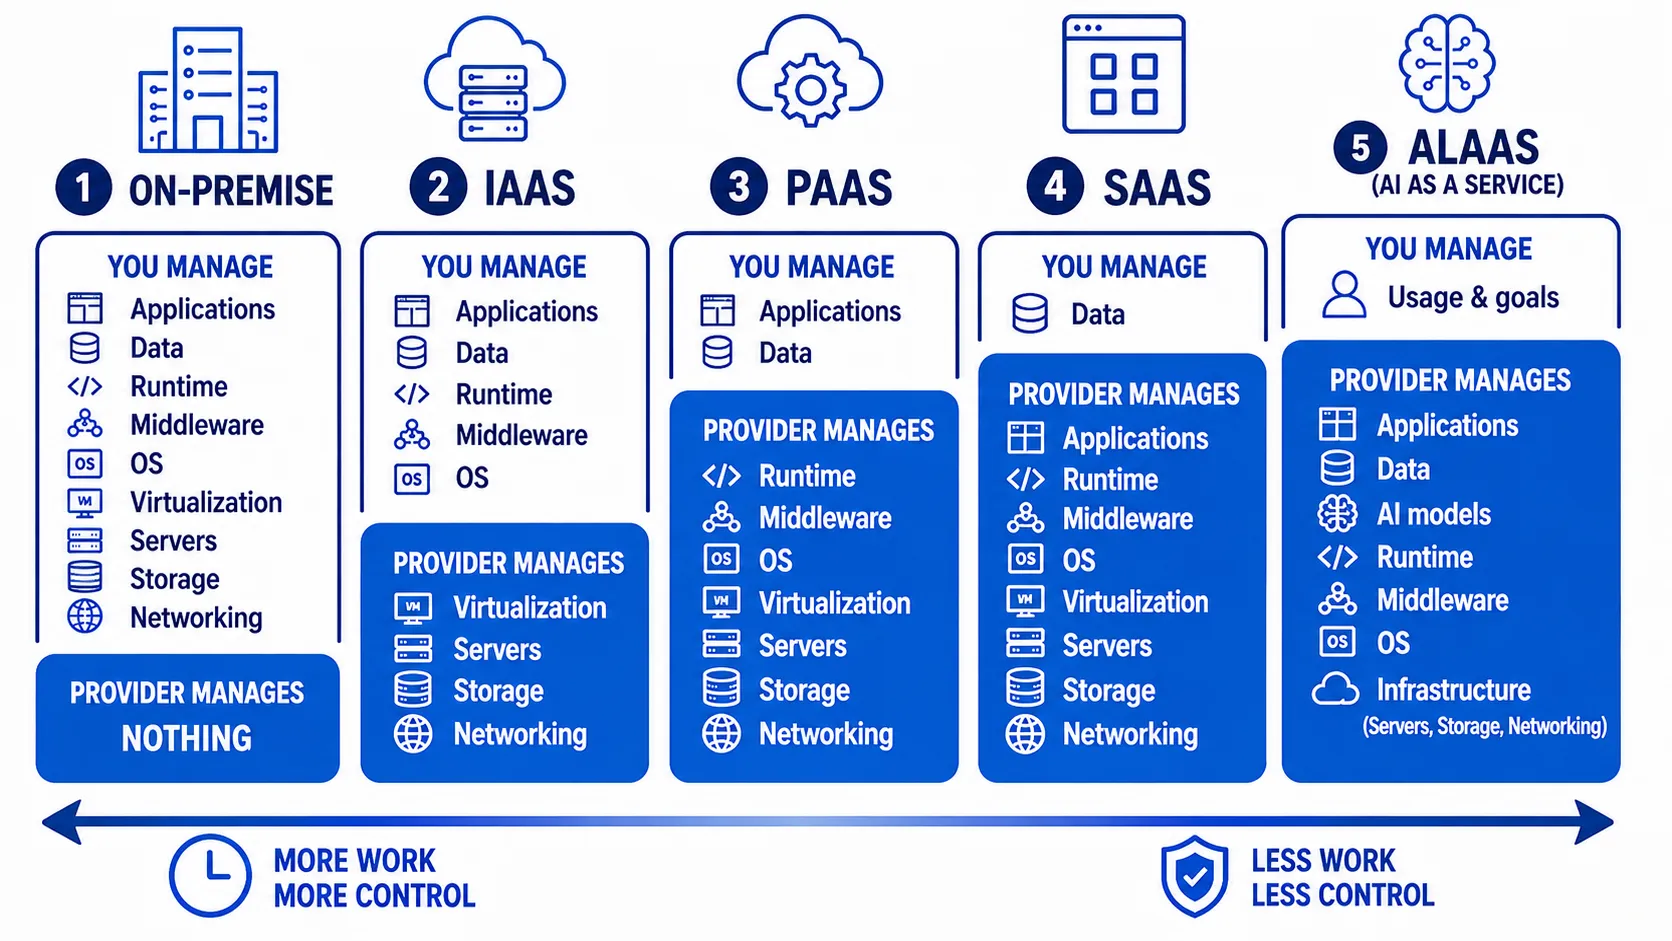
ลองไล่ดูทีละแบบด้วยภาษาง่าย ๆ
-
On-Premise — Server อยู่กับเราจริง ๆ อาจตั้งอยู่ในห้อง Server ของบริษัท ถ้ามันพังตอนสองทุ่ม คนที่ต้องจัดการก็คือเรา ตั้งแต่ Hardware, Network, OS ไปจนถึง Application
-
IaaS (Infrastructure as a Service) — แทนที่จะซื้อ Server เอง เราเช่า Virtual Machine (VM) จาก Cloud Provider ตัว Hardware และ Network เขาดูแลให้ แต่ตั้งแต่ OS ขึ้นมาเป็นหน้าที่ของเรา เช่น ถ้า Disk ของเครื่องจริงมีปัญหา ผู้ให้บริการจัดการ แต่ถ้า Linux ของเราต้อง Security Patch อันนี้เราต้องจัดการเอง
-
PaaS (Platform as a Service) — เราไม่ต้องดูแลแม้แต่ OS หรือ Runtime แล้ว หน้าที่หลักของเราคือเขียน Application แล้ว Deploy ขึ้นไป ส่วนเรื่อง Server, OS Update, Runtime หรือการ Patch ระบบ ผู้ให้บริการจัดการให้ ตัวอย่างเช่น Heroku หรือ Azure App Service
-
SaaS (Software as a Service) — คราวนี้เราแทบไม่ต้องสร้างอะไรเลย เพราะตัว Software ถูกสร้างมาให้พร้อมใช้แล้ว อย่าง Gmail เราแค่ Login แล้วใช้งาน ไม่ต้องรู้ด้วยซ้ำว่าเบื้องหลังใช้ Server กี่เครื่องหรือ Deploy อย่างไร
-
AIaaS (AI as a Service) — แนวคิดเดียวกับ SaaS แต่สิ่งที่เราเรียกใช้คือ ความสามารถของ AI เช่น ส่งรูปภาพเข้าไป แล้ว API ตอบกลับมาว่า “ภาพนี้เป็นแมว ความมั่นใจ 98%” เราไม่จำเป็นต้องรู้ว่าโมเดลถูก Train อย่างไร ใช้ Dataset อะไร หรือทำงานอยู่บน GPU กี่ตัว
แล้วทำไมบันไดนี้ถึงสำคัญ?
เพราะทุกครั้งที่เราขยับขึ้นไปหนึ่งขั้น เรากำลังแลกสองอย่างกันอยู่เสมอ:
- งานของเราน้อยลง — ดูแล Server น้อยลง, Patch น้อยลง, Deploy ง่ายขึ้น และมี Infrastructure ที่ต้องคอยดูแลน้อยลง
- การควบคุมก็น้อยลง — ปรับแต่งได้น้อยลง ต้องทำตามข้อจำกัดของผู้ให้บริการ และต้องยอมรับรูปแบบราคาและกติกาของ Platform นั้น
Less Work ↔ Less Control
นี่คือหนึ่งใน Trade-off ที่สำคัญที่สุดของ Cloud Computing
ไม่มีคำตอบว่าแบบไหนดีที่สุดเสมอไป เพราะมันขึ้นอยู่กับว่า เราต้องการควบคุมระบบมากแค่ไหน และยอมรับภาระในการดูแลระบบได้มากแค่ไหน
และอีกเรื่องที่สำคัญคือ บริการเหล่านี้ ไม่ได้แยกออกจากกันแบบเด็ดขาด แต่มักซ้อนกันเป็นชั้น ๆ
ตัวอย่างเช่น ระบบเรียนออนไลน์ของมหาวิทยาลัยอาจเป็น SaaS ที่นักศึกษาเปิด Browser แล้วใช้งานได้ทันที แต่ภายในระบบนั้นอาจเรียก AIaaS อีกตัวหนึ่งเพื่อช่วยตรวจ Spam, วิเคราะห์ข้อความ หรือสร้างคำแนะนำให้ผู้เรียน
พูดอีกแบบคือ:
SaaS สามารถเรียก AIaaS ได้ และ AIaaS เองก็ทำงานอยู่บน Cloud Infrastructure อีกที
เมื่อเริ่มมองระบบเป็นชั้นแบบนี้ เราจะเริ่มเห็นว่า Application ที่เราใช้ทุกวัน จริง ๆ แล้วอาจประกอบขึ้นจาก Cloud Service หลายแบบที่ทำงานร่วมกันอยู่เบื้องหลัง
ตอนที่ 2: สามเส้นทางสู่คำทำนาย (Prediction)#
ทีนี้สมมติว่า Application ของเราต้องการใช้ Machine Learning เพื่อทำนายอะไรบางอย่าง
อาจเป็นแอปท่องเที่ยวที่ต้อง อ่านข้อความจากรูปพาสปอร์ต ร้านค้าที่ต้องการ ทำนายว่าสินค้าตัวไหนกำลังจะหมด หรือระบบของโรงพยาบาลที่ต้องการ ประเมินความเสี่ยงของผู้ป่วย
คำถามคือ เราจะเอาความสามารถของ AI หรือ Machine Learning เข้าไปอยู่ใน Application ของเราได้อย่างไร?
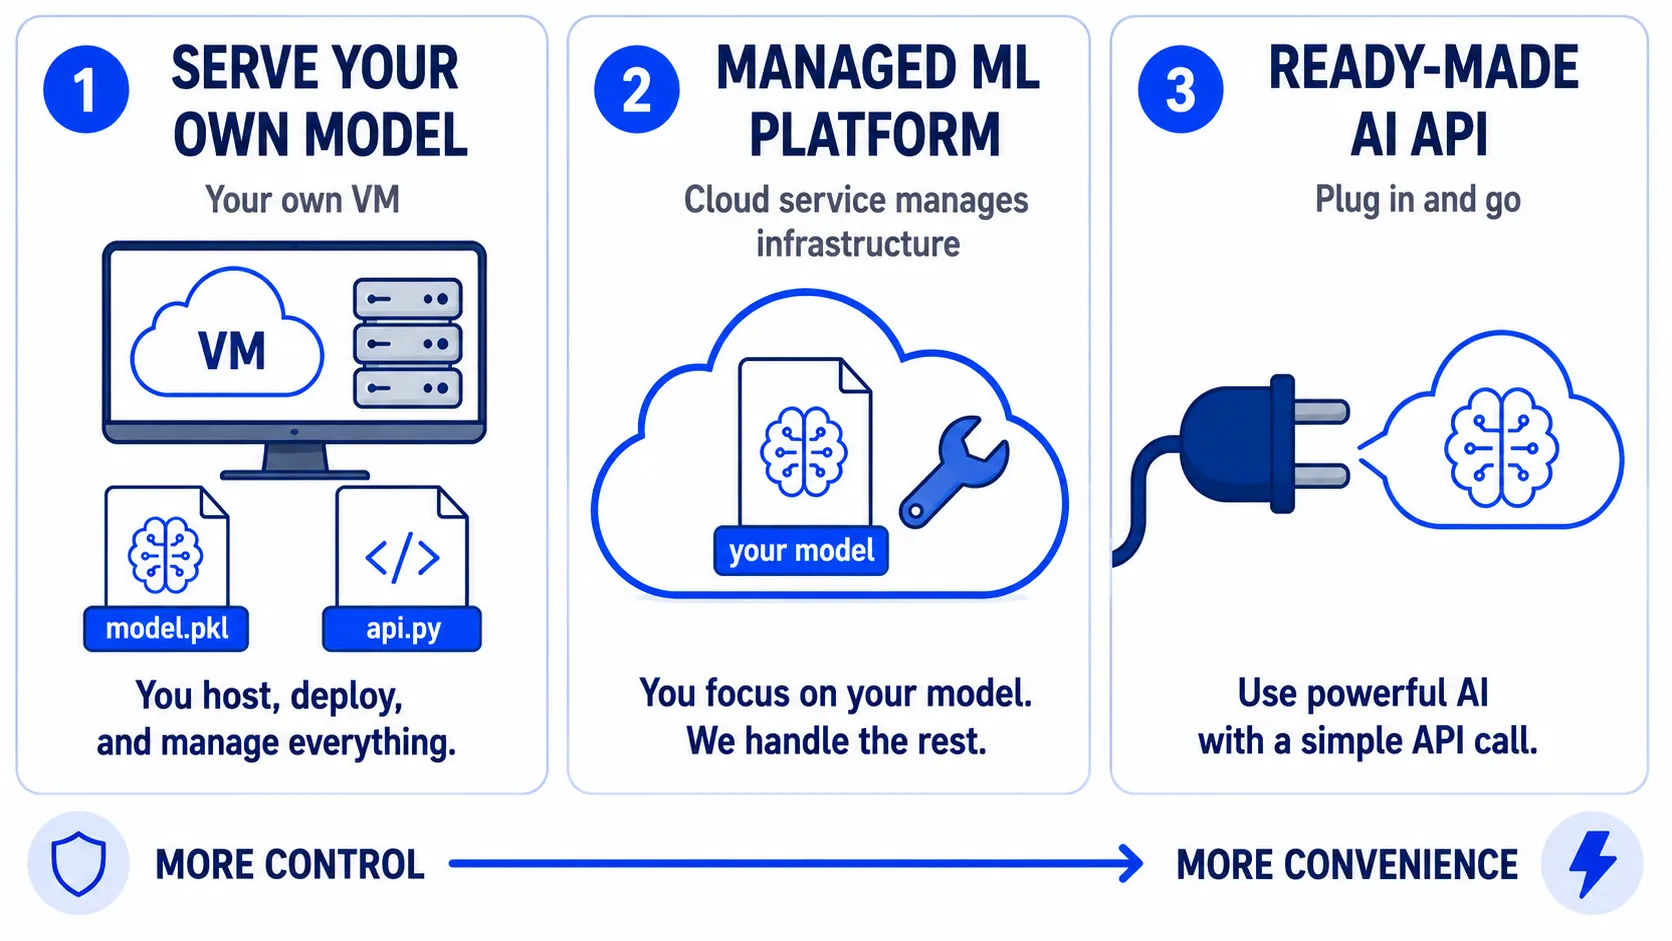
โดยหลัก ๆ แล้วมีอยู่ 3 เส้นทาง
เส้นทางที่ 1: Serve โมเดลของตัวเอง#
เส้นทางนี้คือ เราทำเองเกือบทั้งหมด
เราเตรียมข้อมูล → Train โมเดล → Save โมเดล → เอาไปวางบน Server → สร้าง API → แล้วเปิดให้ Application เรียกใช้งาน
ในซีรีส์นี้ เราจะลองเอาโมเดลไปรันบน Virtual Machine (VM) ของเราเอง
ข้อดีคือเราควบคุมได้แทบทุกอย่าง ตั้งแต่ตัวโมเดล เวอร์ชันของ Library ไปจนถึงวิธี Deploy และ Scale ระบบ
แต่สิ่งที่ตามมาก็คือ เมื่อเราควบคุมทุกอย่าง เราก็ต้องรับผิดชอบทุกอย่างด้วย
Server ล่ม เราจัดการ Model โหลดไม่ได้ เราจัดการ Library มีช่องโหว่ เรา Patch Traffic เพิ่มจน Server รับไม่ไหว เราก็ต้อง Scale เอง
สรุปสั้น ๆ:
ควบคุมสูงสุด → งานก็มากที่สุด
เส้นทางที่ 2: ใช้ Managed ML Platform#
เส้นทางที่สองอยู่ตรงกลาง
เรายังสามารถ Train โมเดลของเราเอง หรือเอาโมเดลที่มีอยู่แล้วมาใช้ได้ แต่แทนที่จะต้องสร้างและดูแล Infrastructure สำหรับ Serving เองทั้งหมด เราให้ Cloud Platform ช่วยจัดการให้
ตัวอย่างเช่น Amazon SageMaker, Azure Machine Learning หรือ Google Vertex AI
เราสนใจตัว Model และ Application เป็นหลัก ส่วนงานอย่างการ Provision Server, Deployment หรือ Scaling หลายอย่าง Platform จะช่วยจัดการให้
พูดง่าย ๆ คือ:
โมเดลยังเป็นของเรา แต่ไม่จำเป็นต้องดูแล Server ทุกอย่างเอง
จึงเป็นทางสายกลางระหว่าง การควบคุม กับ ความสะดวก
เส้นทางที่ 3: เรียกใช้ AI API สำเร็จรูป#
เส้นทางสุดท้ายง่ายที่สุด
เราไม่ต้อง Train โมเดลเอง และไม่ต้อง Deploy โมเดลเอง เพราะผู้ให้บริการสร้างและ Train โมเดลไว้ให้เรียบร้อยแล้ว
สิ่งที่เราทำมีเพียง ส่ง HTTP Request ไปที่ API แล้วรอรับผลลัพธ์กลับมา
เช่น ส่งรูปพาสปอร์ตเข้า OCR API แล้วได้ข้อความกลับมา หรือส่งไฟล์เสียงเข้า Speech-to-Text API แล้วได้ข้อความที่ถอดจากเสียงกลับมา
Request → AI API → Response
ข้อดีคือเริ่มใช้งานได้เร็วมาก แต่สิ่งที่แลกมาก็คือ การควบคุม
เราอาจไม่รู้ด้วยซ้ำว่าเบื้องหลังใช้โมเดลอะไร Train ด้วยข้อมูลแบบไหน หรือ Infrastructure ทำงานอย่างไร และแน่นอนว่าเราไม่สามารถเข้าไปแก้ตัวโมเดลได้โดยตรง
สรุปคือ:
สะดวกที่สุด → แต่ควบคุมได้น้อยที่สุด
แล้วเราควรเลือกเส้นทางไหน?#
ใช้หลักง่าย ๆ แบบนี้ได้เลย
-
ถ้าคุณมีข้อมูลเฉพาะที่คนอื่นไม่มี → เริ่มคิดจากเส้นทางที่ 1 เช่น ข้อมูลภายในองค์กร ประวัติการซื้อของลูกค้า หรือข้อมูลจากกระบวนการผลิตของบริษัท ข้อมูลเหล่านี้อาจเป็นความได้เปรียบของเรา และโมเดลสำเร็จรูปทั่วไปอาจไม่ตอบโจทย์
-
ถ้าเป็นโจทย์มาตรฐานที่มีคนแก้ไว้ดีอยู่แล้ว → เริ่มจากเส้นทางที่ 3 เช่น OCR, Translation หรือ Speech-to-Text งานเหล่านี้มีบริการสำเร็จรูปที่ผ่านการพัฒนาจากข้อมูลจำนวนมหาศาลอยู่แล้ว การสร้างใหม่ทั้งหมดอาจไม่คุ้มทั้งเวลาและเงิน
-
ถ้าต้องการโมเดลของตัวเอง แต่ไม่อยากดูแล Infrastructure → เส้นทางที่ 2 เราได้ความยืดหยุ่นจาก Custom Model แต่ให้ Managed Platform ช่วยรับภาระเรื่อง Infrastructure และการ Serving
ลองเอาหลักนี้มาเทียบกับตัวอย่างจริง:
| เคส | ทางเลือก | เพราะอะไร |
|---|---|---|
| โรงพยาบาลต้องการทำนายว่าผู้ป่วยรายใดมีโอกาสกลับมารักษาซ้ำ โดยใช้ข้อมูลของโรงพยาบาลเอง | เส้นทางที่ 1 — Serve โมเดลเอง | ข้อมูลมีความเฉพาะและมีข้อกำหนดด้านความเป็นส่วนตัวสูง จึงต้องการการควบคุมมาก |
| แอปท่องเที่ยวต้องอ่านข้อความจากรูปพาสปอร์ต | เส้นทางที่ 3 — AI API สำเร็จรูป | OCR เป็นโจทย์มาตรฐาน มีบริการที่พร้อมใช้งานอยู่แล้ว ไม่จำเป็นต้องสร้างโมเดลใหม่ตั้งแต่ศูนย์ |
| ร้านค้าต้องการทำ Demand Forecast จากข้อมูลเฉพาะของตัวเอง แต่ไม่มีทีมดูแล Infrastructure | เส้นทางที่ 2 — Managed ML Platform | ต้องการ Custom Model แต่ไม่อยากรับภาระในการดูแลระบบ Serving เองทั้งหมด |
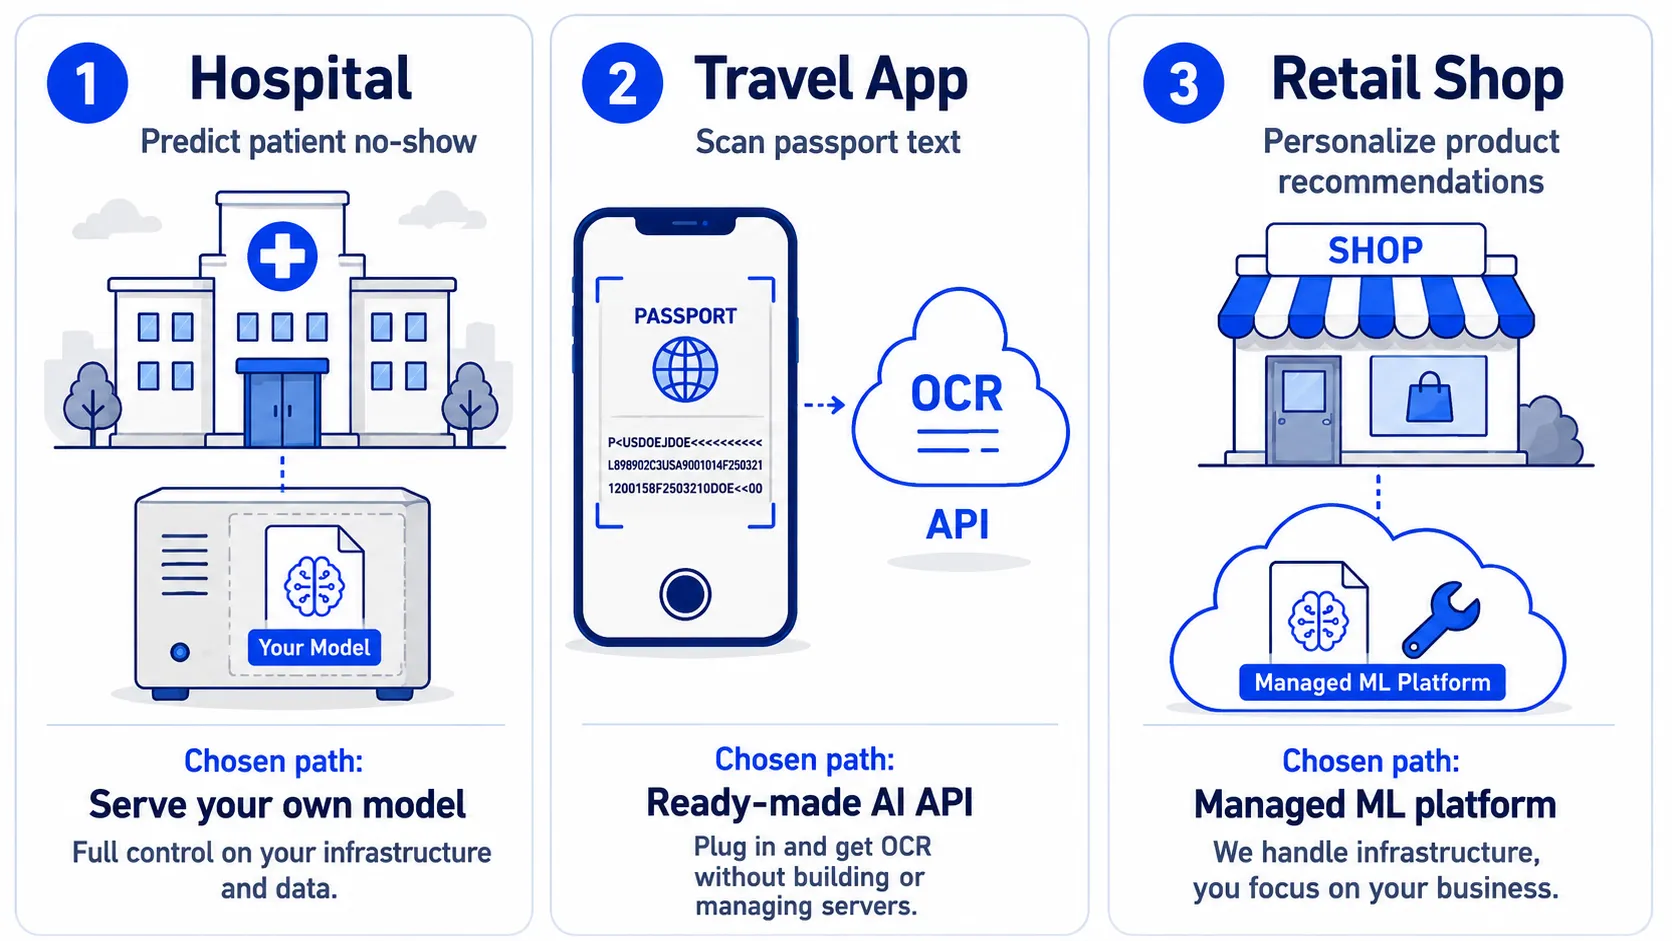
สิ่งสำคัญคือ ไม่มีเส้นทางไหนดีที่สุดสำหรับทุกโจทย์
เส้นทางที่ 1 ให้การควบคุมสูง แต่ต้องลงแรงมาก เส้นทางที่ 3 สะดวกและเริ่มได้เร็ว แต่ควบคุมได้น้อย ส่วนเส้นทางที่ 2 อยู่ตรงกลางระหว่างสองแบบ
และนี่คือเหตุผลที่ซีรีส์นี้จะพาไปลอง ครบทั้ง 3 เส้นทาง
โดยเราจะเริ่มจากการ Serve โมเดลด้วยตัวเองก่อน เพื่อให้เห็นว่าเบื้องหลังการเอา Machine Learning Model ขึ้น Production จริง ๆ ต้องจัดการอะไรบ้าง
เพราะถ้าเราไม่เคยรู้ว่า การ Build เองมีต้นทุนอะไรซ่อนอยู่บ้าง เราก็ยากที่จะตัดสินใจได้ว่าเมื่อไรควร Build และเมื่อไรควร Buy
การตัดสินใจ Build vs. Buy ที่ดี เริ่มจากการเข้าใจต้นทุนของทั้งสองฝั่ง
ตอนที่ 3: Serving Lifecycle — ทำไมมันถึงเป็นวงจร#
โมเดลที่อยู่ใน Notebook ยังเป็นเหมือน การทดลอง เราลอง Train ปรับ Parameter ดู Accuracy แล้วดูว่าผลลัพธ์ออกมาดีแค่ไหน
แต่ทันทีที่เราเอาโมเดลไปไว้หลัง API และเปิดให้ Application หรือผู้ใช้จริงเรียกใช้งาน สถานะของมันก็เปลี่ยนไป
มันไม่ได้เป็นแค่การทดลองอีกต่อไป แต่มันกลายเป็นผลิตภัณฑ์
และผลิตภัณฑ์จริงไม่ได้สร้างครั้งเดียวแล้วจบ แต่ต้องถูกดูแล ปรับปรุง และอัปเดตอยู่เรื่อย ๆ
Machine Learning Model ก็เหมือนกัน จึงเกิดสิ่งที่เรียกว่า Serving Lifecycle
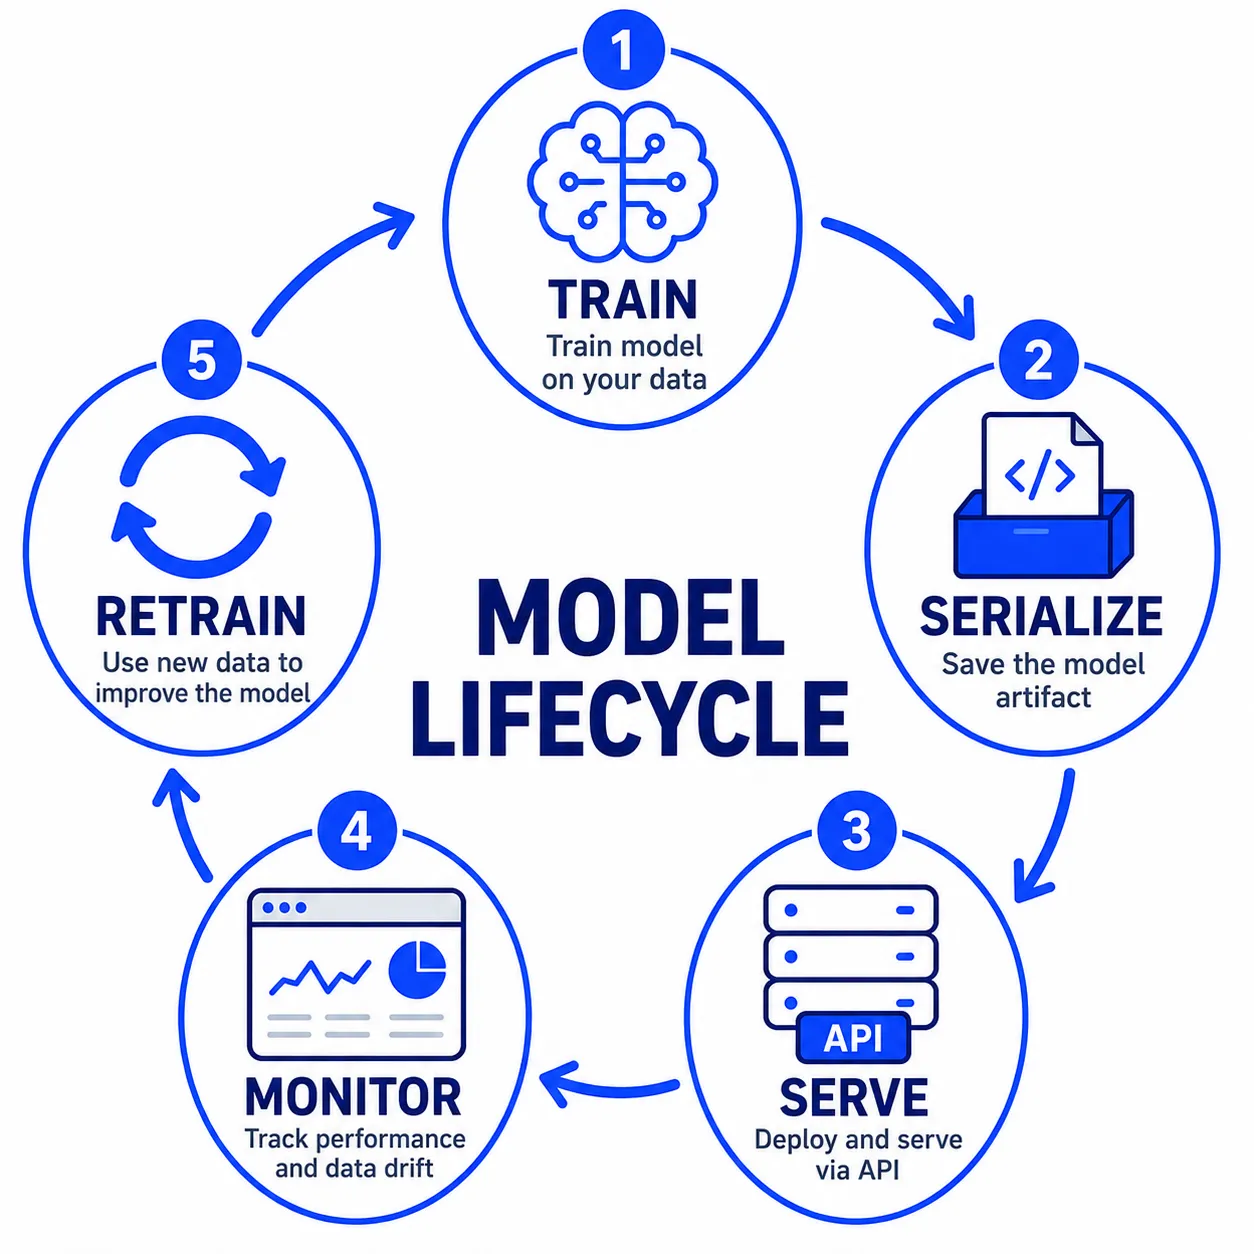
Lifecycle นี้แบ่งออกเป็น 5 ขั้นตอนหลัก
1. Train — สร้างโมเดลจากข้อมูล#
เริ่มจากนำข้อมูลในอดีตมาให้อัลกอริทึมเรียนรู้ เพื่อหารูปแบบบางอย่างจากข้อมูล แล้วได้โมเดลที่ Train เสร็จแล้วออกมา
ขั้นตอนนี้มักเกิดขึ้นแบบ Offline คือไม่ได้เกิดขึ้นตอนที่ผู้ใช้กำลังเรียกใช้งานระบบ
การ Train อาจใช้เวลาไม่กี่นาที หลายชั่วโมง หรืออาจนานกว่านั้น ขึ้นอยู่กับขนาดของข้อมูลและความซับซ้อนของโมเดล
ที่สำคัญคือ เราไม่ได้ Train โมเดลใหม่ทุกครั้งที่มี Request เข้ามา
Training เกิดเป็นครั้ง ๆ แต่ Prediction อาจเกิดขึ้นตลอดทั้งวัน
2. Serialize — เปลี่ยนโมเดลให้เป็นไฟล์#
เมื่อ Train เสร็จแล้ว เราต้องบันทึกโมเดลออกมาเป็นไฟล์ เช่น
model.joblib
ไฟล์นี้เรียกว่า Model Artifact
Artifact คือสิ่งที่เราจะนำไป Deploy บน Server จริง ๆ
จุดนี้สำคัญมาก เพราะใน Production เราไม่ได้เอา Notebook ไปเปิดแล้วกด Run ทุกครั้งที่ต้องการ Prediction
เรา Train ครั้งหนึ่ง → Save โมเดลออกมา → แล้วนำไฟล์นั้นไปใช้งาน
พูดง่าย ๆ คือ หลังจาก Train เสร็จแล้ว
Artifact ก็คือตัวแทนของโมเดลที่พร้อมนำไปใช้งาน
3. Serve — เปิดโมเดลให้คนอื่นเรียกใช้#
เมื่อมี Artifact แล้ว ขั้นต่อไปคือการ Serve
โปรแกรมบน Server จะเริ่มทำงาน โหลด model.joblib เข้า Memory แล้วเปิด API Endpoint เช่น
POST /predict
เมื่อ Application ส่งข้อมูลเข้ามา Server ก็ส่งข้อมูลนั้นให้โมเดลทำ Prediction แล้วส่งคำตอบกลับไป
ขั้นตอนนี้เรียกว่า Online Serving
ต่างจาก Training ที่อาจใช้เวลาหลายนาทีหรือหลายชั่วโมง Serving ต้องพร้อมทำงานตลอดเวลา และแต่ละ Request มักต้องตอบกลับให้เร็วที่สุด
ดังนั้นภาพง่าย ๆ คือ:
Training: ทำเป็นครั้ง ๆ และอาจใช้เวลานาน Serving: เปิดตลอด และต้องตอบให้เร็ว
4. Monitor — ดูว่าโมเดลยังทำงานดีอยู่หรือไม่#
Deploy สำเร็จไม่ได้แปลว่างานจบ
เราต้องคอยดูว่าโมเดลและระบบยังทำงานได้ดีหรือไม่ เช่น
- API ตอบเร็วแค่ไหน
- มี Error มากขึ้นหรือไม่
- Prediction ยังแม่นอยู่หรือเปล่า
- ข้อมูลที่เข้ามาวันนี้ยังมีลักษณะเหมือนข้อมูลที่ใช้ Train หรือไม่
ปัญหาคือ โมเดลไม่สามารถบอกเราเองได้ว่า “ตอนนี้ฉันเริ่มทำนายแย่แล้วนะ”
API อาจยังทำงานปกติ Server ไม่ล่ม ไม่มี Error แต่คุณภาพของ Prediction อาจกำลังลดลง
เราจึงต้องใช้ Monitoring เป็นตัวช่วยมองเห็นสิ่งเหล่านี้
5. Retrain — เมื่อโลกเปลี่ยน โมเดลก็ต้องเปลี่ยน#
ข้อมูลในโลกจริงไม่ได้อยู่นิ่ง
พฤติกรรมของลูกค้าเปลี่ยน สินค้าเปลี่ยน ภาษาเปลี่ยน รูปแบบ Fraud เปลี่ยน หรือแม้แต่สภาพเศรษฐกิจก็เปลี่ยนได้
โมเดลที่เรียนรู้จากข้อมูลเมื่อปีที่แล้ว จึงอาจไม่เหมาะกับข้อมูลในวันนี้
เมื่อ Monitoring บอกเราว่าคุณภาพของโมเดลเริ่มลดลง เราก็ต้องนำข้อมูลที่ใหม่ขึ้นมา Retrain
จากนั้นสร้าง Artifact เวอร์ชันใหม่ เช่น
model_v2.joblib
แล้ว Deploy เข้าไปแทนโมเดลเดิม
จากนั้นกระบวนการก็เริ่มต้นใหม่อีกครั้ง
Train → Serialize → Serve → Monitor → Retrain → แล้ววนกลับไปใหม่
นี่คือเหตุผลที่เราเรียกมันว่า Lifecycle
ลองเทียบกับร้านอาหาร#
ถ้ายังรู้สึกว่า Lifecycle นี้เป็นเรื่องเทคนิค ลองกลับไปใช้อุปมาร้านอาหารของเรา
| ขั้นตอน ML | เทียบกับร้านอาหาร |
|---|---|
| Train | ทดลองและเขียนสูตรอาหาร |
| Serialize | บันทึกสูตรลงในหนังสือทำอาหาร |
| Serve | ครัวใช้สูตรนั้นทำอาหารให้ลูกค้าทุกวัน |
| Monitor | ชิมอาหารและดู Feedback จากลูกค้า |
| Retrain | ปรับสูตรใหม่เมื่อวัตถุดิบหรือความชอบของลูกค้าเปลี่ยน |
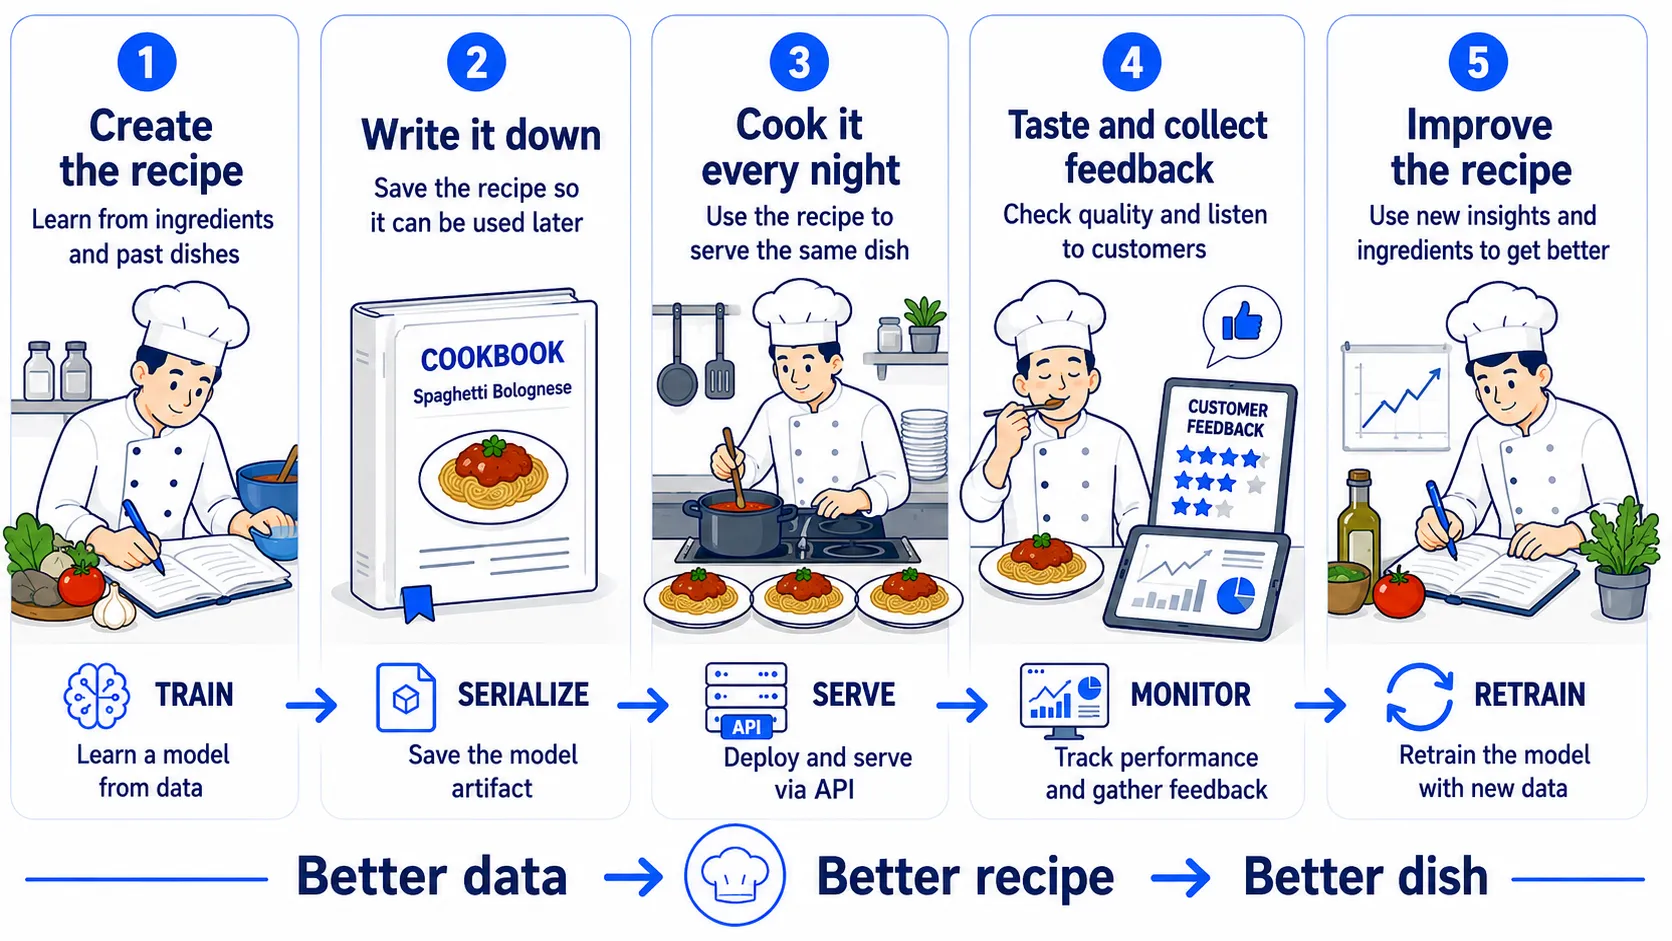
ประเด็นสำคัญคือ เชฟไม่จำเป็นต้องคิดสูตรใหม่ทุกครั้งที่มีลูกค้าสั่งอาหาร
เชฟคิดสูตรและบันทึกเอาไว้ก่อน จากนั้นครัวก็ใช้สูตรนั้นทำอาหารซ้ำ ๆ
Machine Learning ก็เหมือนกัน เราไม่ได้ Train โมเดลทุกครั้งที่มีคนเรียก API แต่เรา Train และสร้าง Artifact เอาไว้ก่อน แล้ว Server โหลด Artifact นั้นมาใช้ตอบ Prediction ซ้ำ ๆ
ความจริงที่สำคัญ: โมเดลสามารถ “เสื่อม” (Decay) ได้แบบเงียบ ๆ#
นี่คือเหตุผลสำคัญที่สุดว่าทำไม Lifecycle นี้ถึงหลีกเลี่ยงไม่ได้
โมเดลที่ Deploy แล้วสามารถค่อย ๆ แย่ลงโดยที่ระบบไม่ได้พัง
Software ทั่วไปมักพังแบบที่เราสังเกตเห็นได้ง่าย
Application Crash
Server Down
Database Connection Error
API ตอบ 500 Internal Server Error
เมื่อเกิดเหตุการณ์แบบนี้ ระบบ Monitoring ก็แจ้งเตือน แล้วทีมงานเข้าไปแก้ไข
แต่ Machine Learning มีปัญหาอีกแบบหนึ่ง
ระบบยังทำงาน แต่คำตอบเริ่มไม่ดีเหมือนเดิม
สมมติวันแรกที่ Deploy โมเดลมี Accuracy 94%
ผ่านไปหนึ่งปี พฤติกรรมของผู้ใช้และข้อมูลเปลี่ยนไป Accuracy อาจเหลือ 70%
แต่ API ยังคงตอบกลับว่า:
200 OK
Server ไม่ล่ม ไม่มี Exception ไม่มี Error Dashboard ทุกอย่างอาจยังเป็นสีเขียว
แต่ Prediction กำลังผิดมากขึ้นเรื่อย ๆ
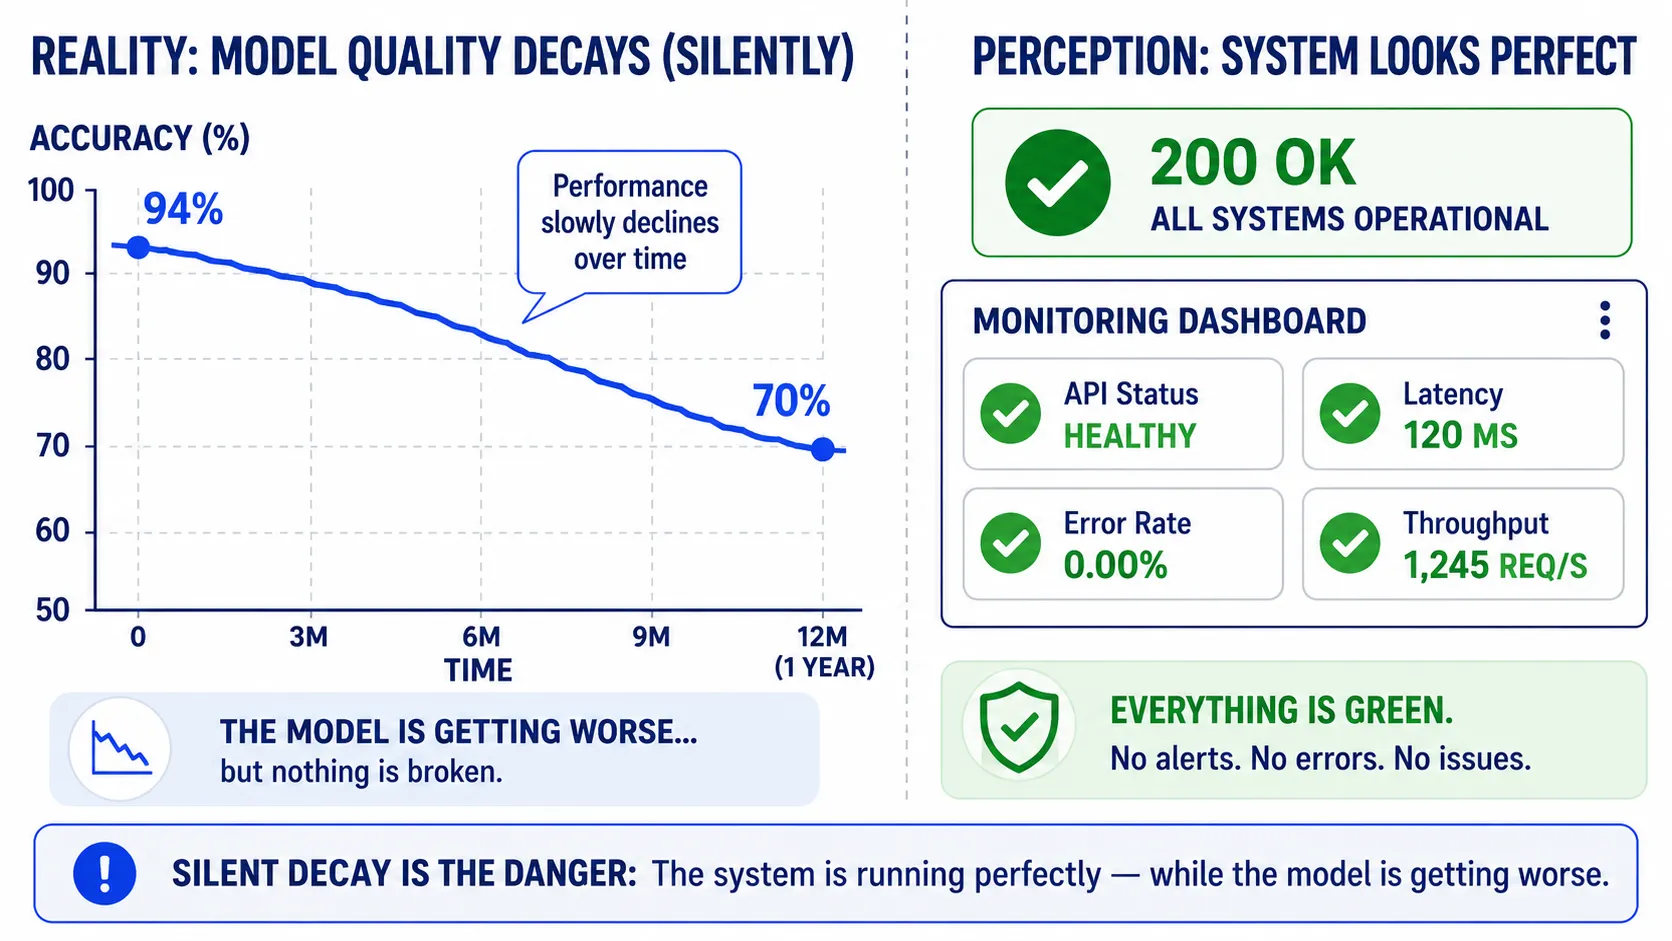
นี่คือสิ่งที่อันตรายของ Machine Learning ใน Production
เพราะระบบไม่ได้พังแบบเสียงดัง แต่มันสามารถ เสื่อมลงแบบเงียบ ๆ (Silent Decay)
และถ้าเราไม่ Monitor คุณภาพของโมเดล เราอาจไม่รู้เลยว่ามีปัญหา จนกระทั่งผู้ใช้เริ่มรู้สึกว่าระบบไม่น่าเชื่อถือ
ดังนั้น Monitoring ไม่ใช่ของเสริมที่ค่อยทำทีหลัง
มันเป็นส่วนหนึ่งของระบบ Machine Learning ตั้งแต่แรก
Demo สนใจว่าโมเดลทำนายได้หรือไม่ Production ต้องรู้ด้วยว่าโมเดลยังทำนายได้ดีอยู่หรือไม่
และนี่คือเส้นแบ่งสำคัญระหว่าง Machine Learning Demo กับ Machine Learning in Production
ตอนที่ 4: สองโปรแกรม หนึ่งโมเดล#
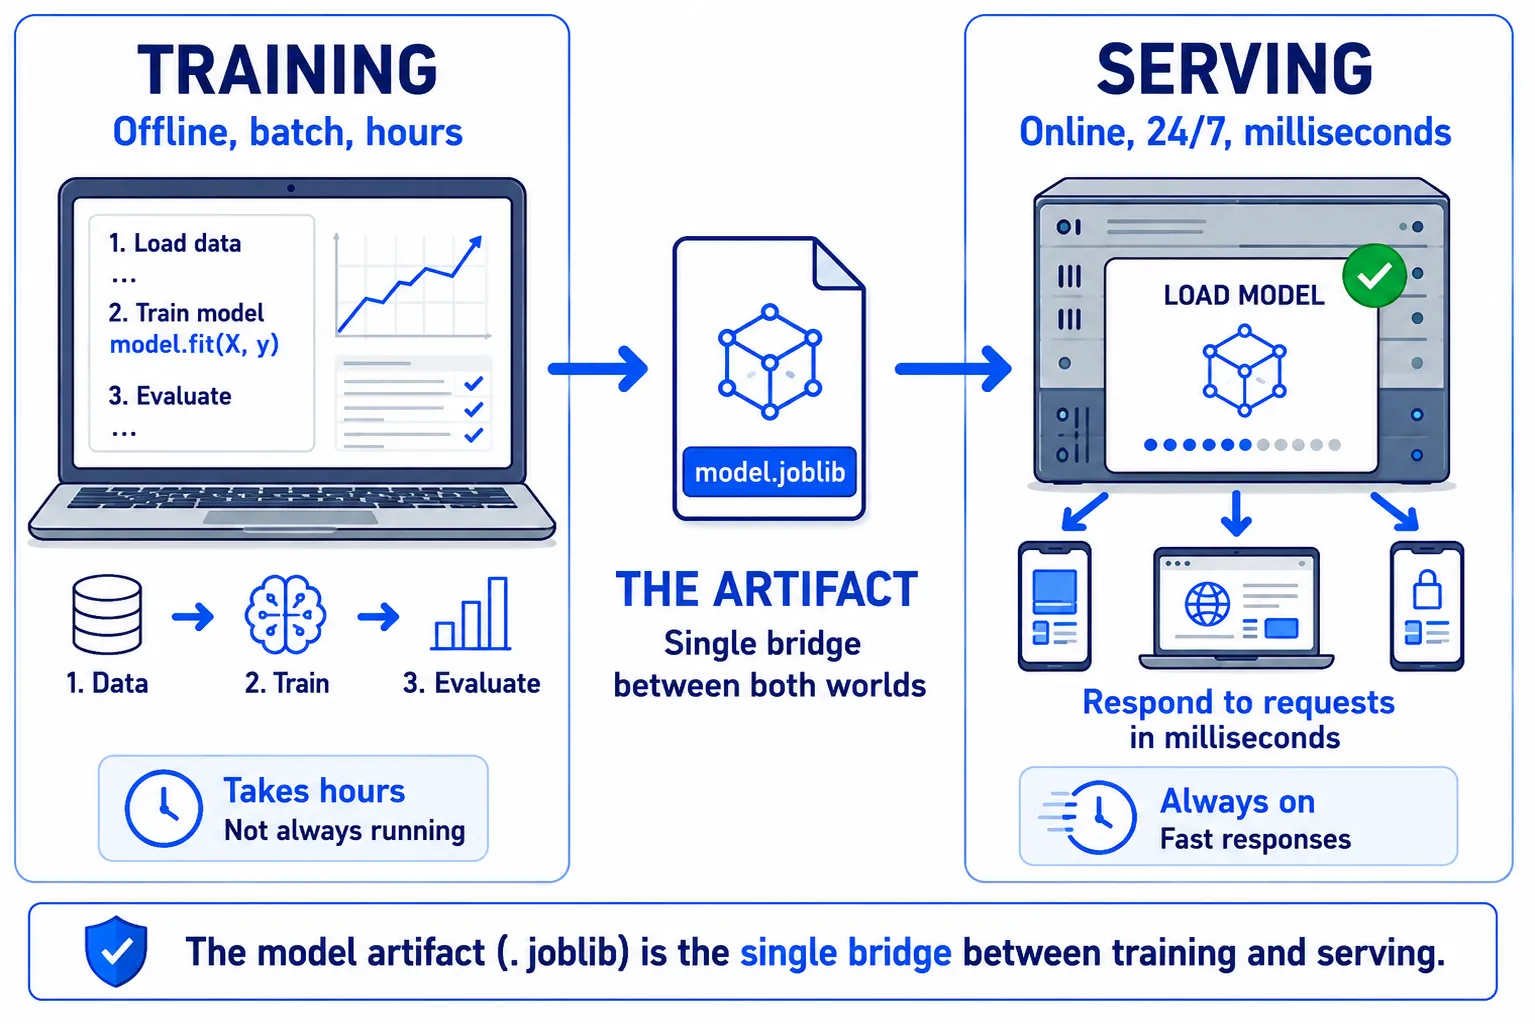
จาก Lifecycle ในตอนที่แล้ว มีแนวคิดหนึ่งที่สำคัญมากและควรแยกให้ออกตั้งแต่ต้น:
Training กับ Serving เป็นคนละโปรแกรมกัน
สองโปรแกรมนี้อาจรันคนละเวลา อยู่คนละเครื่อง หรือแม้แต่ถูกพัฒนาโดยคนละทีม สิ่งที่เชื่อมทั้งสองฝั่งเข้าด้วยกันคือไฟล์เพียงไฟล์เดียว — Model Artifact
ก่อนดูโค้ด มารู้จักตัวแปรสองตัวที่เราจะเจอก่อน
X_trainคือ ข้อมูลที่ใช้สำหรับ Training แต่ละแถวคือตัวอย่างหนึ่งเคส เช่น อีเมลหนึ่งฉบับ โดยอาจมีข้อมูลอย่างความยาวของข้อความ จำนวนลิงก์ หรือจำนวนคำบางประเภทy_trainคือ คำตอบที่ถูกต้องของแต่ละแถว หรือ Label เช่นspamและnot spam
พูดง่าย ๆ คือ:
X_train= โจทย์y_train= เฉลย
เมื่อมีทั้งโจทย์และเฉลย เราก็สามารถให้ Machine Learning Algorithm เรียนรู้ความสัมพันธ์ระหว่างสองอย่างนี้ได้
โปรแกรมที่ 1: Training#
# ---- โปรแกรมที่ 1: TRAINING ----
# รันเป็นครั้ง ๆ แบบ offline
# อาจใช้เวลาตั้งแต่นาทีไปจนถึงหลายชั่วโมง

from sklearn.ensemble import RandomForestClassifier
import joblib

model = RandomForestClassifier().fit(X_train, y_train)
joblib.dump(model, "model.joblib")โปรแกรมนี้มีหน้าที่หลักสองอย่างคือ Train โมเดล และ Save โมเดลออกมาเป็นไฟล์
โปรแกรมที่ 2: Serving#
# ---- โปรแกรมที่ 2: SERVING ----
# รันบน Server เปิดตลอด และคอยตอบ Request

import joblib

model = joblib.load("model.joblib")
prediction = model.predict(features)สังเกตว่าโปรแกรมนี้สั้นมาก และที่สำคัญคือ ไม่มี .fit()
Server ไม่ได้ Train โมเดลใหม่ทุกครั้งที่มี Request เข้ามา แต่โหลดสิ่งที่เรียนรู้ไว้แล้วจาก model.joblib แล้วใช้มันสำหรับ Prediction
ลองไล่ดูทีละคำสั่ง
-
fit(X_train, y_train)ความหมายประมาณว่า “นี่คือข้อมูลในอดีตพร้อมเฉลย ลองเรียนรู้ Pattern จากข้อมูลเหล่านี้ให้หน่อย” -
joblib.dump(model, "model.joblib")คือ “เอาสิ่งที่โมเดลเรียนรู้แล้ว บันทึกออกมาเป็นไฟล์” ไฟล์model.joblibนี้คือ Model Artifact -
joblib.load("model.joblib")ฝั่ง Server จะอ่าน Artifact นี้ตอนโปรแกรมเริ่มทำงาน โดยไม่จำเป็นต้องกลับไป Train ใหม่ และไม่จำเป็นต้องมี Training Dataset อยู่บน Server -
model.predict(features)คือ “นี่คือข้อมูลใหม่ที่ไม่เคยเห็นมาก่อน ลองทำนายคำตอบให้หน่อย”
ดังนั้น Flow ทั้งหมดจึงเป็นประมาณนี้:
Training Data → Train →
model.joblib→ Server → Prediction
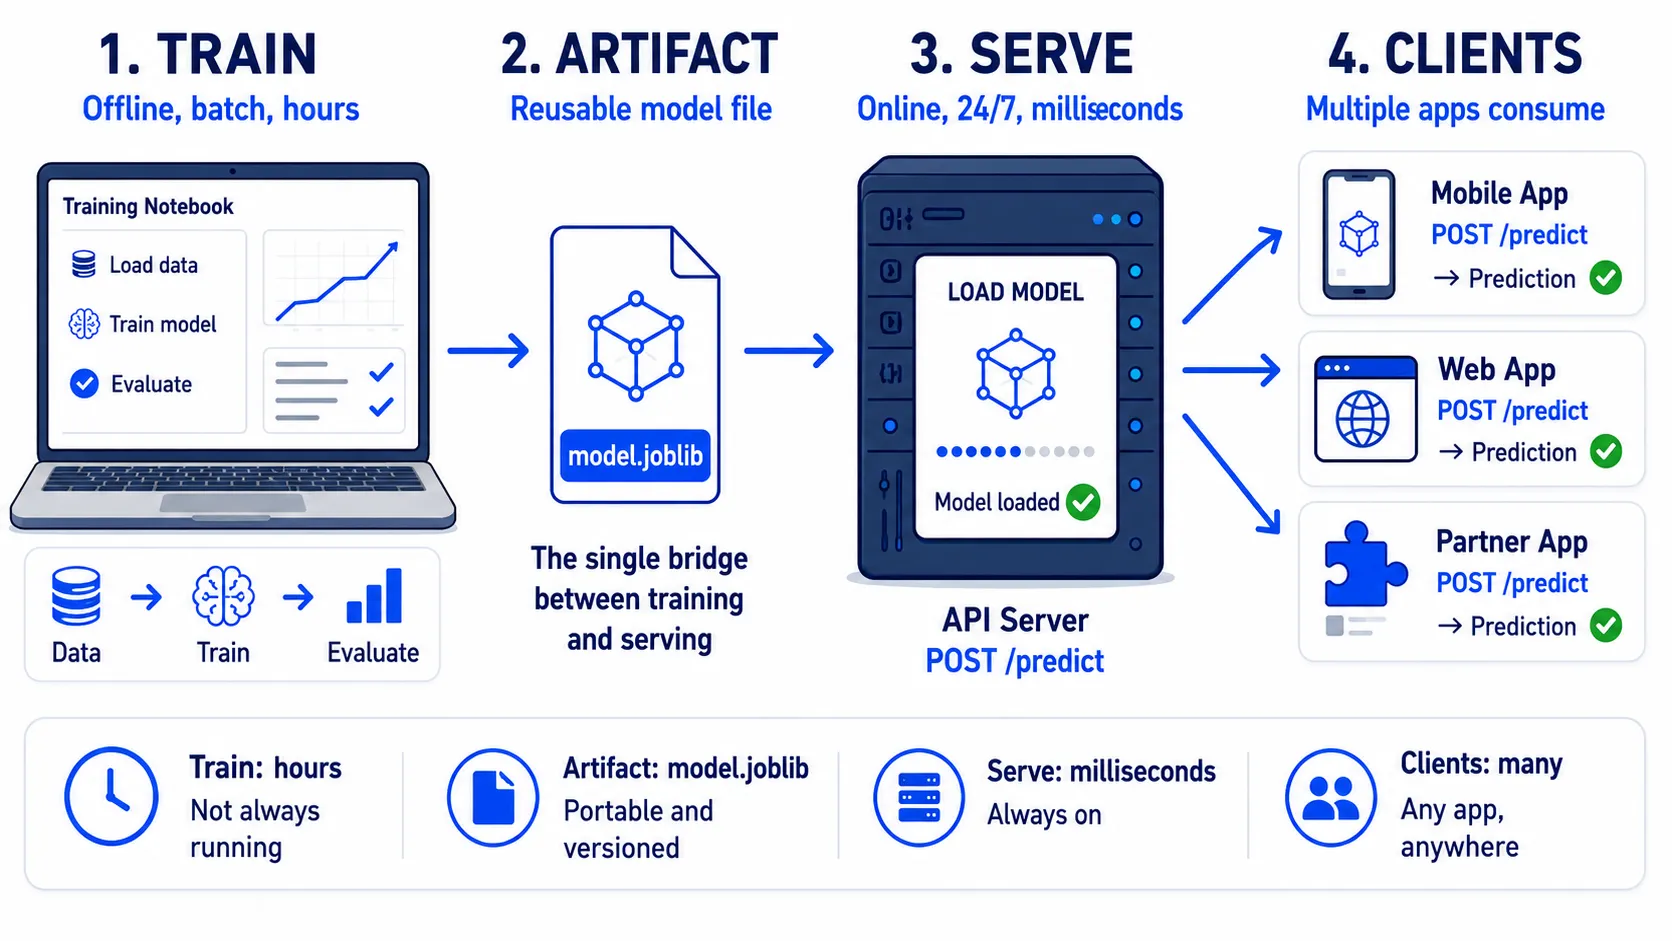
สองโปรแกรมนี้ใช้ชีวิตต่างกันมาก#
แม้ Training และ Serving จะใช้โมเดลเดียวกัน แต่ลักษณะการทำงานแทบจะตรงข้ามกัน
| โปรแกรม Training | โปรแกรม Serving | |
|---|---|---|
| รันบ่อยแค่ไหน | เป็นครั้ง ๆ เช่น ทุกสัปดาห์หรือทุกเดือน | เปิดตลอด 24/7 |
| ยอมให้ใช้เวลานานแค่ไหน | หลายนาทีหรือหลายชั่วโมงก็ได้ | ควรตอบในระดับมิลลิวินาทีหรือวินาที |
| เห็นข้อมูลแบบไหน | เห็น Training Dataset จำนวนมาก | เห็นข้อมูลใหม่ทีละ Request หรือ Batch |
| ลักษณะค่าใช้จ่าย | Compute ตอน Train | Compute จากการให้บริการอย่างต่อเนื่อง |
| คนที่รับผิดชอบ | มักอยู่ฝั่ง Data Science / ML | มักทำร่วมกับ Software / ML / Platform Engineering |
Training อาจเกิดขึ้นบน Laptop หรือเครื่อง GPU ขนาดใหญ่ แล้วจบการทำงานไป
ส่วน Serving อาจอยู่บน Server อีกประเทศหนึ่ง เปิดทำงานตลอด 24 ชั่วโมง และรับ Request จาก Application หลายพันครั้งต่อวัน
สองโปรแกรมนี้ ไม่จำเป็นต้องรู้จักกันเลย
ฝั่ง Serving ไม่ต้องมี X_train
ไม่ต้องมี y_train
และไม่ต้องรู้ด้วยซ้ำว่าโมเดลใช้เวลา Train ไปกี่ชั่วโมง
สิ่งเดียวที่มันต้องการคือ:
Model Artifact ที่ถูกต้อง
นั่นทำให้ model.joblib ดูเหมือนเป็นเพียงไฟล์เล็ก ๆ แต่ในระบบจริงมันสำคัญมาก เพราะมันคือ สะพานเชื่อมระหว่างโลกของ Training กับโลกของ Production
และตรงรอยต่อนี้เอง เป็นจุดที่ปัญหา Machine Learning ใน Production จำนวนมากมักเกิดขึ้น
เช่น โมเดลถูก Train ด้วย Library คนละ Version กับ Server, ขั้นตอนเตรียมข้อมูลตอน Training ไม่เหมือนตอน Serving หรือมีการ Deploy Artifact ผิด Version
ตัว Server อาจยังทำงานปกติ API ยังตอบ 200 OK แต่ Prediction ที่ออกมากลับผิดไปจากที่ควรจะเป็น
Training กับ Serving อาจไม่เคยเจอกัน แต่ต้องเข้าใจข้อมูลแบบเดียวกัน
ประโยคนี้สำคัญมาก เพราะในตอนถัดไปเราจะเจอกับปัญหาคลาสสิกของ ML Production ที่เกิดจากรอยต่อนี้โดยตรง
ตอนที่ 5: ทำไมต้อง Serve โมเดลด้วย?#
ถึงตรงนี้อาจมีคำถามง่าย ๆ แต่สำคัญมากว่า:
“ทำไมต้องทำ API ให้ยุ่งยากด้วย? Train โมเดลใน Notebook แล้ว Predict ออกมาเป็น Excel ส่งให้คนใช้ไม่ได้หรือ?”
คำตอบคือ ได้ — และสำหรับบางงาน นั่นอาจเป็นวิธีที่เหมาะสมที่สุดด้วย
ถ้าเราต้องการ Forecast ยอดขายเดือนละครั้ง การรัน Batch Prediction แล้วส่งไฟล์ให้ทีมงานอาจเพียงพอ
แต่เมื่อ Prediction ต้องกลายเป็นส่วนหนึ่งของ Application และถูกเรียกใช้งานตลอดเวลา เราจึงต้องเปลี่ยนโมเดลให้กลายเป็น Service
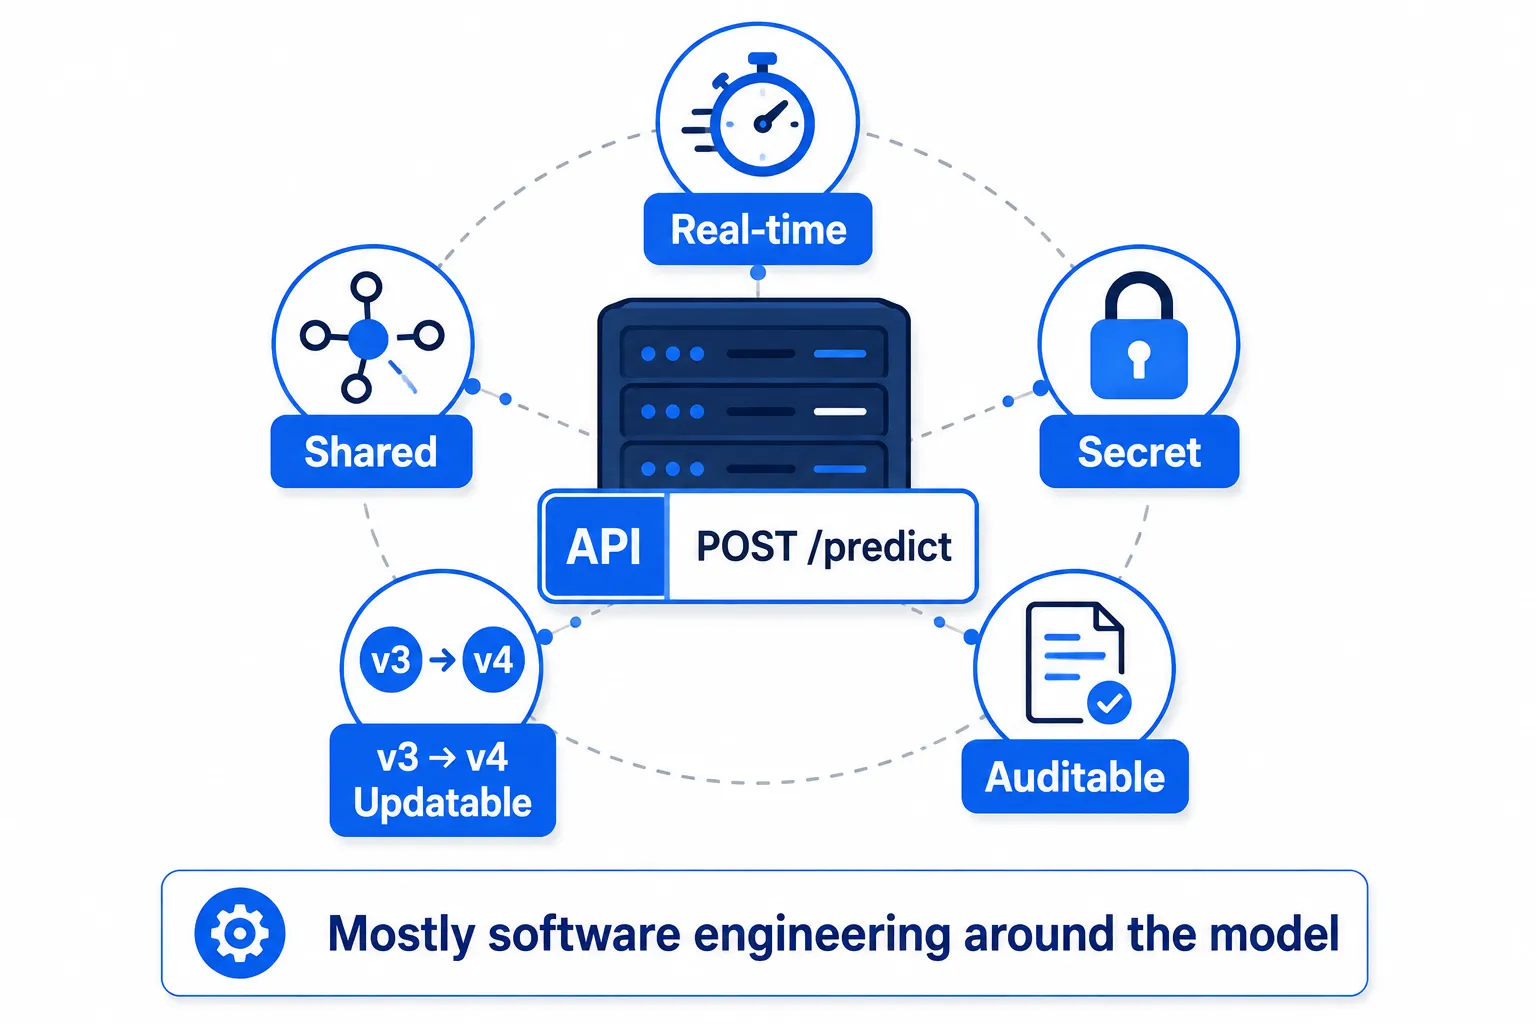
เหตุผลหลักมีอยู่ 5 ข้อ
1. Real-time — บางคำตอบรอไม่ได้#
บางระบบต้องการ Prediction ทันที
เช่นระบบ Fraud Detection ในขั้นตอนชำระเงิน ไม่สามารถรอให้ Data Scientist เปิด Notebook แล้วรัน Prediction ได้
Flow ต้องเกิดประมาณนี้:
Transaction → Model → Decision → Approve / Reject
ทั้งหมดต้องเกิดขึ้นเร็วพอที่ผู้ใช้แทบไม่รู้สึกว่ามี Machine Learning ทำงานอยู่เบื้องหลัง
เมื่อ Prediction เป็น API ระบบอื่นจึงสามารถเรียกใช้ได้ทันที
2. Shared — โมเดลเดียว ใช้ได้หลายระบบ#
สมมติบริษัทมี Fraud Model อยู่หนึ่งตัว
ถ้า Serve เป็น API เราสามารถให้หลายระบบเรียกโมเดลเดียวกันได้ เช่น:
- Website
- Mobile Application
- ระบบของ Partner
- ระบบหลังบ้าน
ทุกระบบเรียก Endpoint เดียวกัน เช่น:
POST /predict
ข้อดีคือ Logic ของ Machine Learning อยู่ในที่เดียว
ถ้าเราแก้ Bug หรือ Deploy Model Version ใหม่ ทุก Application ก็ได้ประโยชน์ทันที โดยไม่ต้องเอาโมเดลไปฝังแยกไว้ในทุกระบบ
3. Secret — ไม่จำเป็นต้องแจกโมเดลให้คนอื่น#
Model Artifact อาจถือเป็น Intellectual Property (IP) ที่สำคัญขององค์กร
ถ้าเราส่ง model.joblib ให้ทุก Application เราก็กำลังแจกตัวโมเดลออกไปด้วย
แต่ถ้าโมเดลอยู่หลัง API ผู้ใช้จะเห็นเพียง:
Input → Prediction
เขาไม่จำเป็นต้องเห็น Model Artifact, Parameters หรือรายละเอียดภายในของโมเดล
แนวคิดเดียวกันนี้เกิดขึ้นตอนเราใช้ AI API ของบริษัทอื่น
เราเรียกใช้ความสามารถของโมเดลได้ แต่ไม่ได้เป็นเจ้าของโมเดลนั้น
และนี่ก็พาเรากลับไปสู่ Trade-off เรื่อง Build vs. Buy
ถ้าเราใช้ API ของคนอื่น เราเริ่มได้เร็ว แต่ก็ต้องอยู่ภายใต้ราคา ข้อจำกัด และเงื่อนไขของผู้ให้บริการ
4. Updatable — เปลี่ยนโมเดลได้โดยไม่ต้องเปลี่ยนทุก Application#
สมมติ Production กำลังใช้:
model_v3.joblib
เรา Retrain แล้วได้:
model_v4.joblib
ถ้า Model ถูก Serve ผ่าน API เราสามารถ Deploy Version ใหม่ที่ฝั่ง Server โดยที่ Application ที่เรียกใช้งานอาจไม่ต้องแก้อะไรเลย
มันยังเรียก:
POST /predict
เหมือนเดิม
แต่เบื้องหลังเปลี่ยนจาก v3 เป็น v4 แล้ว
และถ้า v4 มีปัญหา เราก็สามารถ Rollback กลับไปใช้ v3 ได้
นี่คือเหตุผลที่ Model Versioning สำคัญมาก
Artifact ที่มี Version คือปุ่ม Undo ของระบบ Machine Learning
5. Auditable — ย้อนกลับไปตอบได้ว่าเกิดอะไรขึ้น#
ในระบบจริง บางครั้งเราไม่ได้ต้องการแค่ Prediction
เราต้องสามารถย้อนกลับไปตอบได้ด้วยว่า:
“ตอนนั้นระบบใช้โมเดล Version ไหน?”
“Input ที่เข้ามาคืออะไร?”
“โมเดลตอบอะไรกลับไป?”
โดยเฉพาะระบบที่มีผลกระทบสูง เช่น การเงิน ประกัน หรือระบบสนับสนุนการตัดสินใจ
Request Logging ที่ดีอาจเก็บข้อมูลอย่าง:
timestamp
request_id
model_version
input_features
prediction
confidence
latency
เมื่อเกิดปัญหา เราจึงสามารถย้อนกลับไปตรวจสอบได้ว่า Prediction นั้นเกิดจากอะไรและใช้โมเดล Version ใด
Notebook เพียงอย่างเดียวทำสิ่งนี้ได้ยากเมื่อมี Request หลายล้านครั้งจากผู้ใช้จริง
สังเกตอะไรบางอย่างไหม?#
ลองกลับไปดูเหตุผลทั้งห้าข้ออีกครั้ง:
Real-time Shared Secret Updatable Auditable
ไม่มีข้อไหนเป็นคุณสมบัติของ Machine Learning Algorithm โดยตรงเลย
Random Forest ไม่ได้ทำให้ระบบ Auditable
Neural Network ไม่ได้ทำให้ระบบ Shared
Logistic Regression ไม่ได้ทำให้เรา Rollback ได้
สิ่งเหล่านี้เกิดจาก Software Engineering และ Infrastructure ที่เราสร้างขึ้นรอบโมเดล
และนี่คือแนวคิดหลักของทั้งซีรีส์:
AI as a Service ไม่ได้มีแค่ AI — ส่วนใหญ่คือ Software Engineering ที่ทำให้ AI กลายเป็น Service ที่ใช้งานจริงได้
การ Train โมเดลจึงเป็นเพียงจุดเริ่มต้น
งานที่ทำให้โมเดลนั้น พร้อมใช้ เชื่อถือได้ อัปเดตได้ ตรวจสอบได้ และอยู่รอดใน Production ต่างหากที่ทำให้ Machine Learning กลายเป็นผลิตภัณฑ์จริง
สรุป#
ถ้าจะเก็บประโยคเดียวจากบทความนี้ เก็บอันนี้:
โมเดลที่ fit แล้วคือ artifact การ serving อย่างมีความรับผิดชอบ — validation, monitoring, versioning — ต่างหากคืองานจริง
และนี่คือแผนที่ สำหรับอ้างอิง:
- บันได: on-premise → IaaS → PaaS → SaaS → AIaaS — แต่ละขั้นเช่า stack ให้คุณมากขึ้น และริดการควบคุมออกไปมากขึ้น
- สามเส้นทาง: VM ของตัวเอง / แพลตฟอร์ม managed / API สำเร็จรูปของใครสักคน — เลือกจากข้อมูลคุณแปลกใหม่แค่ไหน
- วงจร: train → serialize → serve → monitor → retrain — ตลอดไป เพราะโมเดลเน่าแบบเงียบ ๆ
- ศัพท์: artifacts, feature schemas, train/serve skew, drift และ metrics ที่สอดคล้องกับต้นทุน
แบบฝึกหัด#
ค้นหา ML/prediction API จริงที่เปิดเผยต่อสาธารณะหนึ่งตัว ตัวเลือกที่ดี: Google Cloud Vision, Azure Translator, Hugging Face inference endpoint, หรือ API พยากรณ์อากาศ/คะแนน fraud (ยังไม่เอา chatbot API นะ — จะมาทีหลังในซีรีส์)
ตอบคำถามห้าข้อเกี่ยวกับมัน:
- มันทำนายหรือจัดหมวดอะไร — อะไรเข้า อะไรออก?
- ราคาเป็นยังไง — ต่อ call, ต่อ record, มี free tier ไหม?
- Rate limit เท่าไหร่ และ authenticate ยังไง?
- ใครใช้มัน ใช้ทำอะไร? หาผลิตภัณฑ์หรือ case study จริงหนึ่งอัน
- อะไรที่ทำให้คุณแปลกใจ?
ประเด็นไม่ใช่รายงานที่เขียนขึ้น ประเด็นคือว่าจากนี้ไป คุณจะมองทุก feature AI ที่คุณใช้เป็น API ที่มีหน้าราคาติดอยู่